一句话总结
2026 年 9 月 22 日,小米开源 MiMo-V2.6 系列:MiMo-V2.6-Pro 在 Artificial Analysis 智能指数上拿到 46.32 分,官方称已超过 Kimi K3 与 Qwen3.8 Max,成为迄今最强开源模型,而 API 定价与上一代 V2.5 完全持平。真正少见的是过程——他们把 RL 训练全程直播:两个模型各跑 30 步、各约 75 万条轨迹、成本约 85.4 万 / 262 万美元(合计约 347 万),并把 GPU OOM、网络中断、数据集坏 pattern、节点 VRAM 故障这些通常只出现在内部周报里的内容,公开写进了训练面板的 notices 里。
数据来源:小米 MiMo 官方发布博客《Introducing MiMo-V2.6 series》(mimo.xiaomi.com/mimo-v2-6,2026-09-22)、官方 实时 RL 训练面板(mimo.xiaomi.com/rl/)、Artificial Analysis 智能指数 v4.3(2026 年 9 月)、Hacker News 讨论帖(496 分、约 259 条评论)、XiaomiMiMo 官方 GitHub 组织页。文中配图来源已逐张标注。
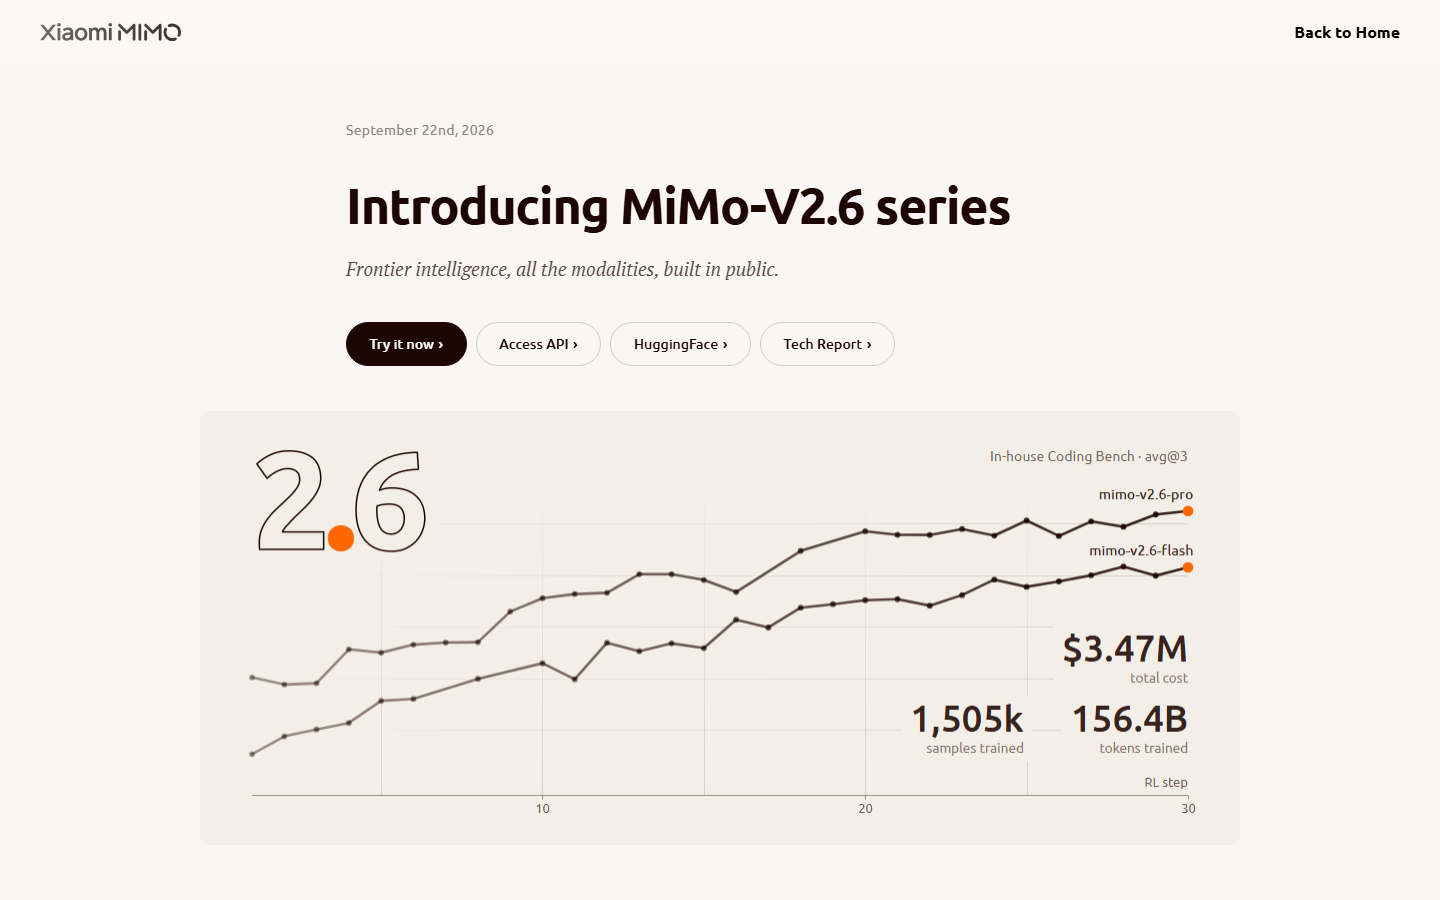
上图截自小米 MiMo 官方发布页。右侧数字是这次训练的账单:1,505k 采样、156.4B token、347.4 万美元总成本、30 个 RL step。注意左上角的「2.6」是页面自己的视觉主题,不是迭代次数。
这次发布的是什么
官方这一版放出的不是一个模型,而是一个系列三档,且定位写得非常直接:
| 模型 | 官方定位 |
|---|---|
| MiMo-V2.6-Pro | 小米迄今最强模型,AA 智能指数 46.32,最强开源模型 |
| MiMo-V2.6-Flash | 在智能、效率、成本之间取最优平衡 |
| MiMo-V2.6-Pro-UltraSpeed | 同等质量下输出速度最高提升 20 倍,给对响应时间极敏感的工作流 |
两个基础型号都是**原生全模态(natively omnimodal)**模型——不是”文本模型外挂一个视觉编码器”,而是原生设计成多模态。定价表则更有意思:
| 模型 | 输入(缓存命中) | 输入(缓存未命中) | 输出 |
|---|---|---|---|
| MiMo-V2.6-Flash | $0.0028 | $0.14 | $0.28 |
| MiMo-V2.6-Pro | $0.0036 | $0.435 | $0.87 |
| MiMo-V2.6-Pro-UltraSpeed | $0.036 | $4.35 | $8.70 |
单位:美元 / 百万 token。缓存写入近期免费。官方原话是「与 V2.5 系列价格保持一致」——能力涨了,价格没动。
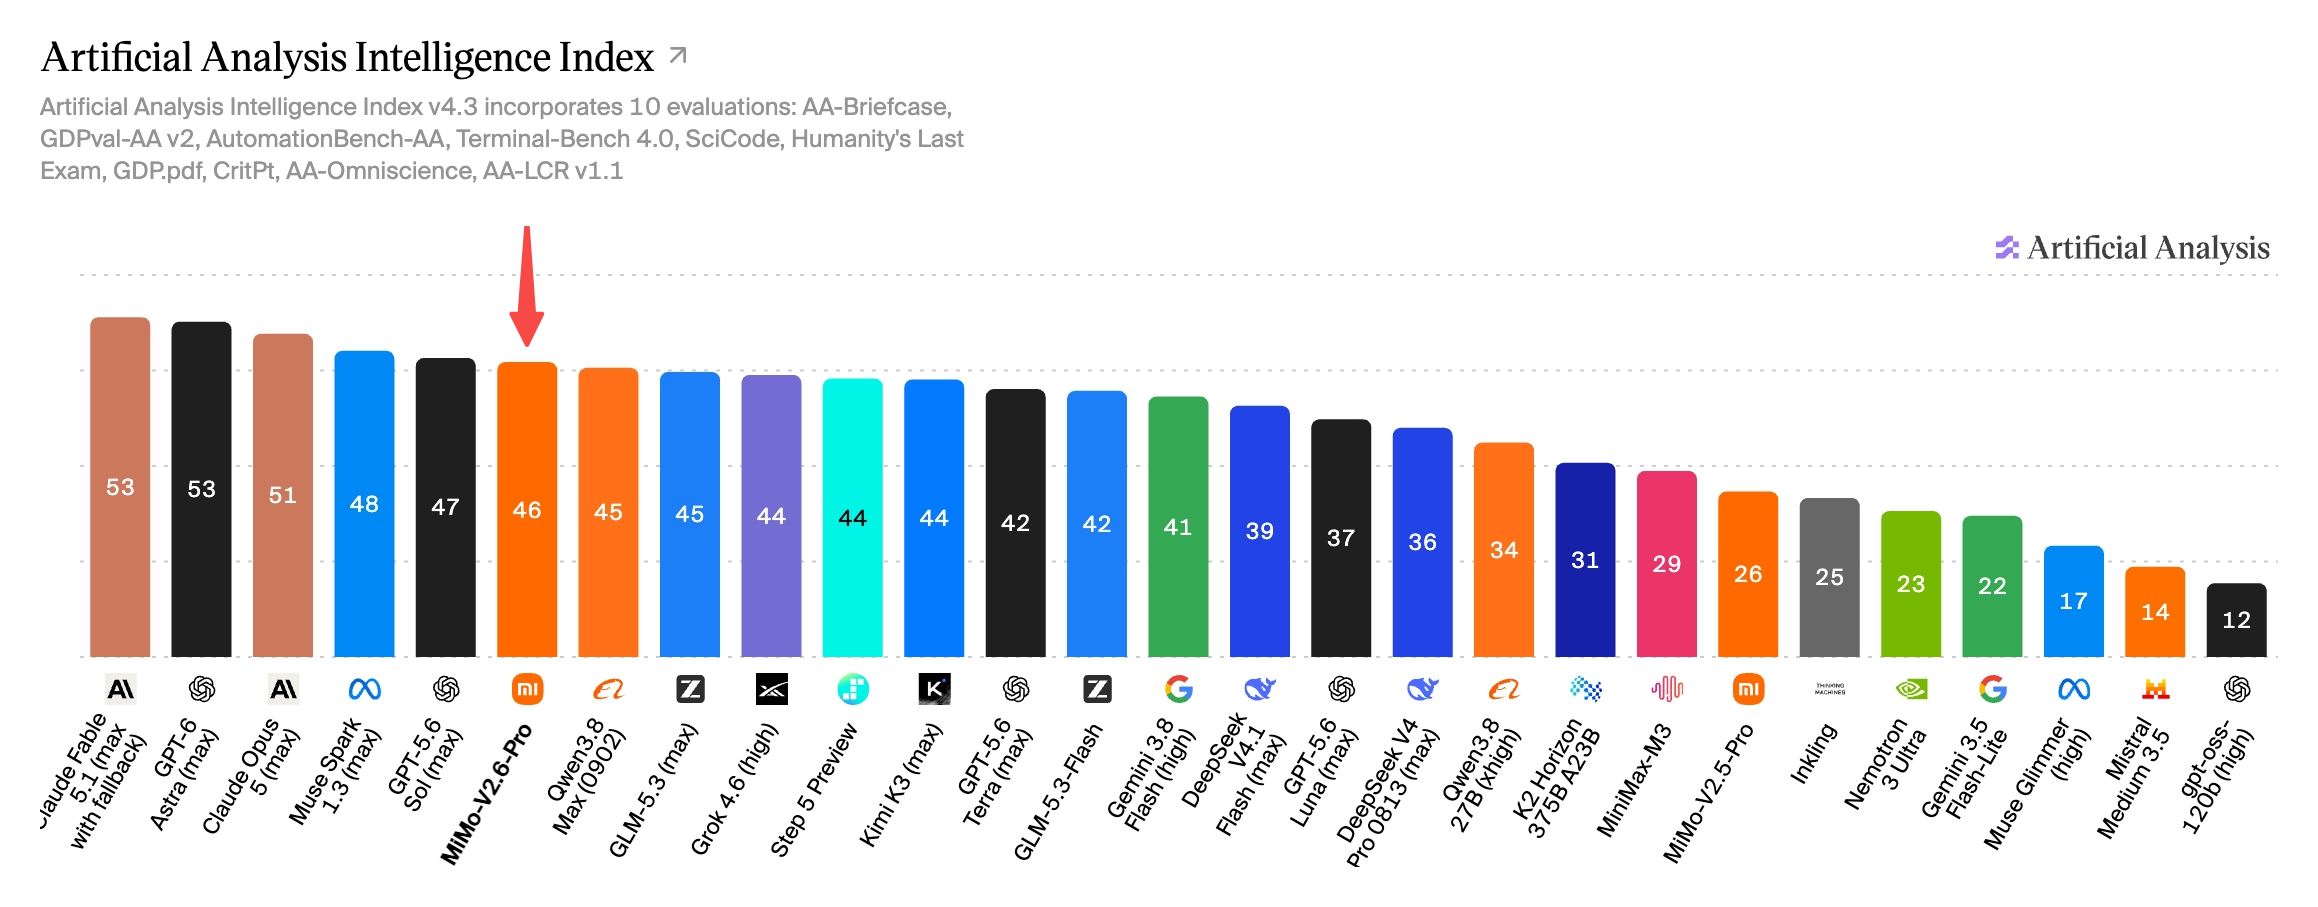
上图来自小米 MiMo 官方发布页(红线箭头是官方自己标的)。横轴从左到右是智能指数降序:Claude Fable 5(with fallback)53、Gemini 3.6(max)53、Grok 4.7(max)51、Claude Opus 5(max)48、GPT-5.6(max)47,然后是橙色的 MiMo-V2.6-Pro 46。它前面只剩闭源模型。
为什么这次的重点不是”又一个开源模型”
过去半年开源模型发布已经非常密集,“又一个刷榜”很难构成新闻。MiMo-V2.6 值得单独写,是因为它同时做了三件不太一样的事:
- 把 RL 训练成本打成了公开数字——精确到 85.4 万 / 262 万美元,而不是”我们用了大量算力”。
- 把训练过程本身做成了公开产品——训练时开直播面板,跑完面板还在,连故障记录都留着。
- 把”训练环境 + RL 代码”也算进开源清单——不只是给权重。
第 2 点和第 3 点合起来,才是官方那句 “built in public”(公开构建)的实际含义。
RL 是怎么跑的:30 步、75 万条轨迹、347 万美元
官方公布的训练账本很干净:不到 6 天,MiMo-V2.6-Flash 与 MiMo-V2.6-Pro 各自完成 30 个 RL step、各约 75 万条轨迹,成本分别约 85.4 万美元和 262 万美元。
效果则分两层:
- 训练任务自身的平均通过率相对提升 25%(Flash)与 12%(Pro);
- 留出(held-out)的长程软件工程基准 DeepSWE v1.1 上,提升了约 17 分(48.8 → 65.68)与约 14 分(58.4 → 72.57)。
官方对这两组数字的解读值得抄下来:RL 表现出样本效率、整段训练持续在涨(没有平台期)、并且泛化到了训练分布之外。第二句才是关键——如果只是训练集涨、留出集不涨,那就是过拟合;留出集也涨,才叫”能力扩展”。
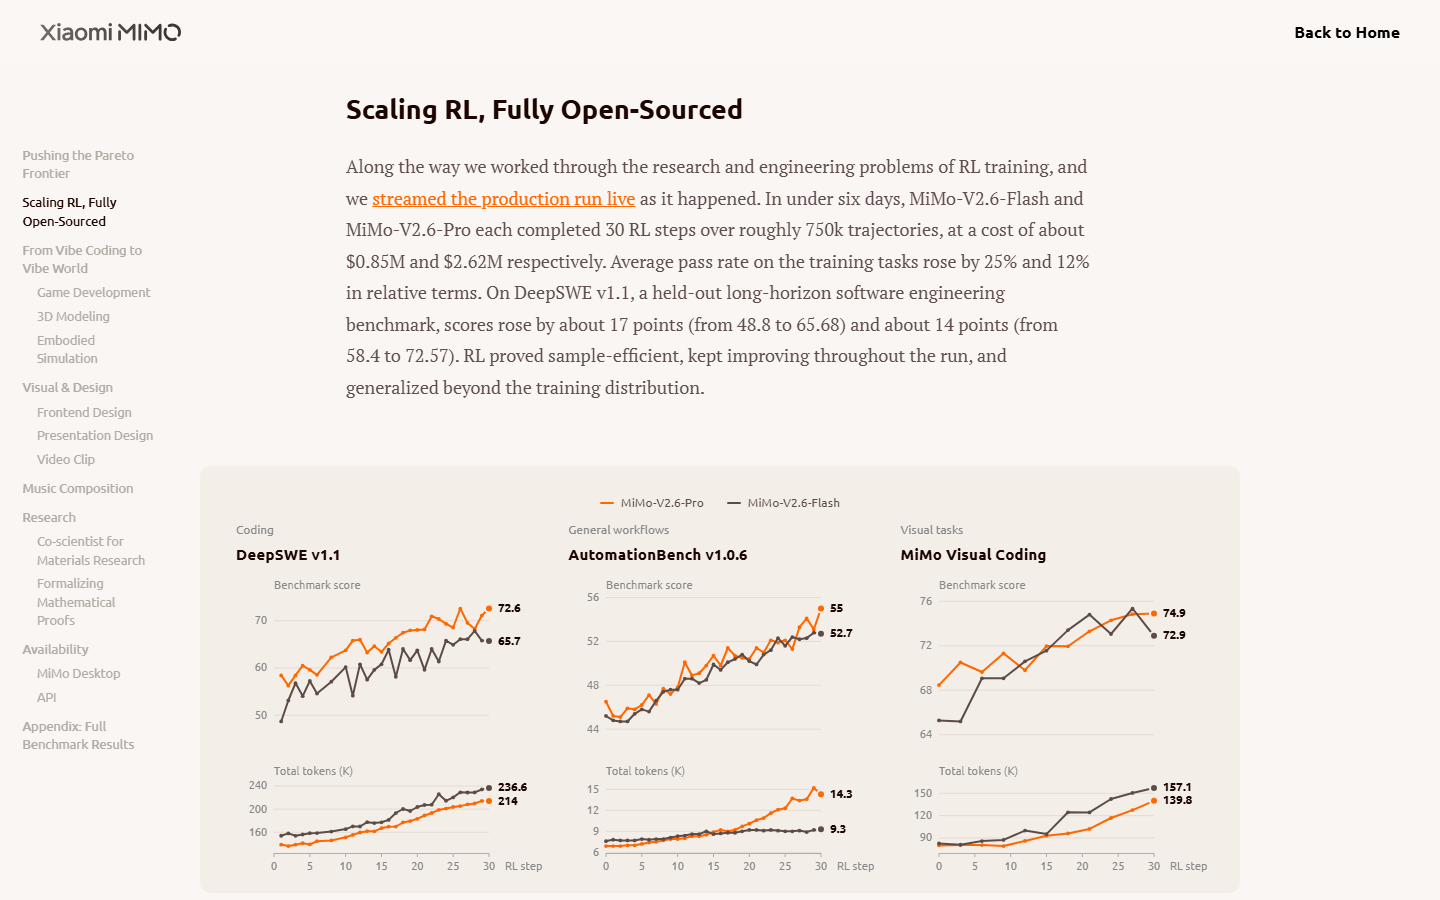
上图截自官方发布页 RL 章节。上排是基准分,下排是同一步的总 token 消耗。可以清楚看到 MiMo-V2.6-Pro(橙)与 Flash(黑)在 DeepSWE v1.1 上分别收在 72.6 / 65.7,且整条曲线仍在上升——这是官方”没有平台期”说法的依据。
三条扩展轴,和一句很实在的 grader 说明
官方把 RL 算力的扩展拆成三条:
① 更大批次与更高吞吐。 全异步架构上的大 batch,每次更新 1,568 个样本,训练上下文最长 1M,每步 3.5–3.7B token。
② 更多任务与更丰富的环境。 一套跨编码、通用 Agent、视觉、网络安全的多任务训练集,在多个 harness 之间混合——让一种能力的提升去带动另一种。
③ 更多 grader 算力。 这一条最容易被忽略,但官方写得很明确:组内相对比较(relative comparison within each group)给长程 RL 任务带来了更精确、更多样的奖励信号,同时把模型推向更短的路径与更少的 token。
第 ③ 点里”更少的 token”这半句,值得单独划出来——它正是下面那篇 Grok 4.7 分析的反面。同样是涨分,一条路是让模型想得更多,另一条路是让模型绕得少。
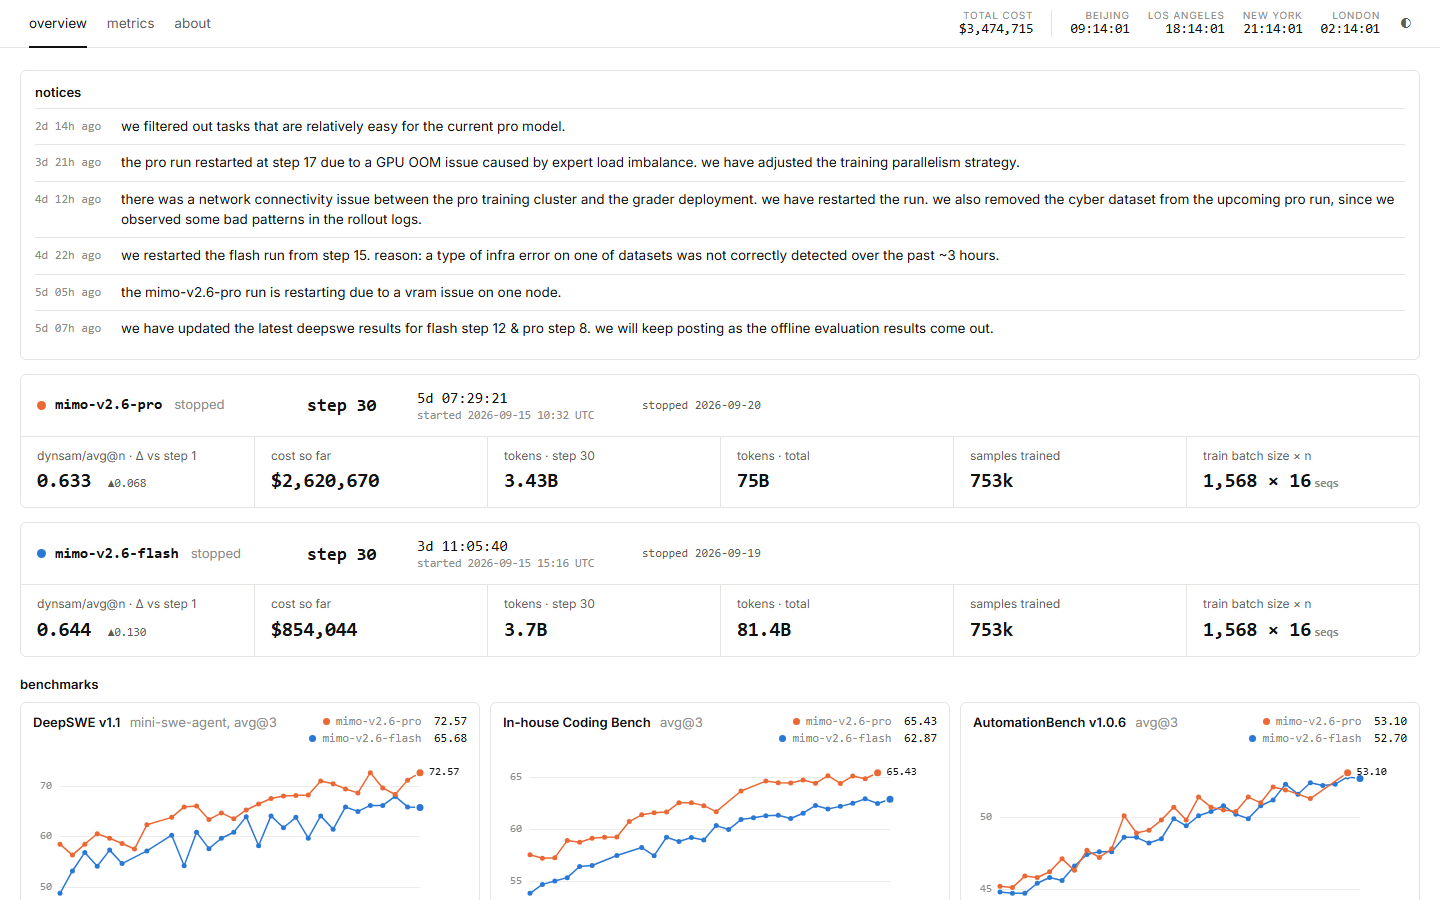
上图截自 mimo.xiaomi.com/rl/。顶部 TOTAL COST $3,474,715 是两个 run 的合计;下方 notices 是训练期间逐条发布的故障通报——这也是后文要重点讲的部分。
面板里的 notices:把翻车过程摊开给人看
这是我认为这篇发布最值得看的部分。官方 RL 面板的 notices 区,留下了这样几条(时间戳为面板原文):
| 时间 | 官方通报原文要点 |
|---|---|
| 2 天前 | 我们过滤掉了对当前 Pro 模型相对容易的任务 |
| 3 天前 | Pro run 在第 17 步重启,原因是 expert load imbalance 导致的 GPU OOM;我们调整了训练并行策略 |
| 4 天前 | Pro 训练集群与 grader 部署之间出现网络连通性问题,已重启 run;同时从后续 Pro run 中移除了 cyber 数据集,因为我们在 rollout 日志里观察到了不良 pattern |
| 4 天前 | Flash run 从第 15 步重启,原因是某个数据集上的一类 infra 错误在过去约 3 小时里没有被正确检测出来 |
| 5 天前 | Pro run 因某个节点的 VRAM 问题重启 |
| 5 天前 | 我们更新了 Flash 第 12 步与 Pro 第 8 步的 DeepSWE 结果,离线评测结果出来后会继续贴 |
面板同时给出了两个 run 的最终账本:
| MiMo-V2.6-Pro | MiMo-V2.6-Flash | |
|---|---|---|
| 状态 | 30 步 / stopped | 30 步 / stopped |
| 耗时 | 5 天 07:29:21 | 3 天 11:05:40 |
| 起止(UTC) | 09-15 10:32 → 09-20 | 09-15 15:16 → 09-19 |
| 指标(dysam/avg@n,Δ vs 第 1 步) | 0.633(+0.068) | 0.644(+0.130) |
| 成本 | $2,620,670 | $854,044 |
| Token / 步(第 30 步) | 3.43B | 3.7B |
| Token 累计 | 75B | 81.4B |
| 采样数 | 753k | 753k |
| 批次 | 1,568 × 16 seqs | 1,568 × 16 seqs |
两个细节值得注意:
- Flash 的增益(+0.130)明显高于 Pro(+0.068)。 起点低的空间更大,这也解释了为什么 Flash 用 1/3 的钱拿到了相对更大的提升。
- Flash 累计 token(81.4B)反而比 Pro(75B)多,但成本只有 Pro 的三分之一——省下来的钱来自单位 token 价格,而不是训练量。
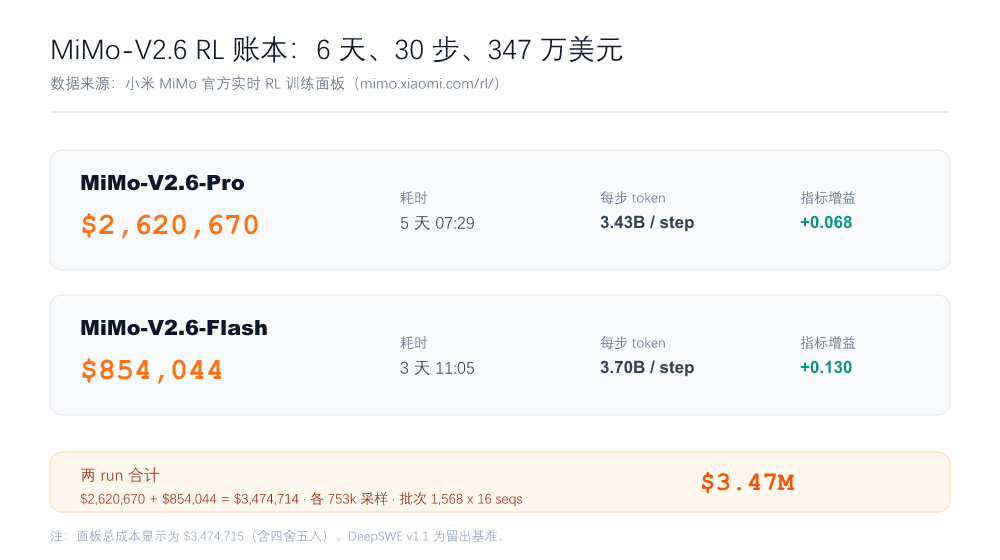
上图由 uuaihub 依据官方 RL 面板数据绘制。两个 run 各 753k 采样、批次同为 1,568 × 16 seqs,账单一共 $347 万——而 Flash 的指标增益反而更大(+0.130 vs +0.068)。
稳定性:冻结 router,和一套防 reward hacking 的组合
RL 规模一大,最常见的两类问题就是训练漂移和奖励作弊。官方这次都点了名:
- 漂移:随着 run 规模变大,他们冻结了 router(froze the router)来抑制训练漂移。
- 奖励作弊:建了一套横跨奖励设计、对抗评估、异常检测、验证者交叉校验的防线。
工程侧还有一串描述,用大白话说就是”把大规模异构任务的 RL 搬上台面”必须解决的脏活:统一的轨迹表示与惩罚机制提供更细粒度的学习信号;支持跨多个 Agent 框架的高并发交互;把控制面与数据面解耦以支持大规模轨迹迁移;在混合批次内稳定每个任务的采样比例;以及训练与推理引擎两者及其一致性的优化。
读到这里可以有个判断:这一节里没有一条是”模型创新”,全是工程量。 而它们决定了上面那些分数到底能不能被复现。
从 Vibe Coding 到「Vibe World」
MiMo-V2.6 的第二个重点是能力边界的外扩。官方的说法是:编码能力已经泛化出软件工程之外——给一个目标、一个 harness、一点时间,它就能做真实的生产性工作。官方把这条路径叫 “Vibe World”。
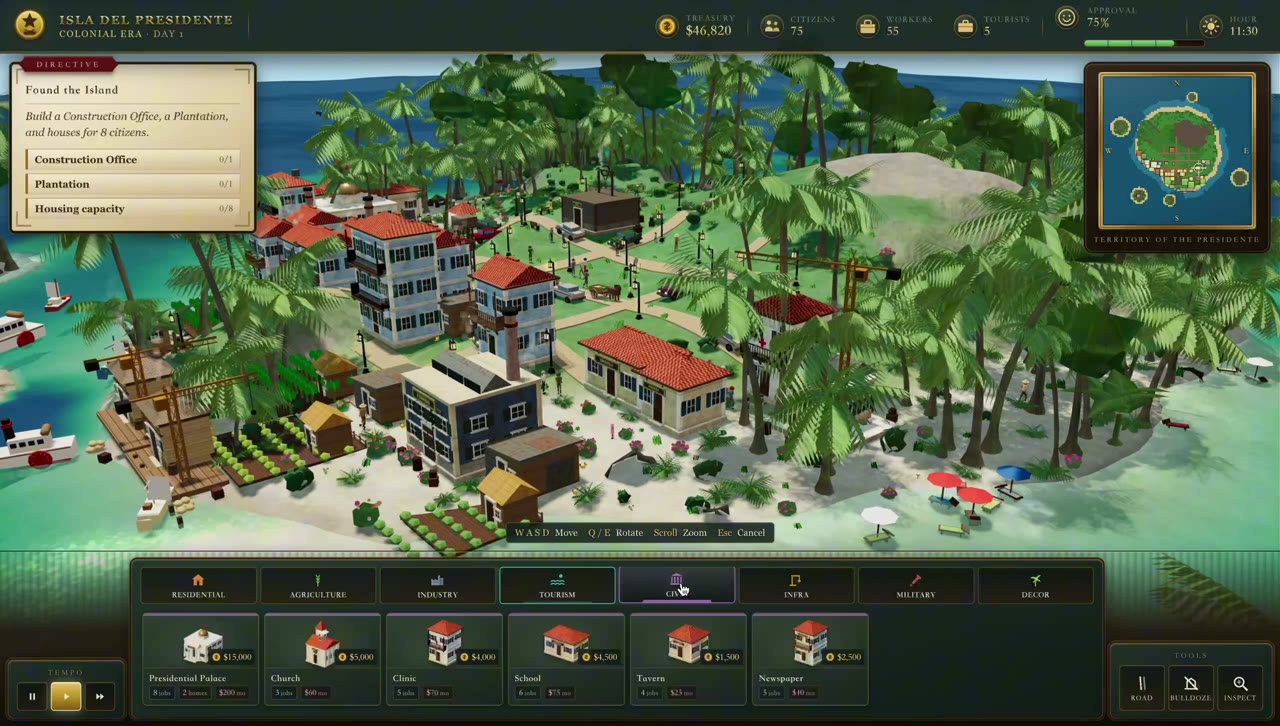
上图是官方发布页展示的 demo 之一:模型从一张图 / 一段视频 / 一句文本出发,拆解任务、协调多个 Agent 搭出 3D 场景、写交互逻辑、做视觉验证,最后交付一个可运行的交互世界。这一张是游戏《Isla del Presidente》的运行画面。图片版权归小米 MiMo 团队所有,本文仅作引用。
五个方向,逐个看:
① 游戏开发。 输入图 / 视频 / 文本 → 拆成多个任务 → 多 Agent 协作建 3D 场景、实现交互逻辑、做视觉验证 → 根据渲染结果迭代修正,最终产出贴合意图的可运行世界。
② 3D 建模。 从文字描述或参考图,在 Blender 里生成 3D 物体与场景,产出可用于动画、3D 打印、游戏开发的资产。
③ 具身仿真。 在仿真环境里直接以多视角相机画面为输入,持续推理并决策,通过视觉反馈闭环控制 Franka Panda 机械臂,完成物体抓取、颜色匹配与精确放置。
④ 视觉与设计。 一句指令 → 完整前端界面或幻灯片:结构化布局、组件设计、交互元素、动效;也熟悉 Figma、图像与视频生成工具,并能保持排版、配色、图文关系的整体一致。
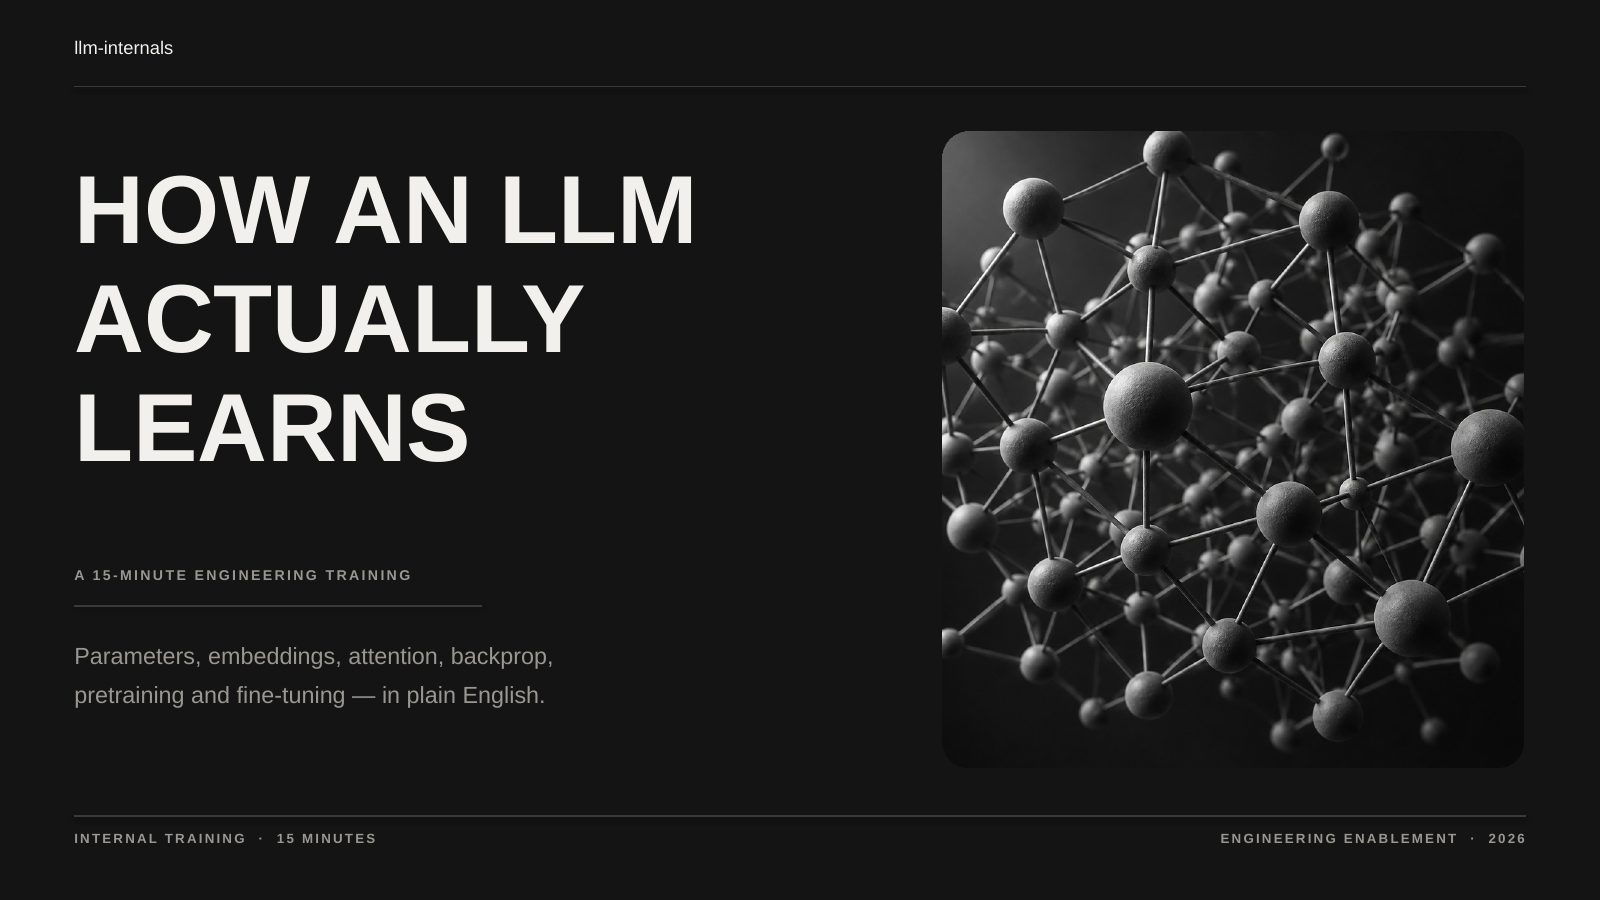
上图同样是官方发布页的 demo:三份演示文稿,各自由一行 brief 生成——一份 LLM 学习的内部工程培训、一份关键矿产超级周期的研究简报、一份公司首份年报的三方向设计评审。图片版权归小米 MiMo 团队所有。
⑤ 视频与音乐。 视频侧,公开描述是”端到端”:视觉设计、镜头与运动编排、配乐、按节拍对齐的剪辑;教学视频则把抽象概念(官方举的是傅里叶分解)变成可理解的解释与连贯动画,并用 MiMo-V2.5-TTS 生成与画面对齐的解说。
音乐侧是一条新线:官方称加强了对音乐的理解、审美判断与乐理运用,作为作曲方向的首次探索——能写出 demo 级的作品。案例里给了一个很具体的:让 MiMo-V2.6-Pro 为约十件乐器写一首管弦乐,它自己写谱、自己转成 MIDI;成品里有弦乐、双簧管、单簧管、小号、长号、圆号、钟琴与定音鼓。官方还给了第二个案例:要求两首 A 小调钢琴曲,一慢一中速,用来展示对力度、织体等作曲要素的掌控。
两个科研案例:一个”干实验”,一个形式化证明
官方明确说:MiMo-V2.6 并没有针对科学研究做专门的 RL,下面这些只是它把推理、编码、工具使用能力用到具体研究任务上的表现。
案例一:材料学”AI 联合科学家”。 小米的材料专家让 MiMo-V2.6-Pro 设计一种全新的金属有机框架(MOF),用来吸附 PFAS——就是那类被称为”永久化学品”的全氟和多氟烷基物质。模型做的事串起来是:全面 web 搜索 → 查阅相关文献与专利 → 提出假设 → 评估新颖性 → 进入”干实验”(调用开源计算工具、自动搭建仿真环境、计算 MOF 与 PFAS 的结合强度),最后筛出值得进湿实验室的候选。官方附图给出了三个候选的 UiO-67 型 Zr₆ 框架结构。
案例二:把经典定理形式化。 研究人员让 MiMo-V2.6-Pro 协助完成 Li 与 Yorke 经典论文《Period Three Implies Chaos》主定理的 Lean 4 形式化——该定理说的是:对区间上的连续自映射,存在周期三轨道就意味着存在任意正整数周期的周期轨道,以及一个不可数的混沌集。在研究人员设计的探索策略引导下,模型用子 Agent 协作推进定理陈述与证明的形式化,项目最终超过 6,000 行 Lean 源码,完整证明通过 Lean 内核验证、没有未完成的占位符。
最后一句才是重点:模型没有接受过任何 Lean 专项后训练。
可用性
官方给出的上架渠道是:AI Studio、MiMo Code、MiMo Desktop、MiMo API Platform、OpenRouter。
- MiMo Desktop 同时结束早期访问、发布首个正式版,内置 Pro 与 Flash,并上线 Pro-UltraSpeed 模式(最高 20 倍速度)。早期访问计划再延长一周。
- API 已在小米 MiMo 开放平台上线,定价与 V2.5 一致;Pro 也可用 UltraSpeed 模式调用;另提供 Token Plan 用于可预期的高用量场景。
怎么读这次发布:三条判断
第一,开源阵营的天花板又抬了一格。 按官方口径,46.32 分已经越过 Kimi K3、Qwen3.8 Max。而 AA 图表里摆在 MiMo-V2.6-Pro 前面的,清一色是闭源模型(Claude Fable 5、Gemini 3.6、Grok 4.7、Claude Opus 5、GPT-5.6)。开源与闭源之间剩下的差距,已经从”代差”缩到”几分”。
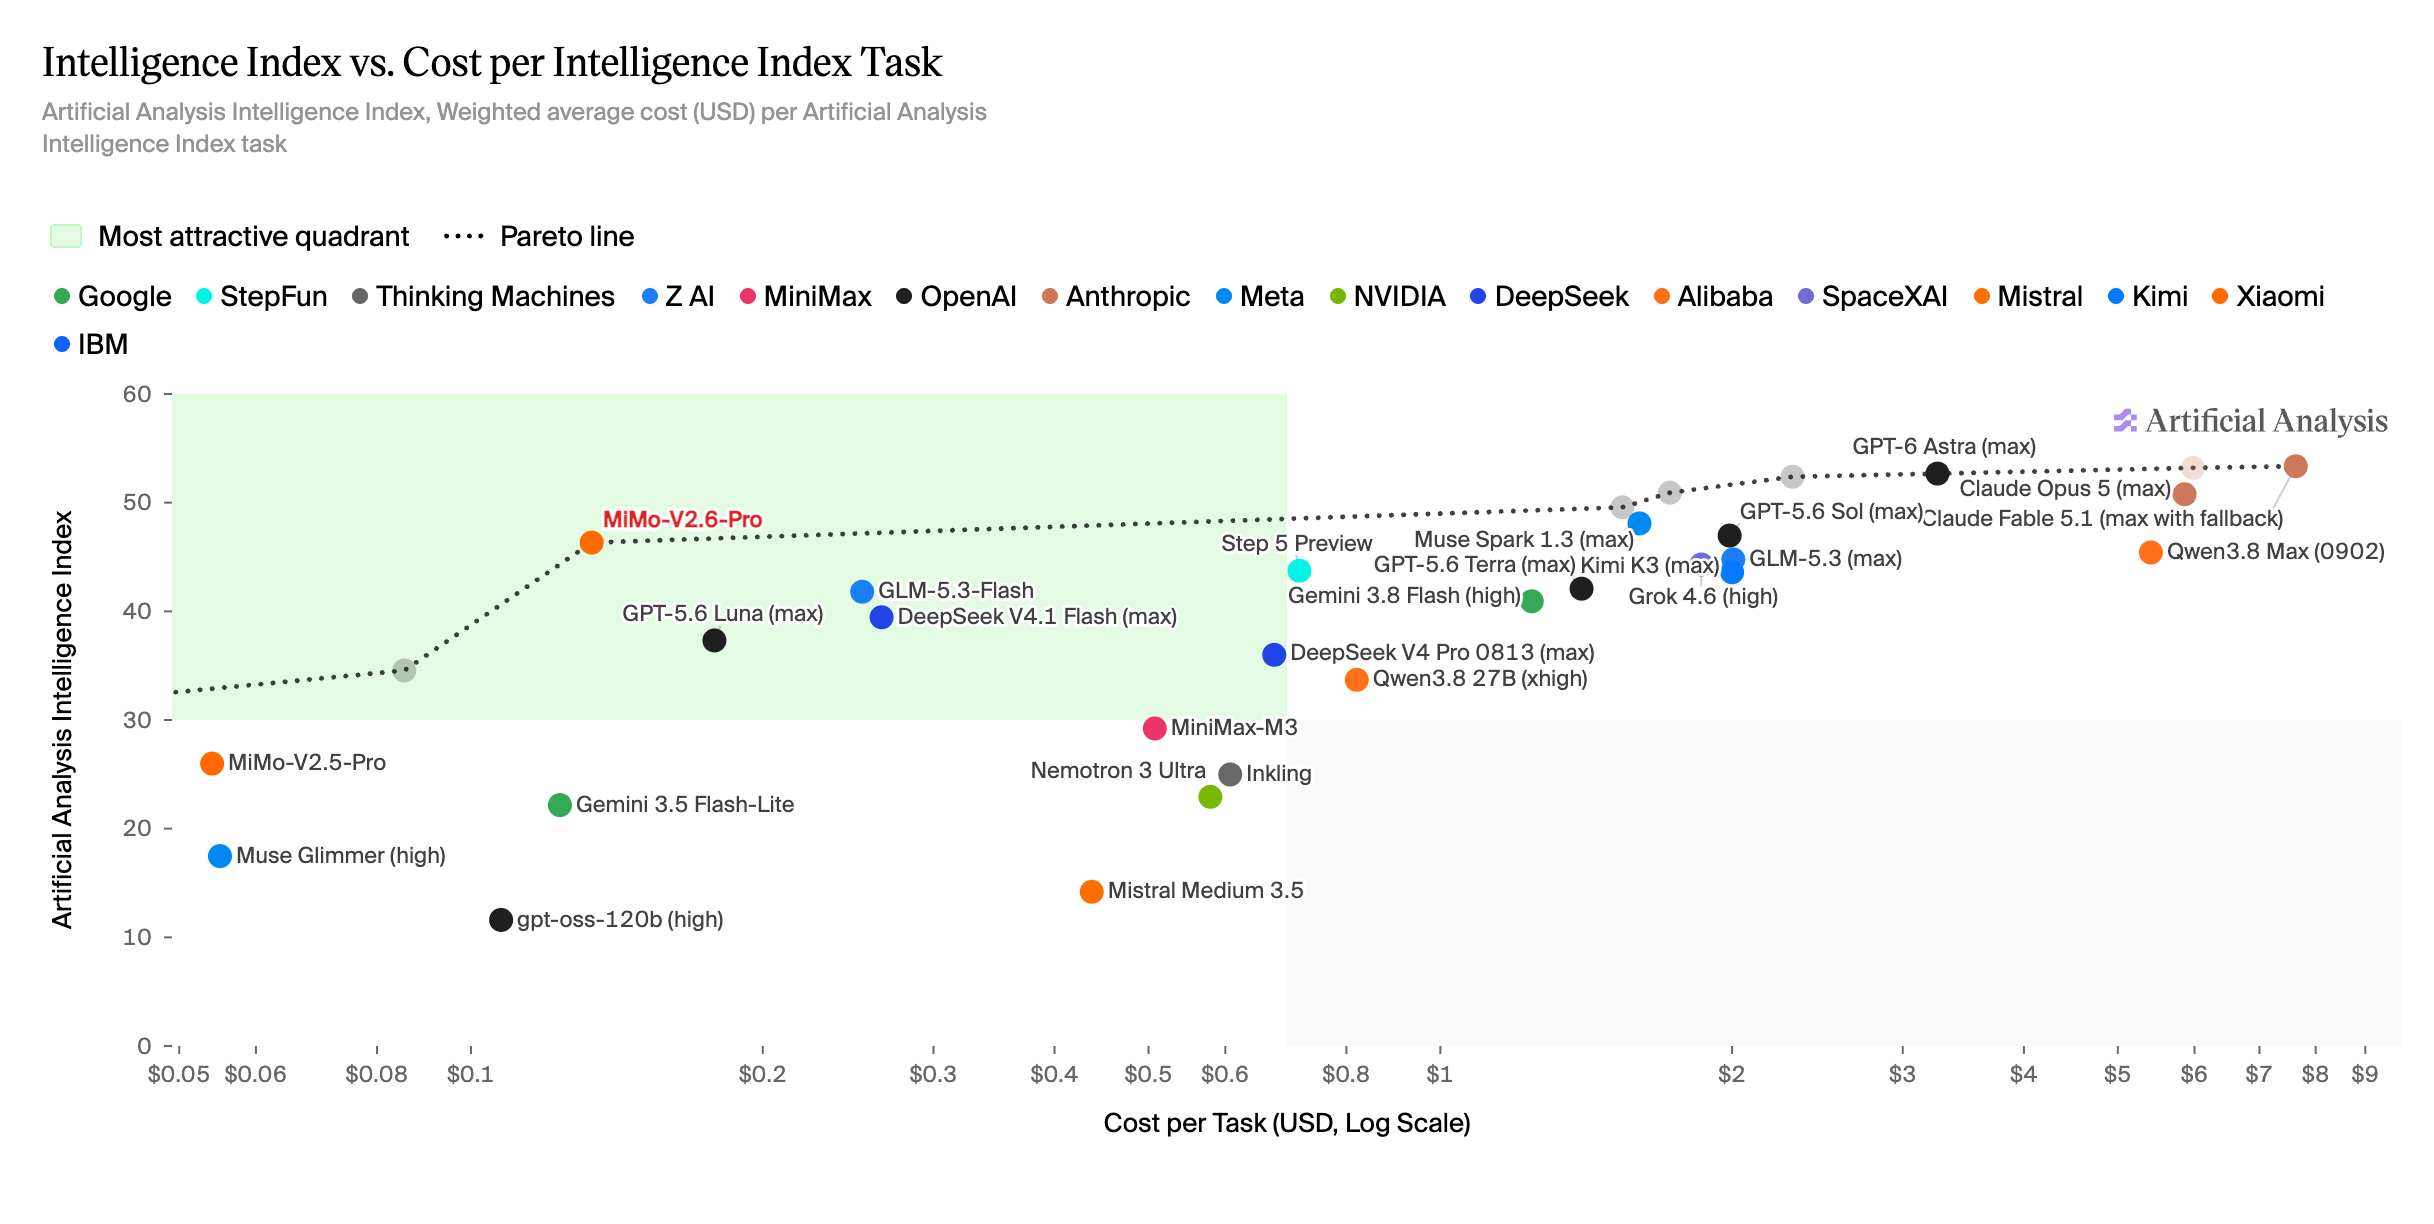
上图来自小米 MiMo 官方发布页(数据源标注为 Artificial Analysis,横轴为对数刻度)。绿色区域是”最有吸引力的象限”,虚线是帕累托线——MiMo-V2.6-Pro 落在帕累托线上,右侧同分区间里是成本高出一个数量级的闭源模型。这正是官方”同价格、更高智能,把帕累托前沿继续外推”那句话的图示。
第二,训练成本第一次变成可比较的公开量。 347 万美元这个数字是可以被同行对标的:30 步 RL、75 万条轨迹、每步 3.5–3.7B token。以后再看”某模型的 RL 后训练”,就可以问一句:你的起步价是多少?
第三,“built in public” 的价值不在营销,在可复现。 开源权重早就不稀奇了。这次额外给出的是技术报告 + 训练环境 + RL 代码,以及一个还在线的训练面板——包括那条”某个 infra 错误在过去约 3 小时没有被正确检测出来”。愿意把这类内容留在公开页面上,本身就是一种信号。
值得一提的巧合
同一天(9 月 21–22 日),SpaceXAI 发布了闭源的 Grok 4.7,AA 智能指数 46。小米以 46.32 分、约 1/20 的调用价格开出了同分位的东西。 两条路线在同一天撞到同一个分数上,这件事本身比任何单点评测都更说明当前的格局。Grok 4.7 那一条线的代价分析,见本站另一篇《Grok 4.7:智能只涨 2 分,思考量翻了 2.5 倍》。
本文事实依据:小米 MiMo 官方发布博客(2026-09-22)、官方实时 RL 训练面板(训练结束后仍在线)、Artificial Analysis 智能指数 v4.3、Hacker News 讨论帖。配图来源:官方发布页截图与官方图床图片(版权归小米 MiMo 团队所有)、官方 RL 面板截图、Artificial Analysis 页面截图,均已下载至本地引用,未使用外链。