一句话总结
一家藏在 stealth 里两年的公司 TypeSafe AI 在 9 月 15 日放出了 Jev——一个「给软件用、不给人看」的模型:你送进去一段状态(文本或 JSON)加几个带选项的问题,它返回的是选项、分数和校准过的概率,而不是一段需要你再解析的自然语言。官方给的口径是同一类判断上快 40–200 倍、便宜 40–400 倍;代价是它只会做「一秒内的直觉判断」,凡是需要算术、日期比较或多跳推理的场景,都得你自己在代码里解决。
数据来源:TypeSafe AI 官方发布帖《Introducing System One Models & Jev》(2026-09-15)与官方文档(docs.typesafe.ai 的 Models / Primitives / Confidence / AI primer / Jev 1.13 jaggedness 页面)、The Register(2026-09-16)、Vercel Changelog 与 AI Gateway 模型页、DCVC 融资公告与 BusinessWire 新闻稿、Hacker News 讨论帖(1901 分、约 500 条评论)、Forkast 分析。
一个不会写字的模型,四天刷屏
先把场景摆出来。你写过一个客服工单的分流逻辑:调一次大模型,让它判断这条消息该去「退款」「技术」「销售」哪个队列,然后在代码里写个 if。为了这个 if,你顺手写了三样东西——一个解析返回 JSON 的 parser、一个校验选项是否在枚举里的检查、一个失败重试。parser 存在的唯一原因,是模型只会写字。
Jev 押的就是这批「其实只是一个 if 语句」的模型调用。
它的发布方 TypeSafe AI 由 Diogo Almeida 创办,按官方文档的说法,他是 InstructGPT 论文作者之一,也是 RLHF(基于人类反馈的强化学习)的共同发明人——也就是 ChatGPT 那套「让模型听话」的方法的研究源头。他在发布帖里的开场问题很直接:“Models have been superhuman at chat for years, so where is all the automation?”(模型在聊天上超越人类好几年了,那自动化在哪里?)
发布当日,公司同时宣布完成了 4000 万美元种子轮(DCVC 领投),Forkast 报道其估值约 2 亿美元。三天之内,这条消息从 The Register 的报道走到 Vercel AI Gateway 上线,再走进 Hacker News 首页——发帖当天冲到 1900 分上下、近 500 条评论。
配图:TypeSafe AI 官网(typesafe.ai)首屏,页面顶部公告条指向 9 月 15 日的发布帖,主标题写着 “The First (Public) System One”。图片为官网截图,版权归 TypeSafe AI 所有。
它到底在做什么:状态进去,类型化决策出来
官方的定义只有一句话:unstructured state in, typed probabilistic decisions out(无结构状态进,带概率的类型化决策出)。
和 LLM 的差别落在四个地方,官方发布帖自己列了一张对比表:
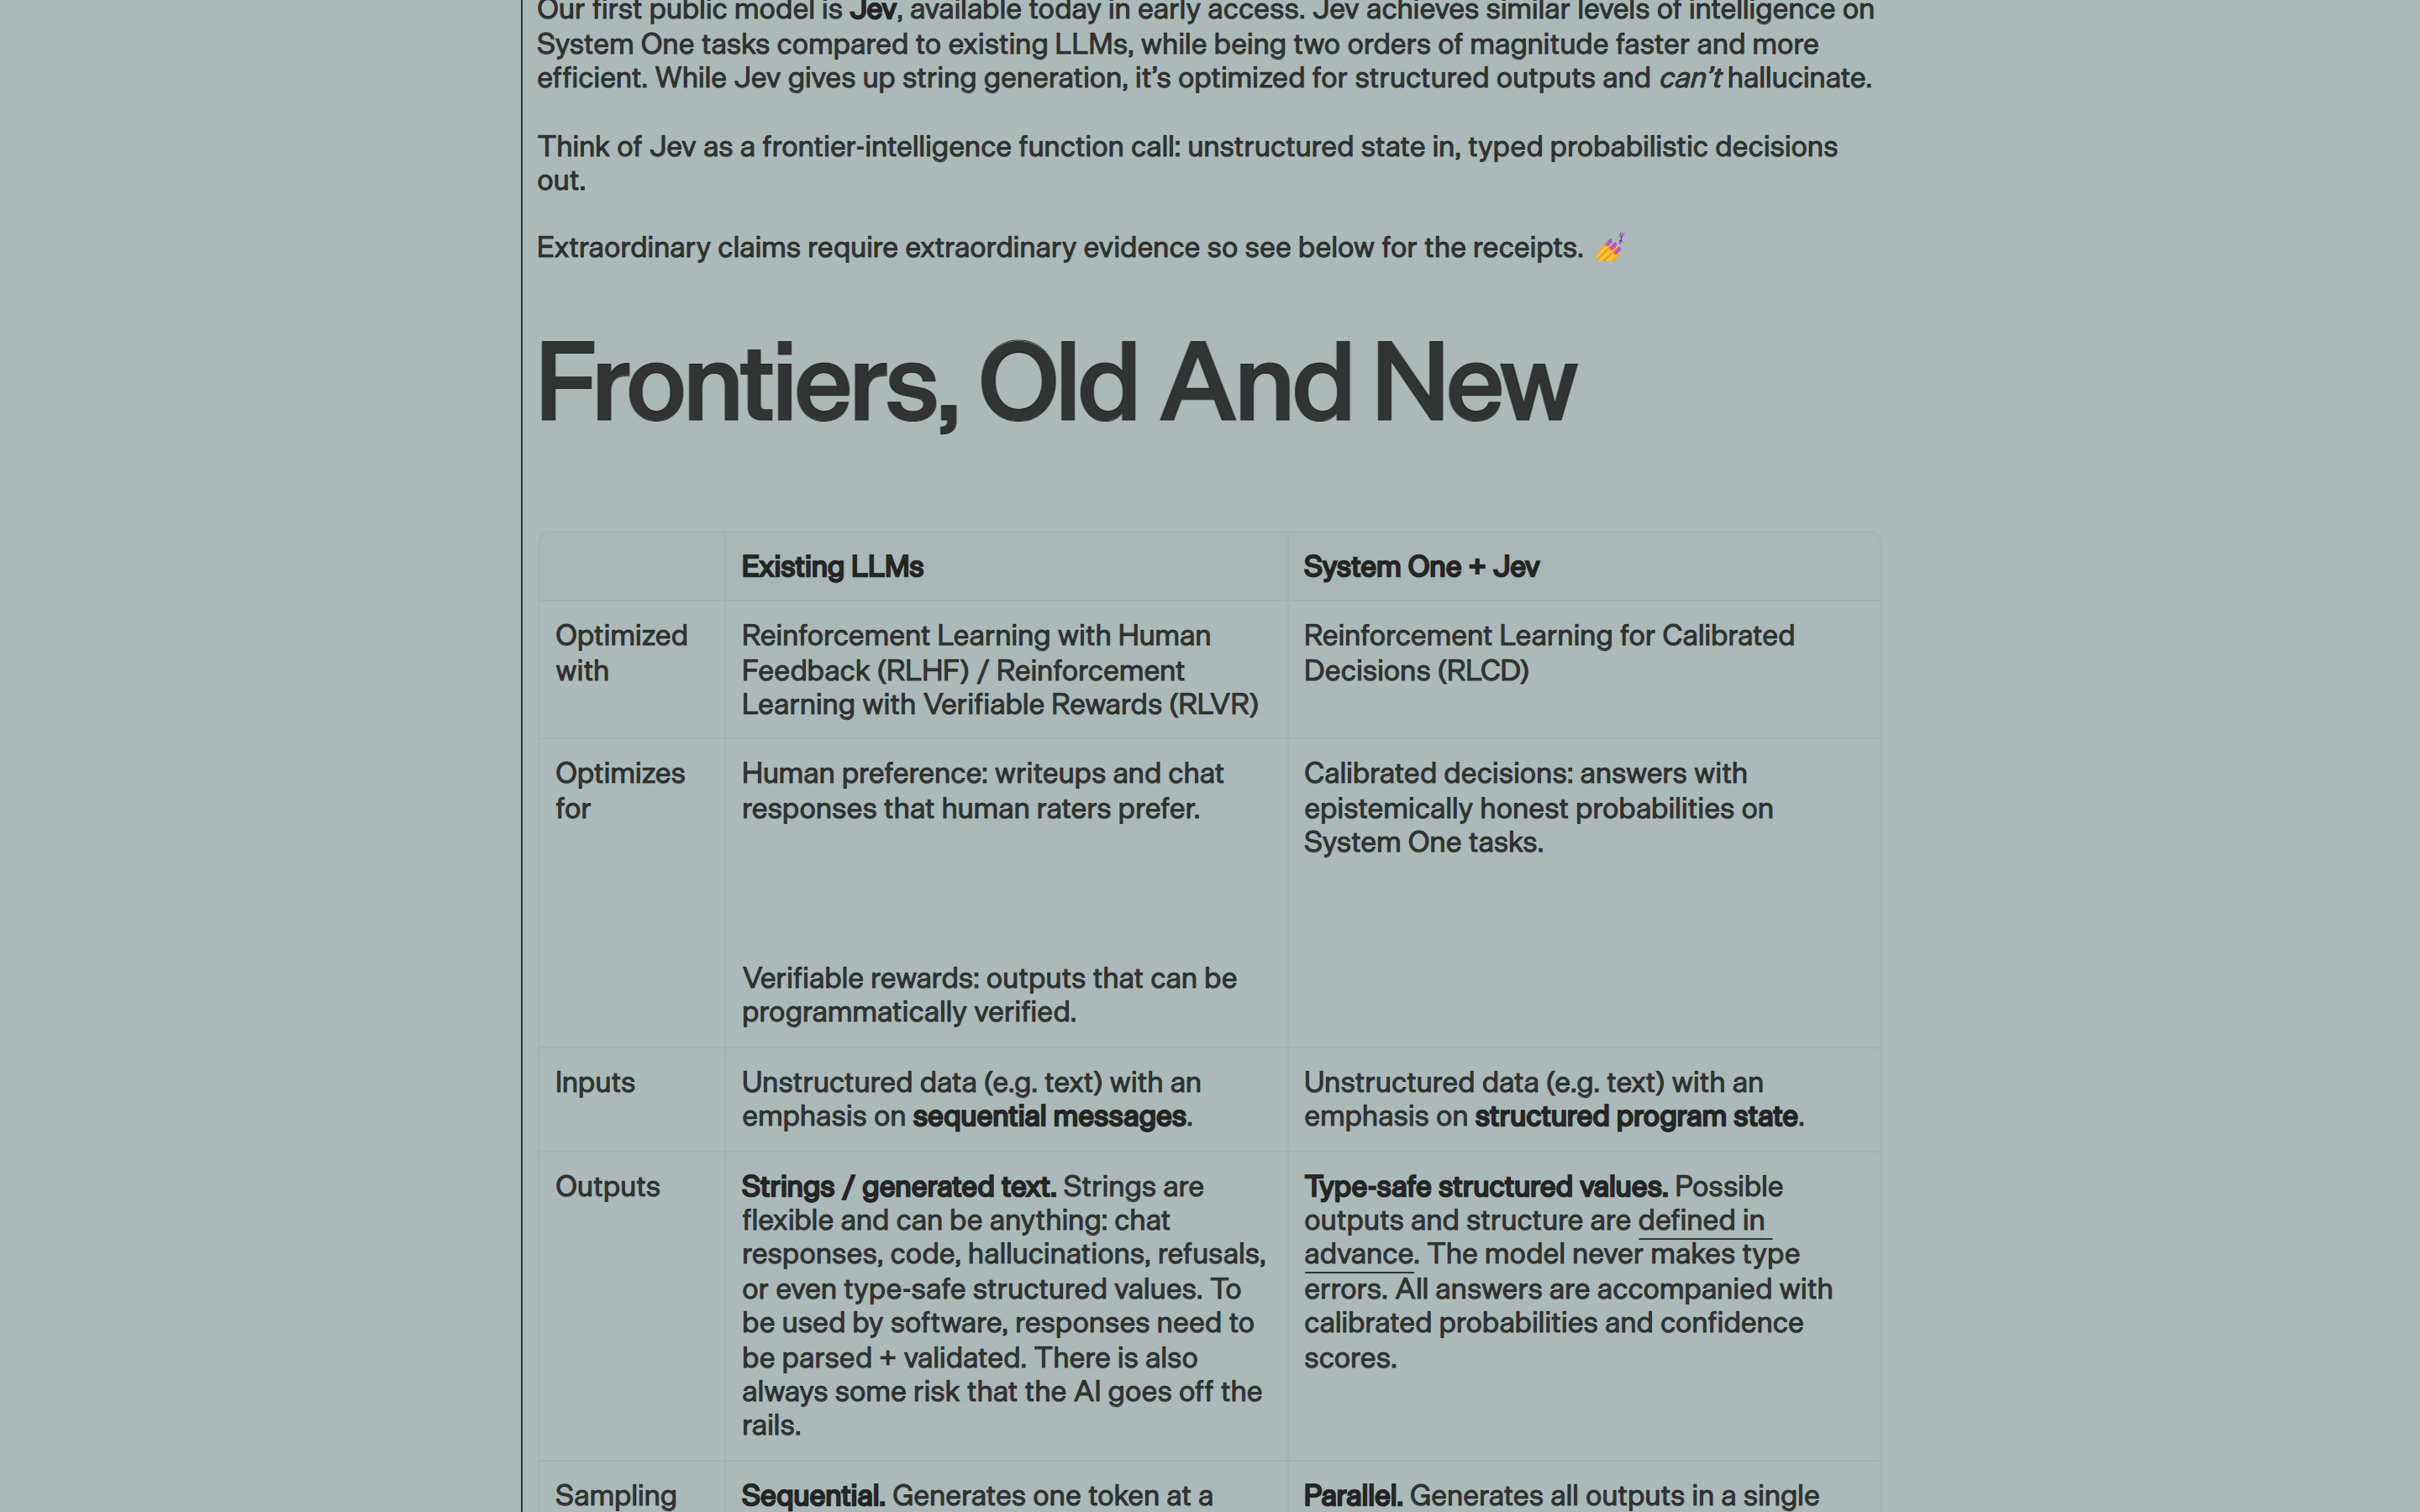
配图:官方发布帖中的对比表,逐项比较训练目标、输入、输出、采样方式、成本、速度、置信度与适用场景。图片来自 TypeSafe AI 官方发布帖,版权归 TypeSafe AI 所有。
- 训练目标不同:LLM 用 RLHF(优化人类偏好的回复)或 RLVR(优化可程序化验证的奖励);Jev 用的是 RLCD——Reinforcement Learning for Calibrated Decisions,优化目标写得很明确:让「概率 0.8 的结果,在大量预测里约 80% 是对的」。
- 采样方式不同:LLM 逐 token 顺序生成;Jev 在一次查询里并行产出所有答案,这也是它速度与成本优势的主要来源。
- 输出契约不同:可能出现的取值在请求里就定死了,模型不可能返回枚举之外的值——所以官方敢说「零类型错误」。
- 成本结构不同:输入 $0.042/百万 token,输出 token 免费,因为根本没有输出 token 可数。
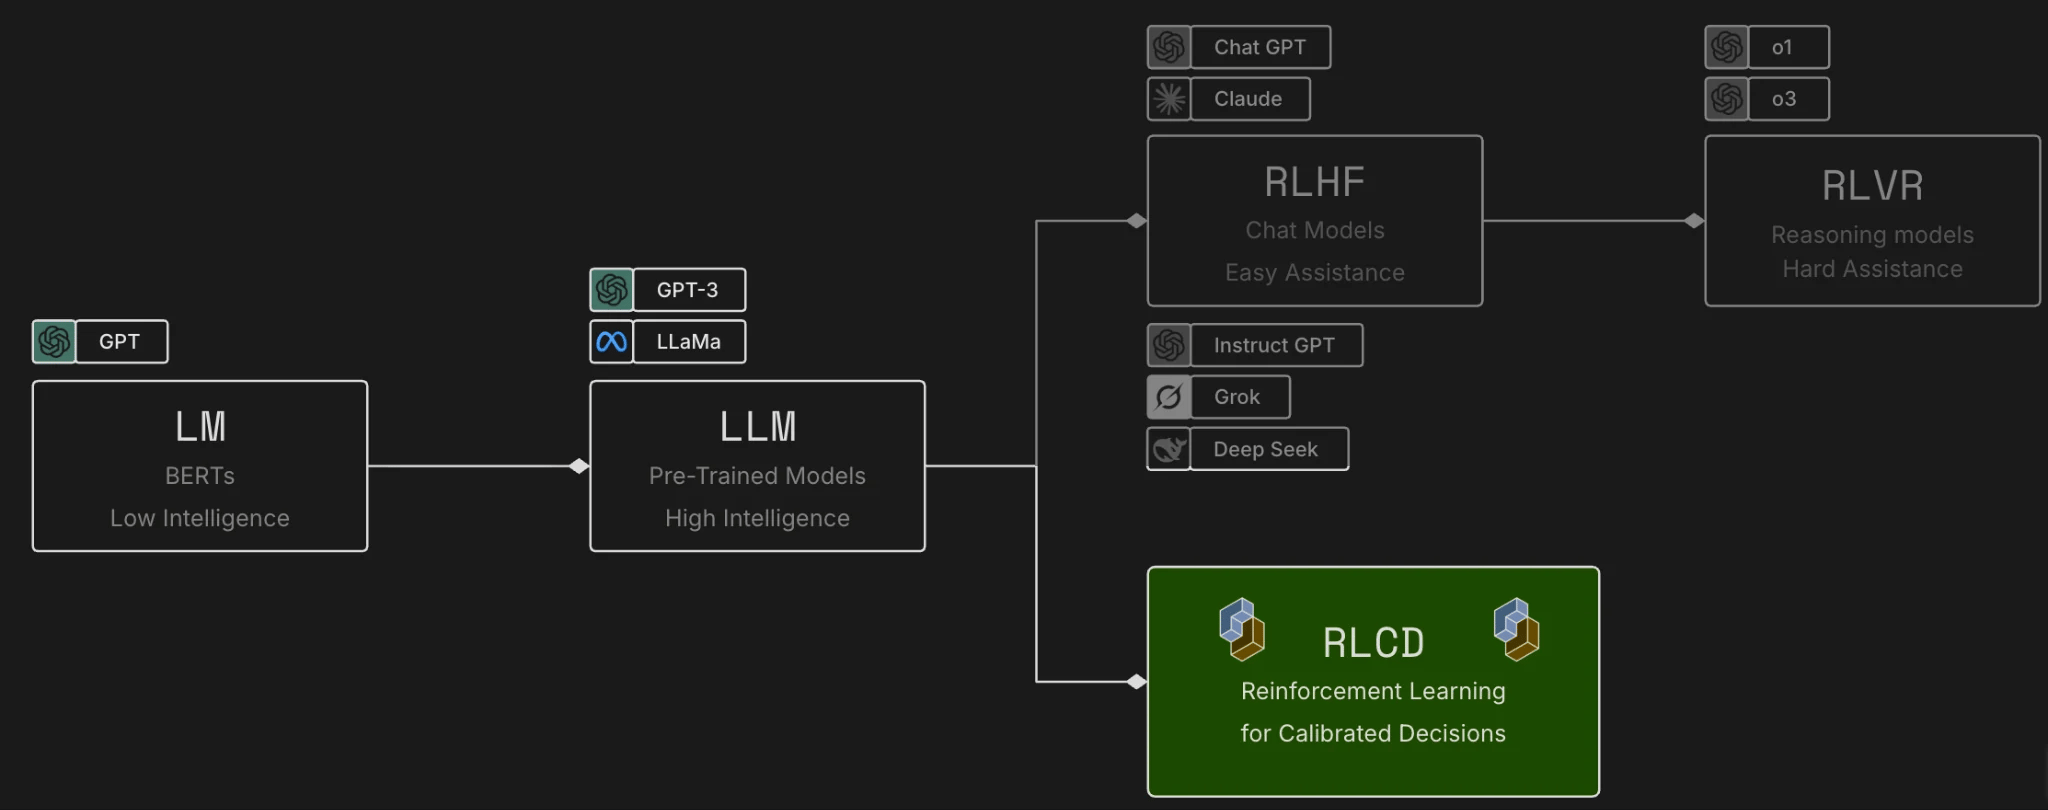
配图:官方文档 AI primer 里的训练路径图——预训练语言模型在 RLHF 之后走向对话模型(ChatGPT、Claude),在 RLVR 之后走向推理模型(o1、o3),而 RLCD 是一条被官方高亮出来的第三条路。图片来自 TypeSafe 官方文档,版权归 TypeSafe AI 所有。
官方对 RLHF 的批评也写在文档里:偏好优化会奖励「说人爱听的话」,并导致 mode dropping——模型把概率质量集中到被奖励的那种风格上,其它可能的回答被丢掉。
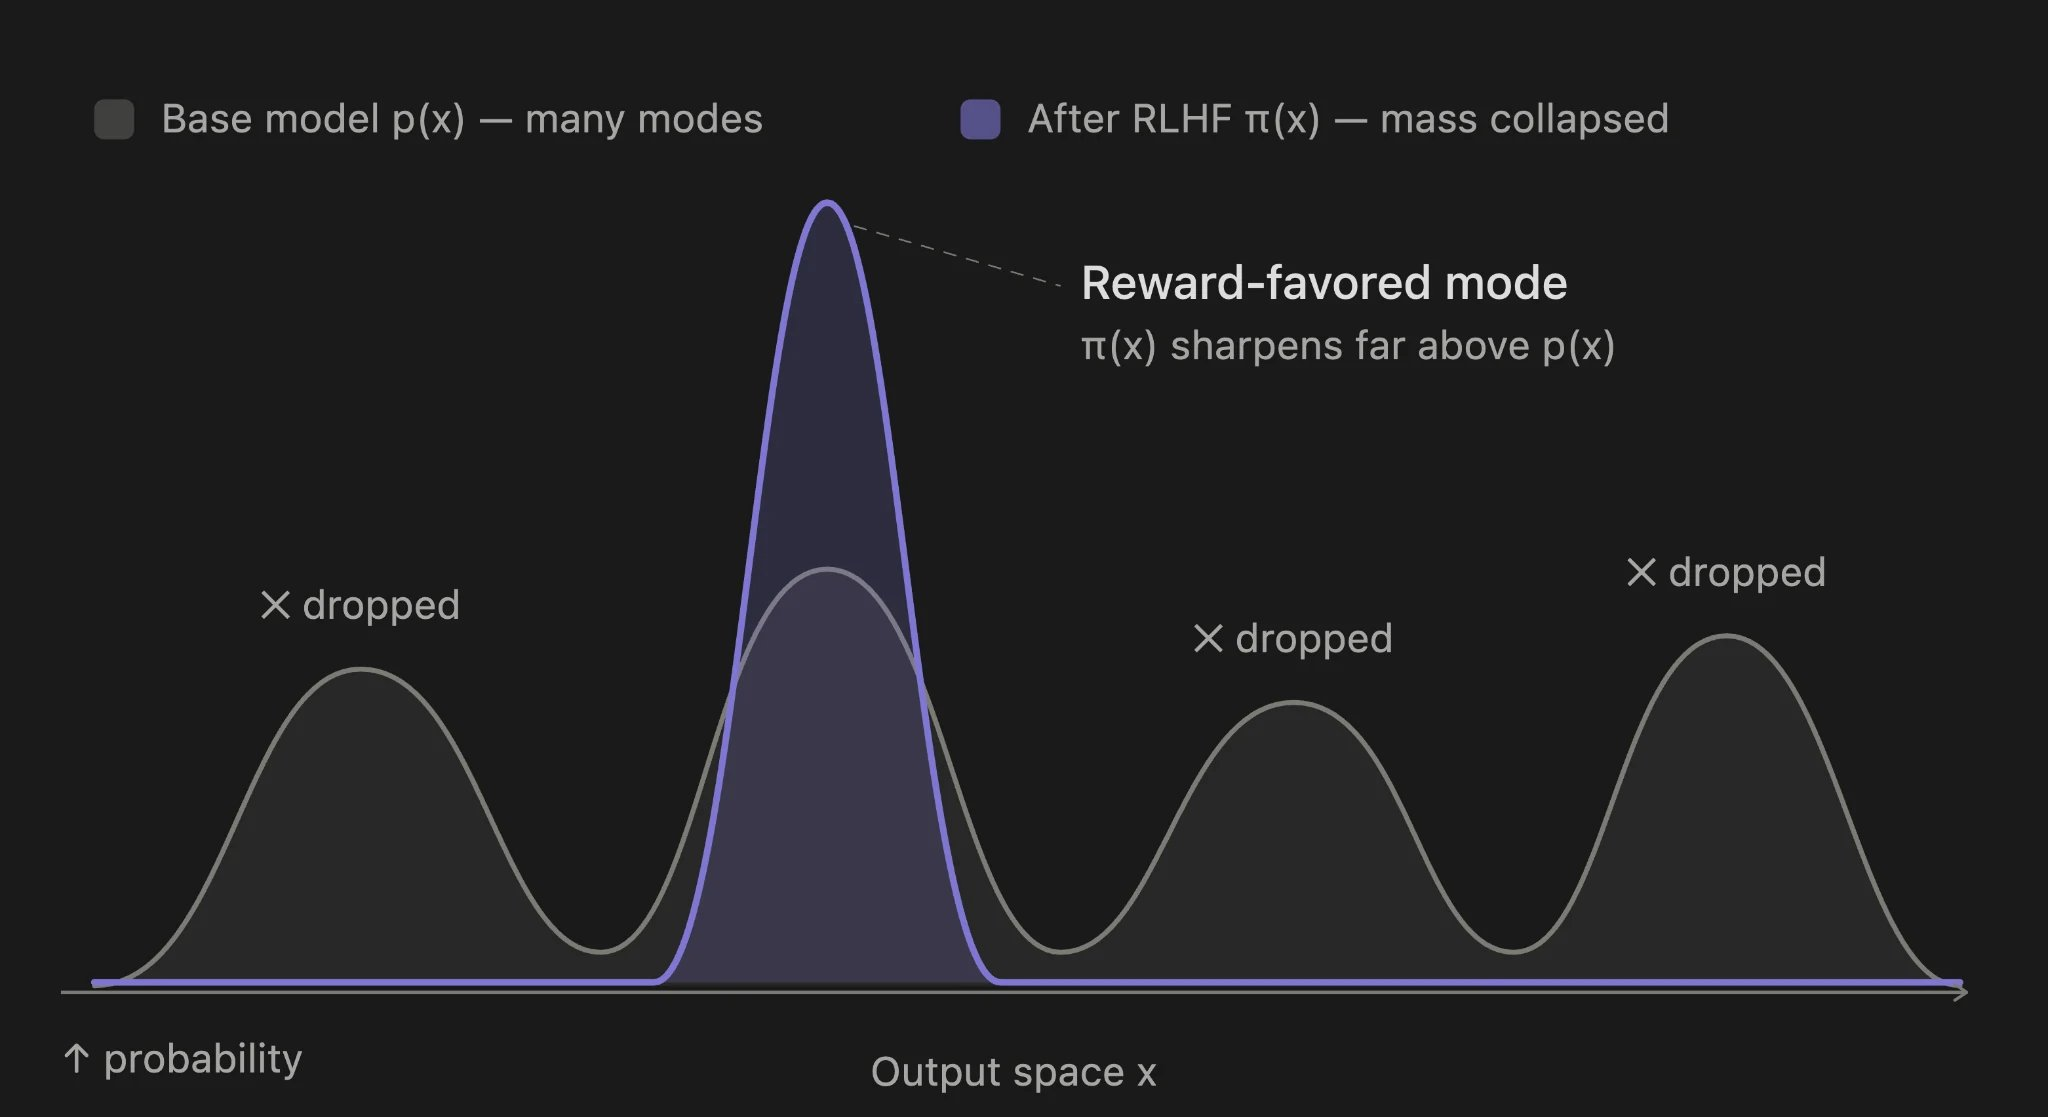
配图:官方文档用一张分布图解释 mode dropping——基底模型 p(x) 的多个峰,在 RLHF 之后只剩下被奖励的那一个峰(π(x) 被削得又尖又高)。图片来自 TypeSafe 官方文档,版权归 TypeSafe AI 所有。
三个原语:Choice / Score / Noul
工程接口只有三个「问题类型」,官方叫 AI primitives:
| 原语 | 回答什么 | 返回什么 |
|---|---|---|
| Choice | 从给定选项里选一个(最多 255 个选项) | choice + 全量概率分布 + confidence |
| Score | 按你定义的档位打分,可落在两档之间 | score + legend + 概率分布 + confidence |
| Noul | 某个判断是真还是假 | noul:0–1 的「是」的概率(无独立 confidence) |
三个原语可以混在同一次调用里,各自独立针对同一份 state 并行求值——官方强调加问题几乎不增加延迟,也不会互相串扰(no context rot)。
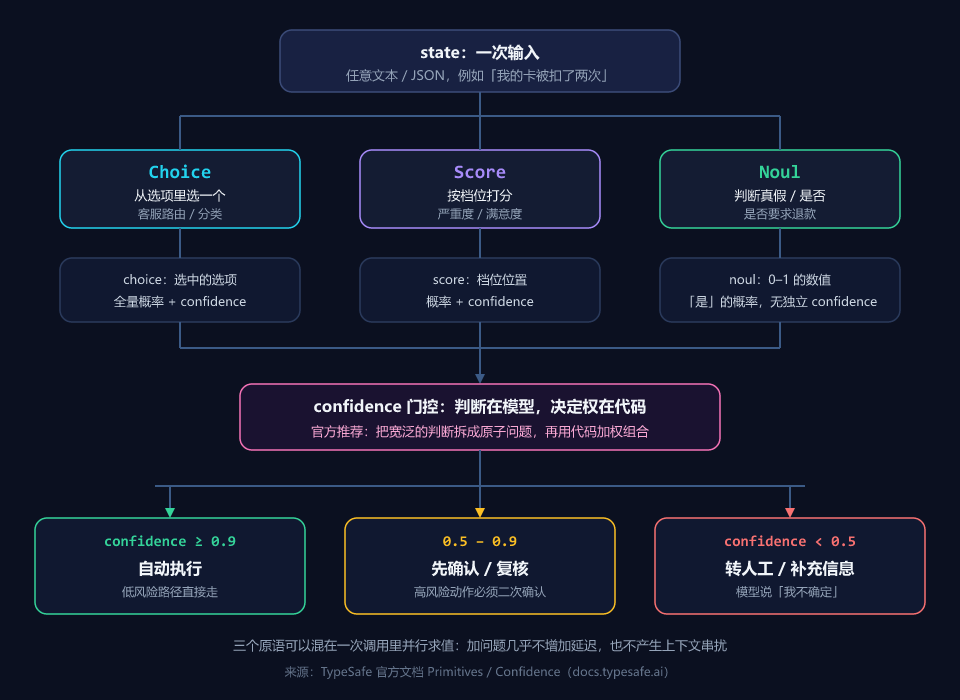
配图:Jev 的三个原语与 confidence 门控流程(依据官方文档 Primitives 与 Confidence 章节整理)。判断交给模型,决定权留在代码里——这也是整个 System One 设计的核心主张。
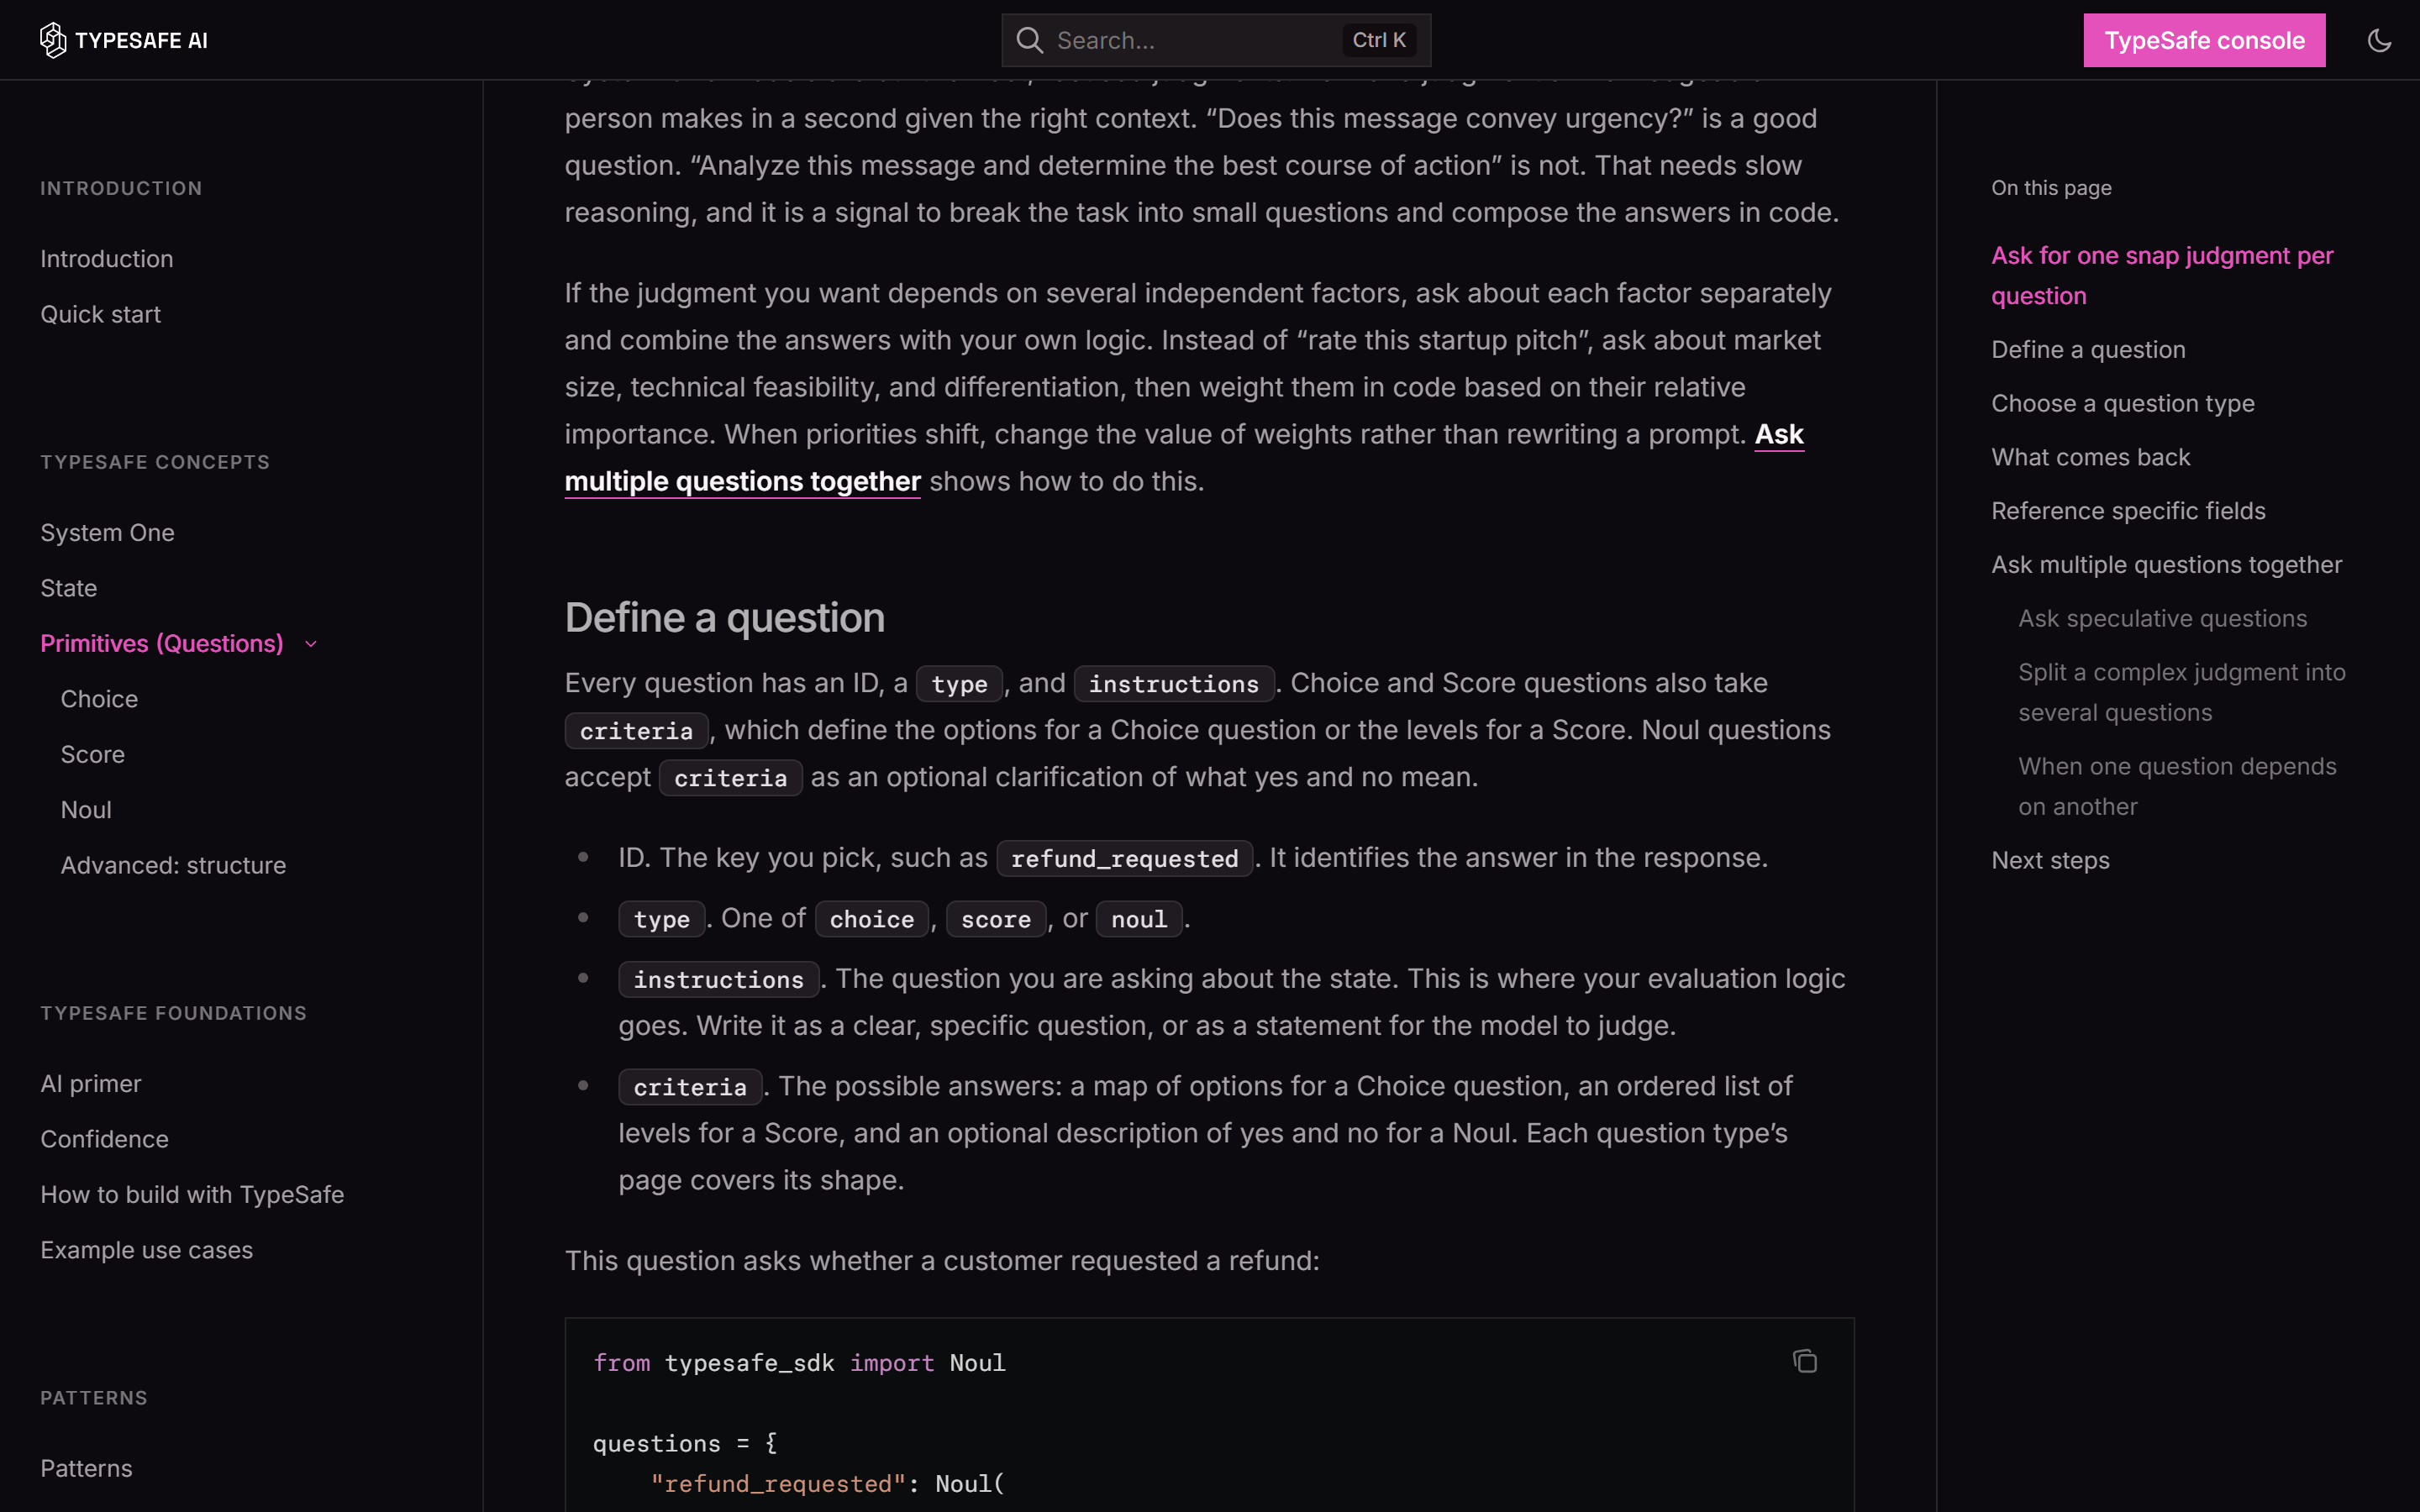
配图:官方文档 Primitives 页面,其中反复强调一条设计纪律:「Ask for one snap judgment per question」——一个问题只问一个能在几秒内做出的判断,多因素判断要拆成多个问题、再用代码加权组合。图片为 TypeSafe 官方文档截图,版权归 TypeSafe AI 所有。
官方文档给的标准用法长这样:
from typesafe_sdk import Noul, Choice

resp = client.system_one(
    state="我的卡被扣了两次,麻烦看一下。",
    questions={
        "refund_requested": Noul(instructions="客户是否要求退款?"),
        "queue": Choice(
            instructions="这条工单应该交给哪个队列?",
            criteria={"billing": "账单问题", "technical": "技术问题", "other": "其它"},
        ),
    },
)

ans = resp.answers["queue"]
if ans.confidence < 0.5:
    route_to_human(state)          # 模型自己说「不确定」,就不要再猜
elif ans.choice == "billing":
    handle_billing(state)
confidence 是官方推荐的关键杠杆:高置信自动执行、中置信先确认、低置信转人工——阈值按风险分级,官方文档给的原则是「read-only 操作的门槛可以低,破坏性操作的门槛要高」。
硬指标(截至 2026-09-19,模型版本 jev-1.13)
| 项目 | 数值 |
|---|---|
| 模型 ID | jev-1.13.0(别名 jev-latest / jev-preview),统一走 POST /v1/systemone |
| 价格 | 输入 $0.042/百万 token($42/十亿),输出免费 |
| 限速 | 25 万 token/秒、1200 请求/分钟(官方称随 GPU 到位动态调整) |
| 上下文 | 单次请求 64k token;其中 state + 最长的问题合计不超过 32k |
| 输入模态 | 仅文本(字符串 / JSON 对象 / 文本数组),不支持图像、音频、视频 |
| 延迟 | 官方口径 70–500ms(自测跑在美西的服务器上) |
| 定制 | 不做客户数据微调/LoRA,所有账号共用同一份权重;领域知识放进 state,规则放进 instructions 和 criteria |
把它换算成日常感受:官方那个 Doom demo 让 Jev 以约 每秒 10 次判断控制游戏里的机器人,跑一小时花约 7 美元——官方员工原话是「比我们预想的便宜」。作为对照,媒体在报道里拿 GPT-5.6 Terra 的价格做比较:输入 $2/百万、输出 $12/百万 token。
名字的出处:杰文斯悖论
Jev 这个名字来自 19 世纪经济学家 William Stanley Jevons。他观察到一个反直觉的现象:蒸汽机效率提高、单位煤炭消耗下降之后,英国的煤炭总消耗量反而上升——因为便宜下来的能源解锁了更多用途。
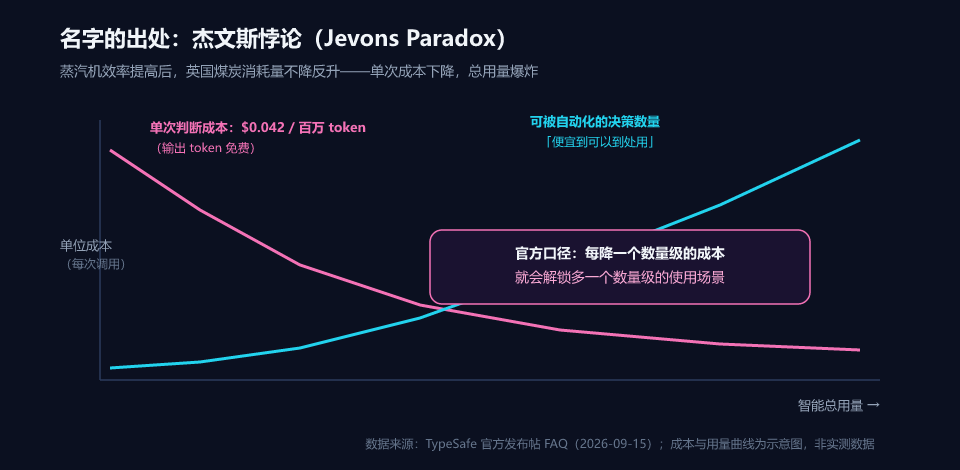
配图:官方 FAQ 里对名字由来的解释与杰文斯悖论的示意(成本与用量曲线为示意,非实测数据;说明文字来自官方发布帖)。
TypeSafe 把这个逻辑平移到智能上:每降一个数量级的成本,就会解锁多一个数量级的使用场景。这也解释了它为什么不打算和前沿 LLM 抢同一块地盘——它的赌注是:未来绝大多数 AI 调用根本不是给人看的聊天,而是软件内部一个廉价、快速、可校验的判断。
官方给出的证据,以及官方自己标出的边界
发布帖里最硬的两张图,一张讲「类型错误」,一张讲「性价比」。
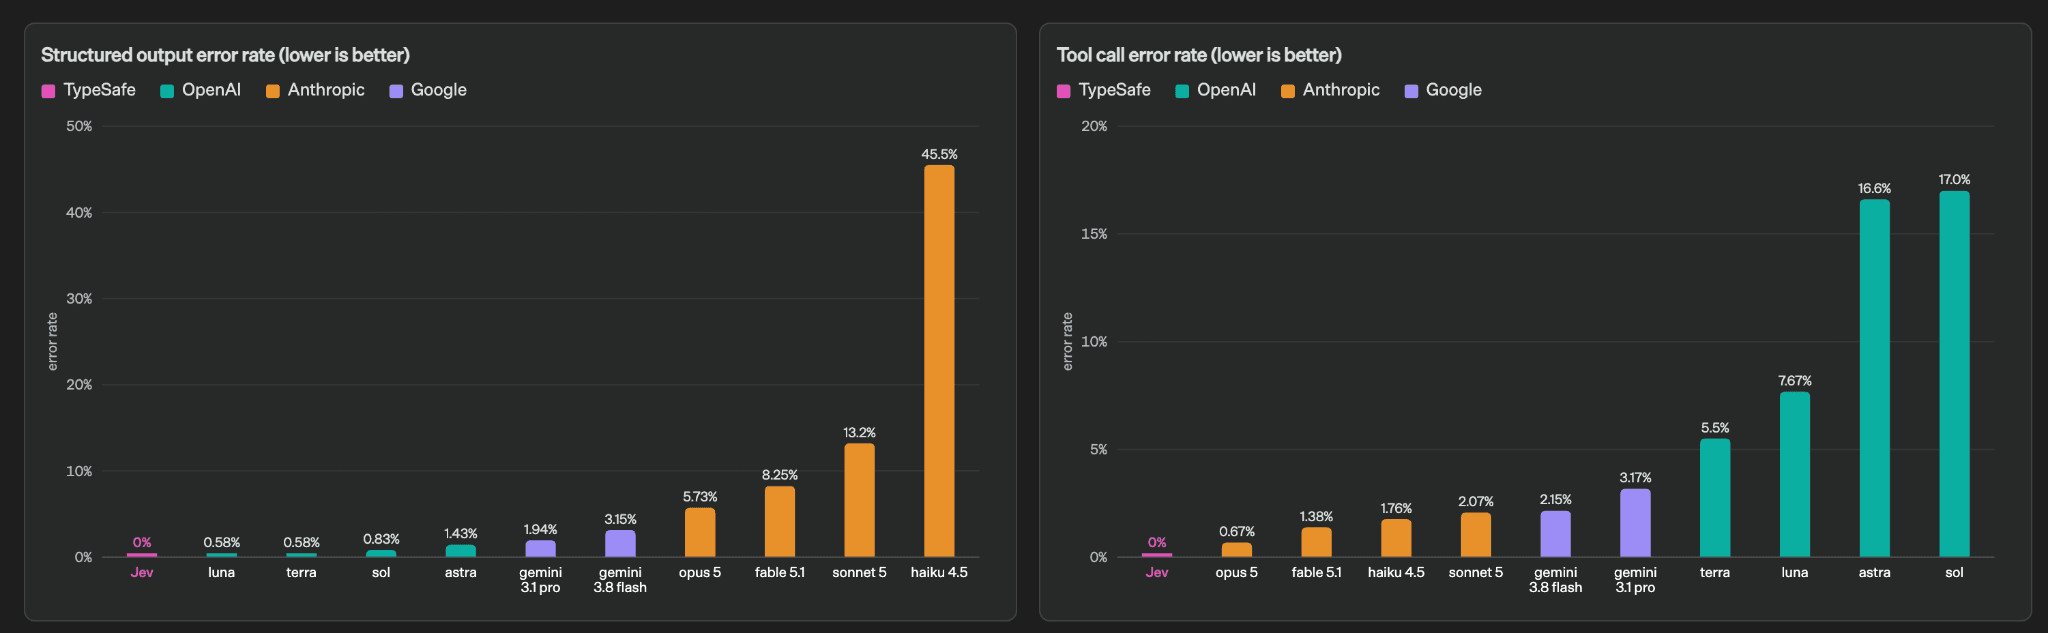
配图:官方发布帖中的两张误差对比图——左为结构化输出错误率,右为工具调用错误率,Jev 均为 0%,对比对象包括 OpenAI、Anthropic、Google 的多个模型。图片来自 TypeSafe AI 官方发布帖,版权归 TypeSafe AI 所有。
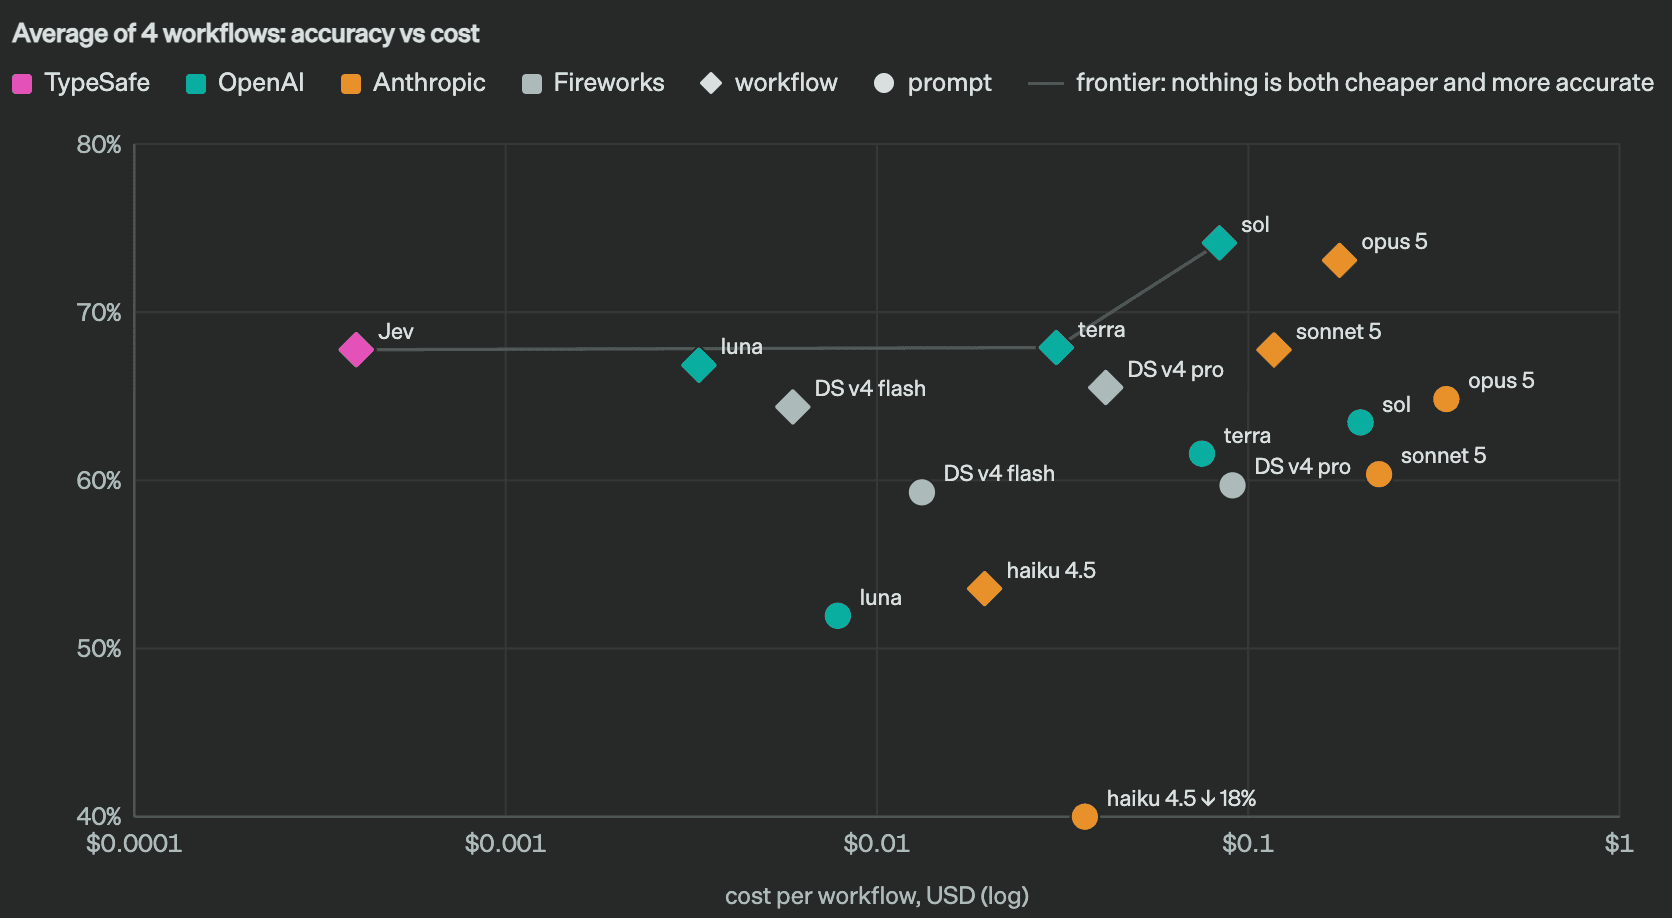
配图:官方发布帖中「4 条工作流的平均:准确率 vs 成本」图,Jev 以约 68% 的准确率、$0.0005 量级的单次成本占据帕累托前沿左侧。图片来自 TypeSafe AI 官方发布帖,版权归 TypeSafe AI 所有。
需要留意的是,官方把这些数字的边界写得非常清楚(这点在 AI 发布里并不常见):
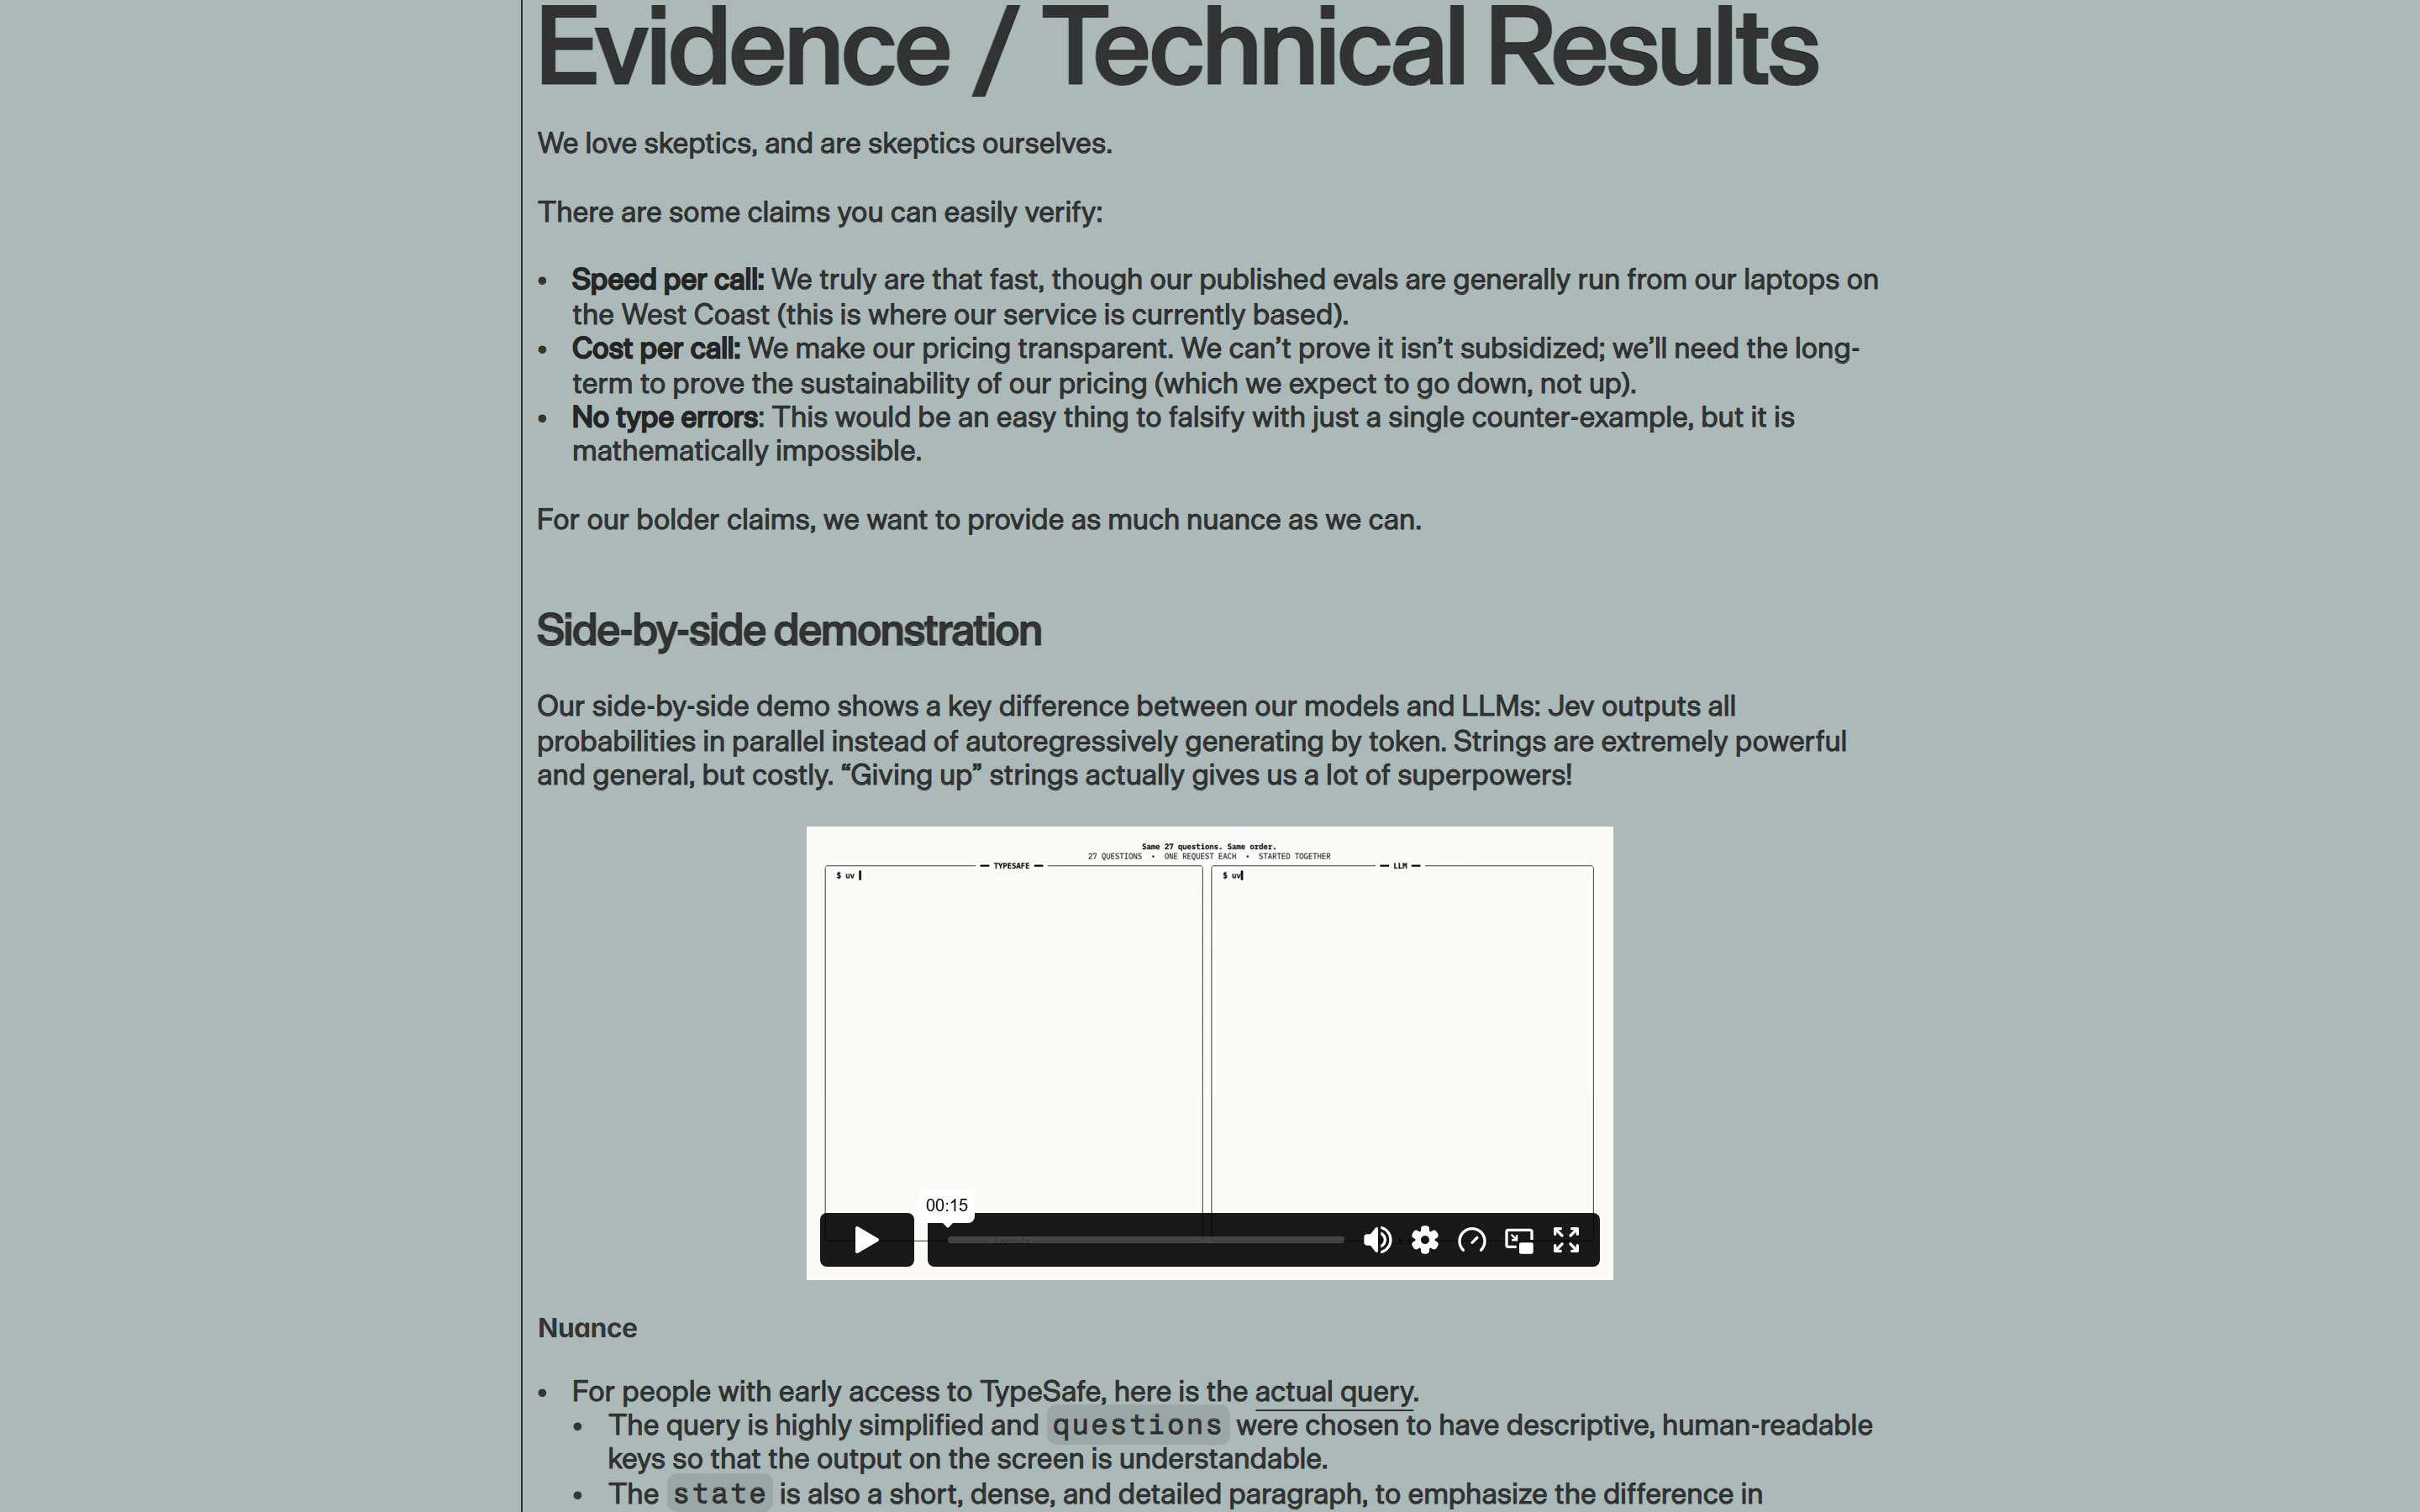
配图:官方发布帖 Evidence 章节开头与 side-by-side 演示的说明。图片来自 TypeSafe AI 官方发布帖,版权归 TypeSafe AI 所有。
- 0% 类型错误不是实测结果,而是架构保证——官方原话是「这很容易用一个反例证伪,但它在数学上不可能发生」;它保证的是「不会吐出不存在的第 6 个枚举值」,不保证「选出来的那个判断是对的」。
- 速度与成本的 193.6× / 444.6× 来自官方自家 4 条工作流的评测,官方主动补了三条弱化说明:评测机器是美西的笔记本、参考基线用 GPT-6 Astra 与 Fable 5.1 的平均值(偏向 OpenAI/Anthropic,可能低估了自己)、「我们无法证明这个价格没有补贴」。
- 评测工作流由官方团队自己构造,不在训练分布里,但不排除存在偏向。
已经落地的地方
- Vercel AI Gateway:9 月 16 日上线,模型 ID
typesafe-ai/jev,通过 AI SDK 7 的experimental_evaluate调用;官方 changelog 特别标注它支持 Zero Data Retention 与 No Training(逐请求开启)。 - 智能工作流:官方给的典型形态是「智能 if」——分类、路由、打分、抽取、分支。文档示例覆盖客服工单路由、告警分诊、发票与回执核对、RAG 段落相关性筛选。
- 验证与护栏:给 LLM 的输出/推理链打分、判断是否越狱、做审核前置开关。
- 实时交互:Doom(10 QPS)、Wikipedia 跳转游戏 Wikiracing(官方特意说明这个 demo 里 Jev 的优势缩小了,因为对比对象是各家模型的非推理模式)。
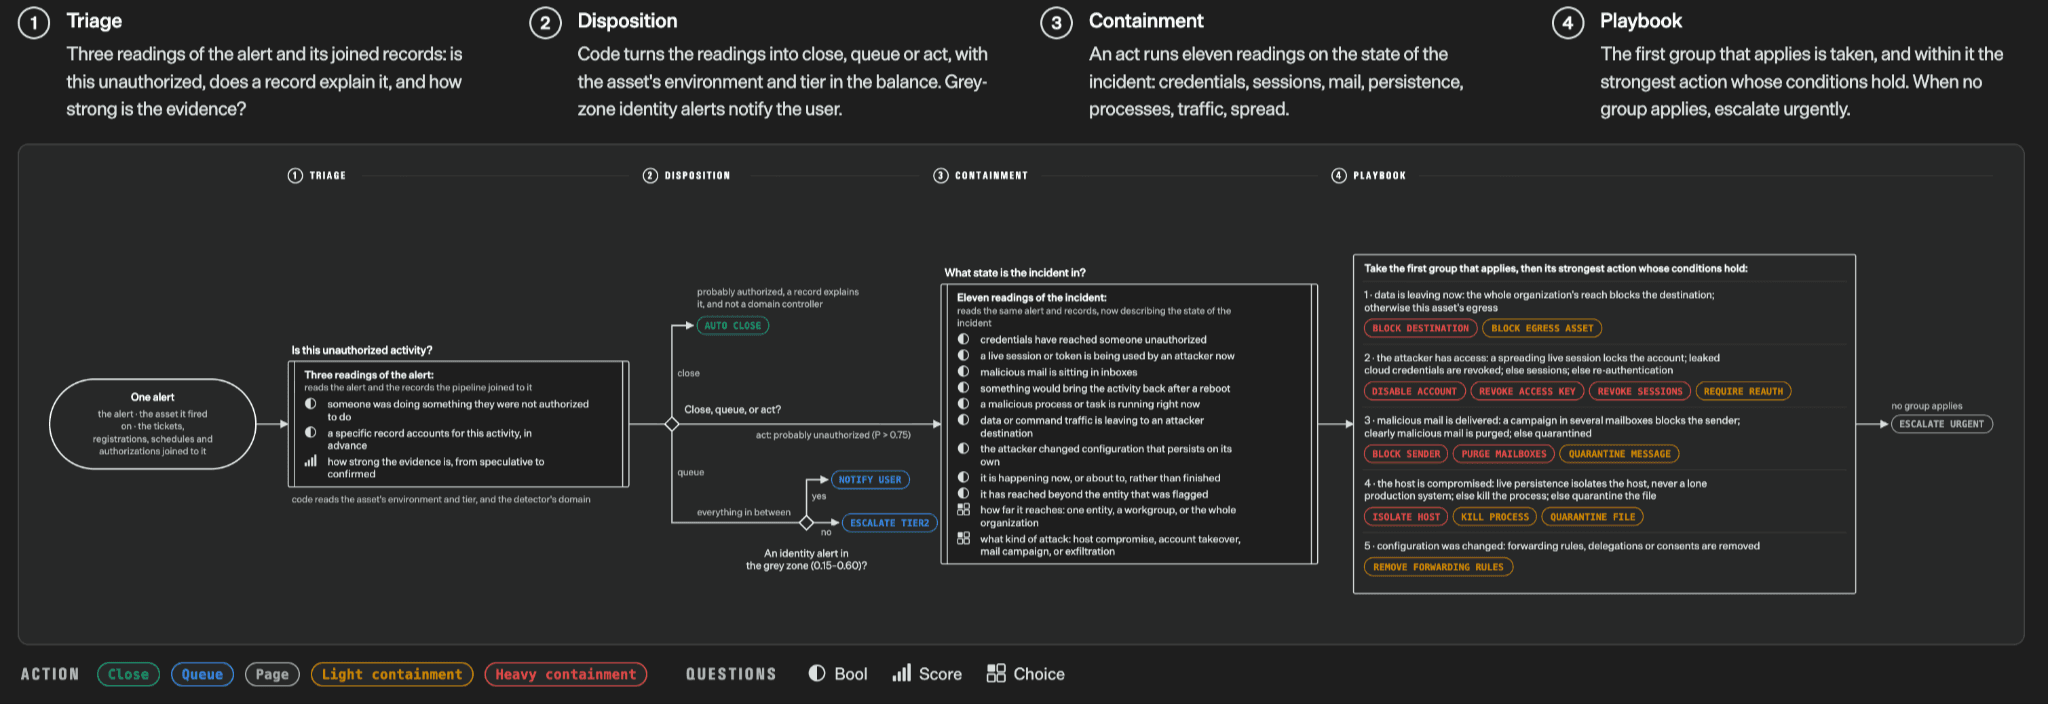
配图:官方发布帖中 4 条评测工作流里最简单的一条——安全告警的 triage / disposition / containment / playbook 四段判断链,每一步都是 Jev 的 Choice 或 Score 问题。图片来自 TypeSafe AI 官方发布帖,版权归 TypeSafe AI 所有。
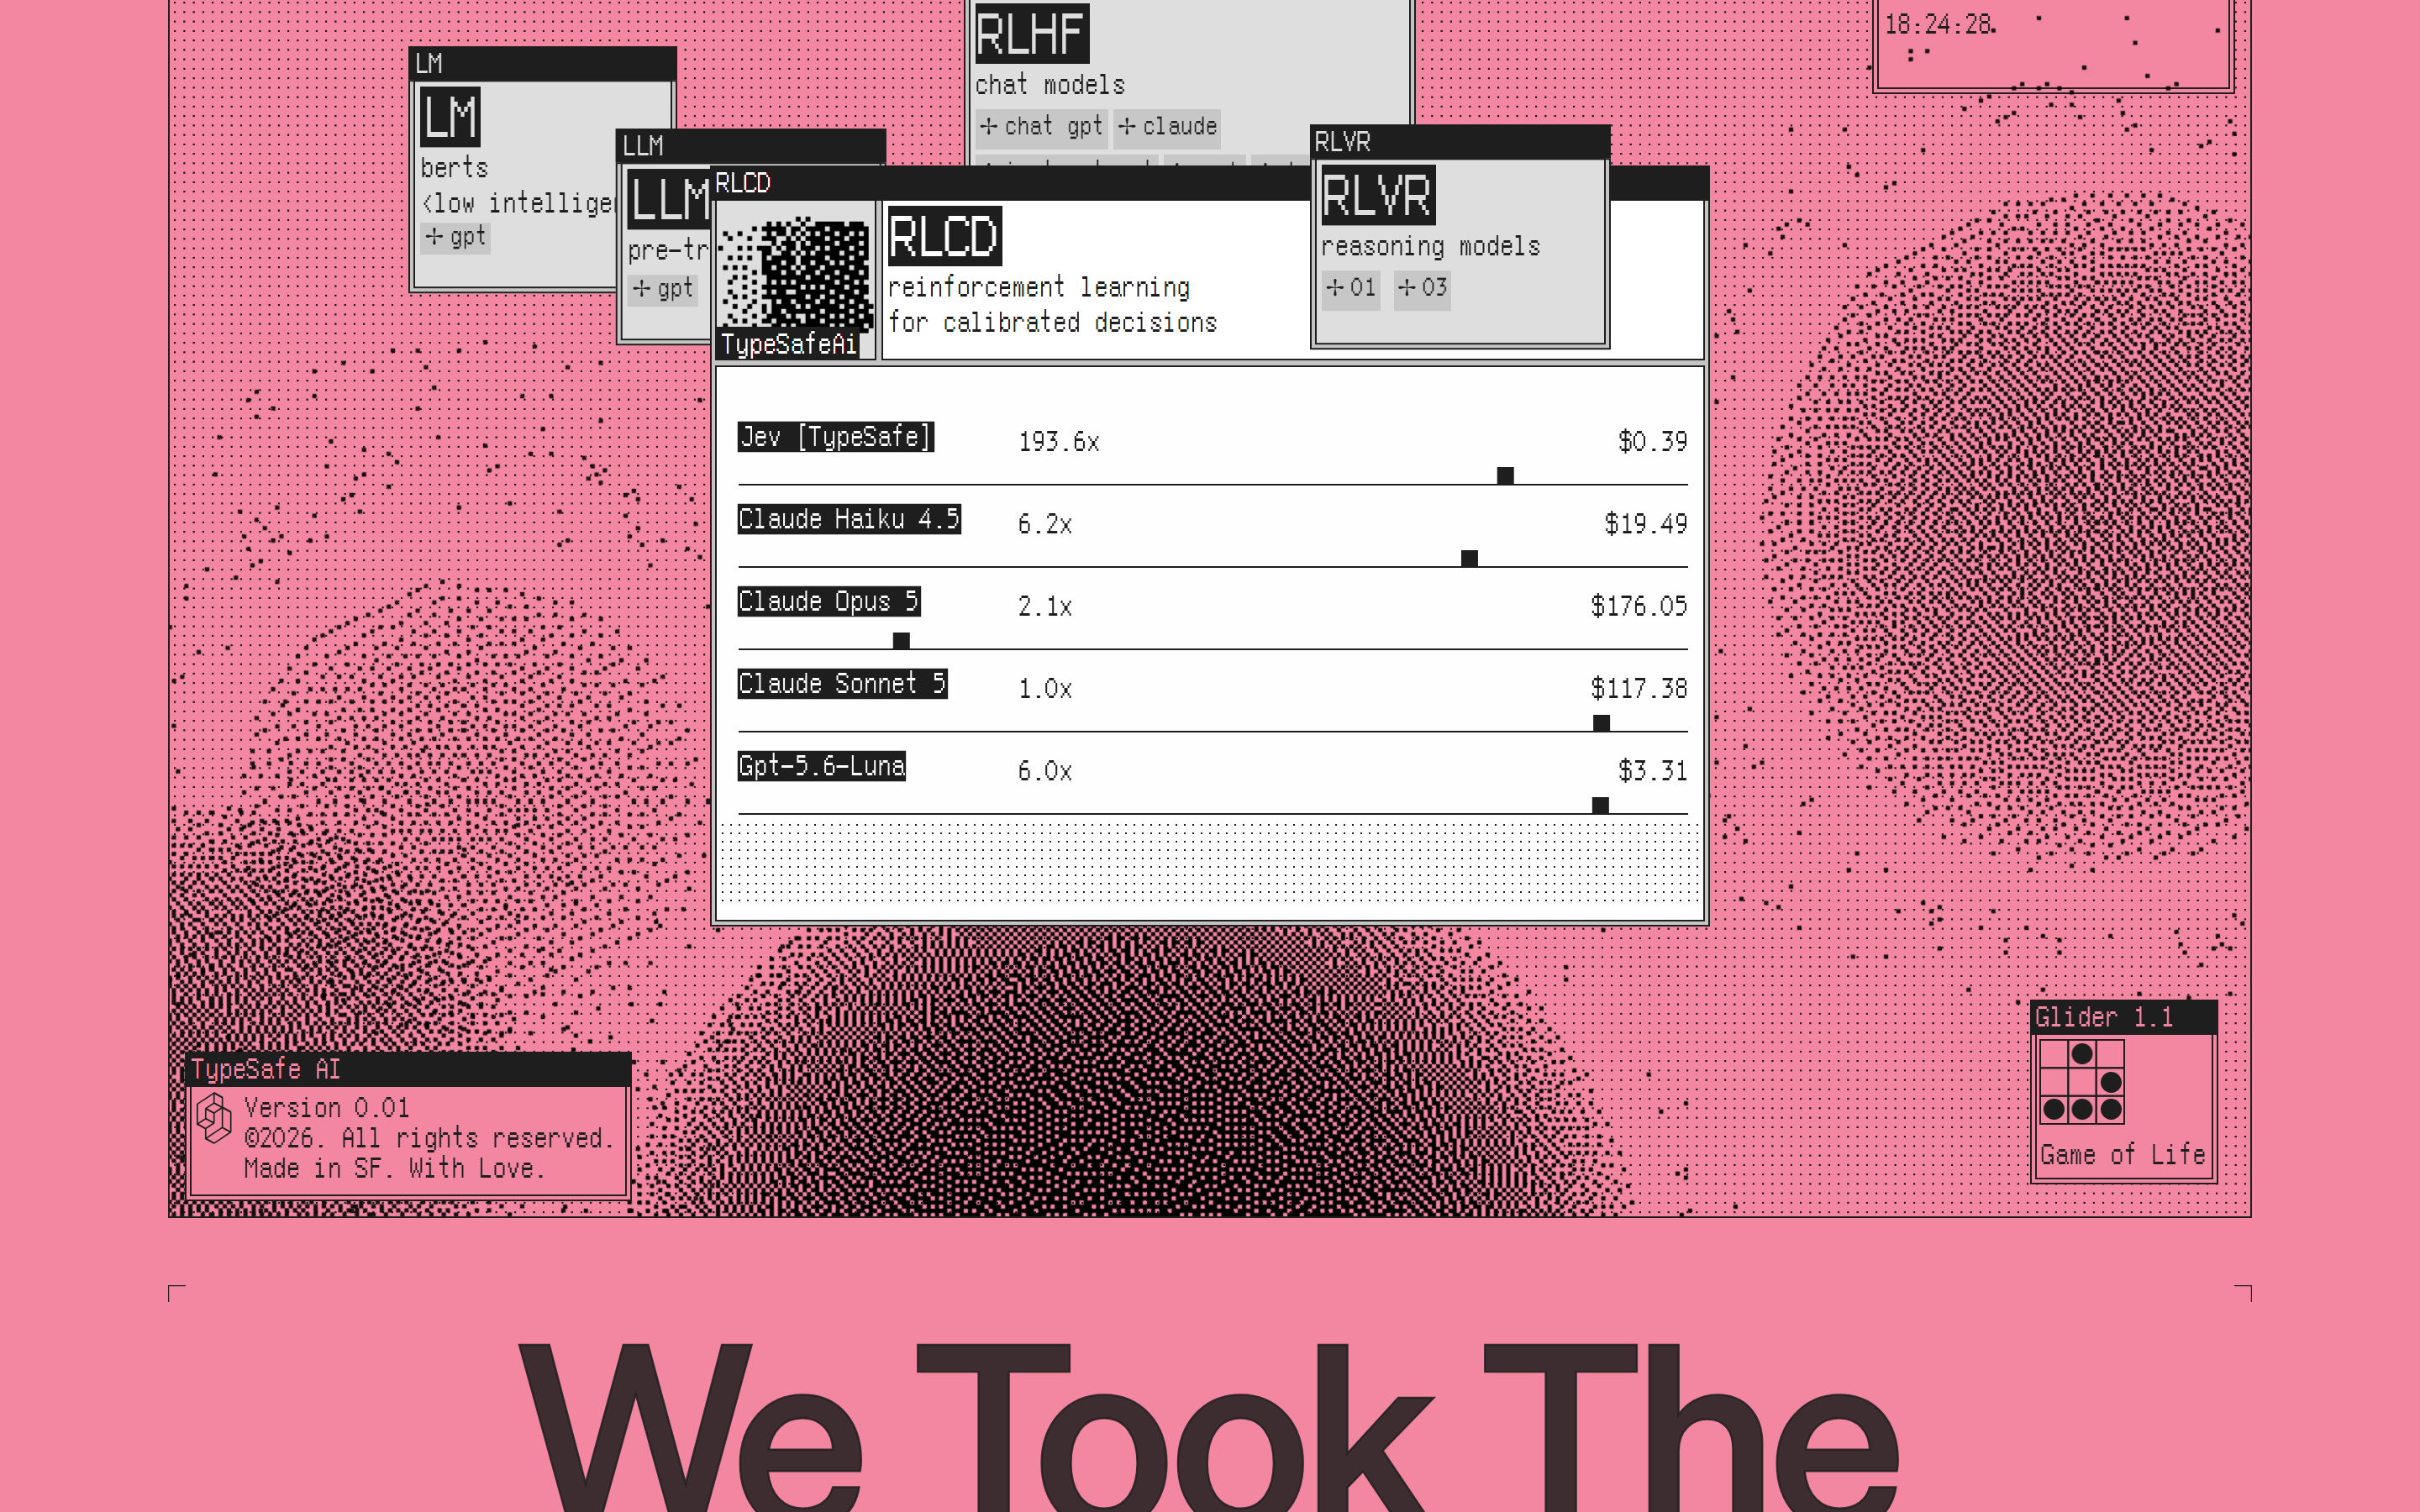
配图:TypeSafe 官网首页的基准对比面板(动效截图):Jev 显示 193.6× / $0.39,其余对比模型为 6.2×–1.0×、$176–$3 量级。图片为官网截图,版权归 TypeSafe AI 所有。
官方自己承认的短板:9 类失败模式
Jev 1.13 的文档里有一页专门叫 jaggedness(凹凸不平之处),是这次发布里最值得读的部分之一:官方把已知的失败模式一条条列出来,并给出替代做法。
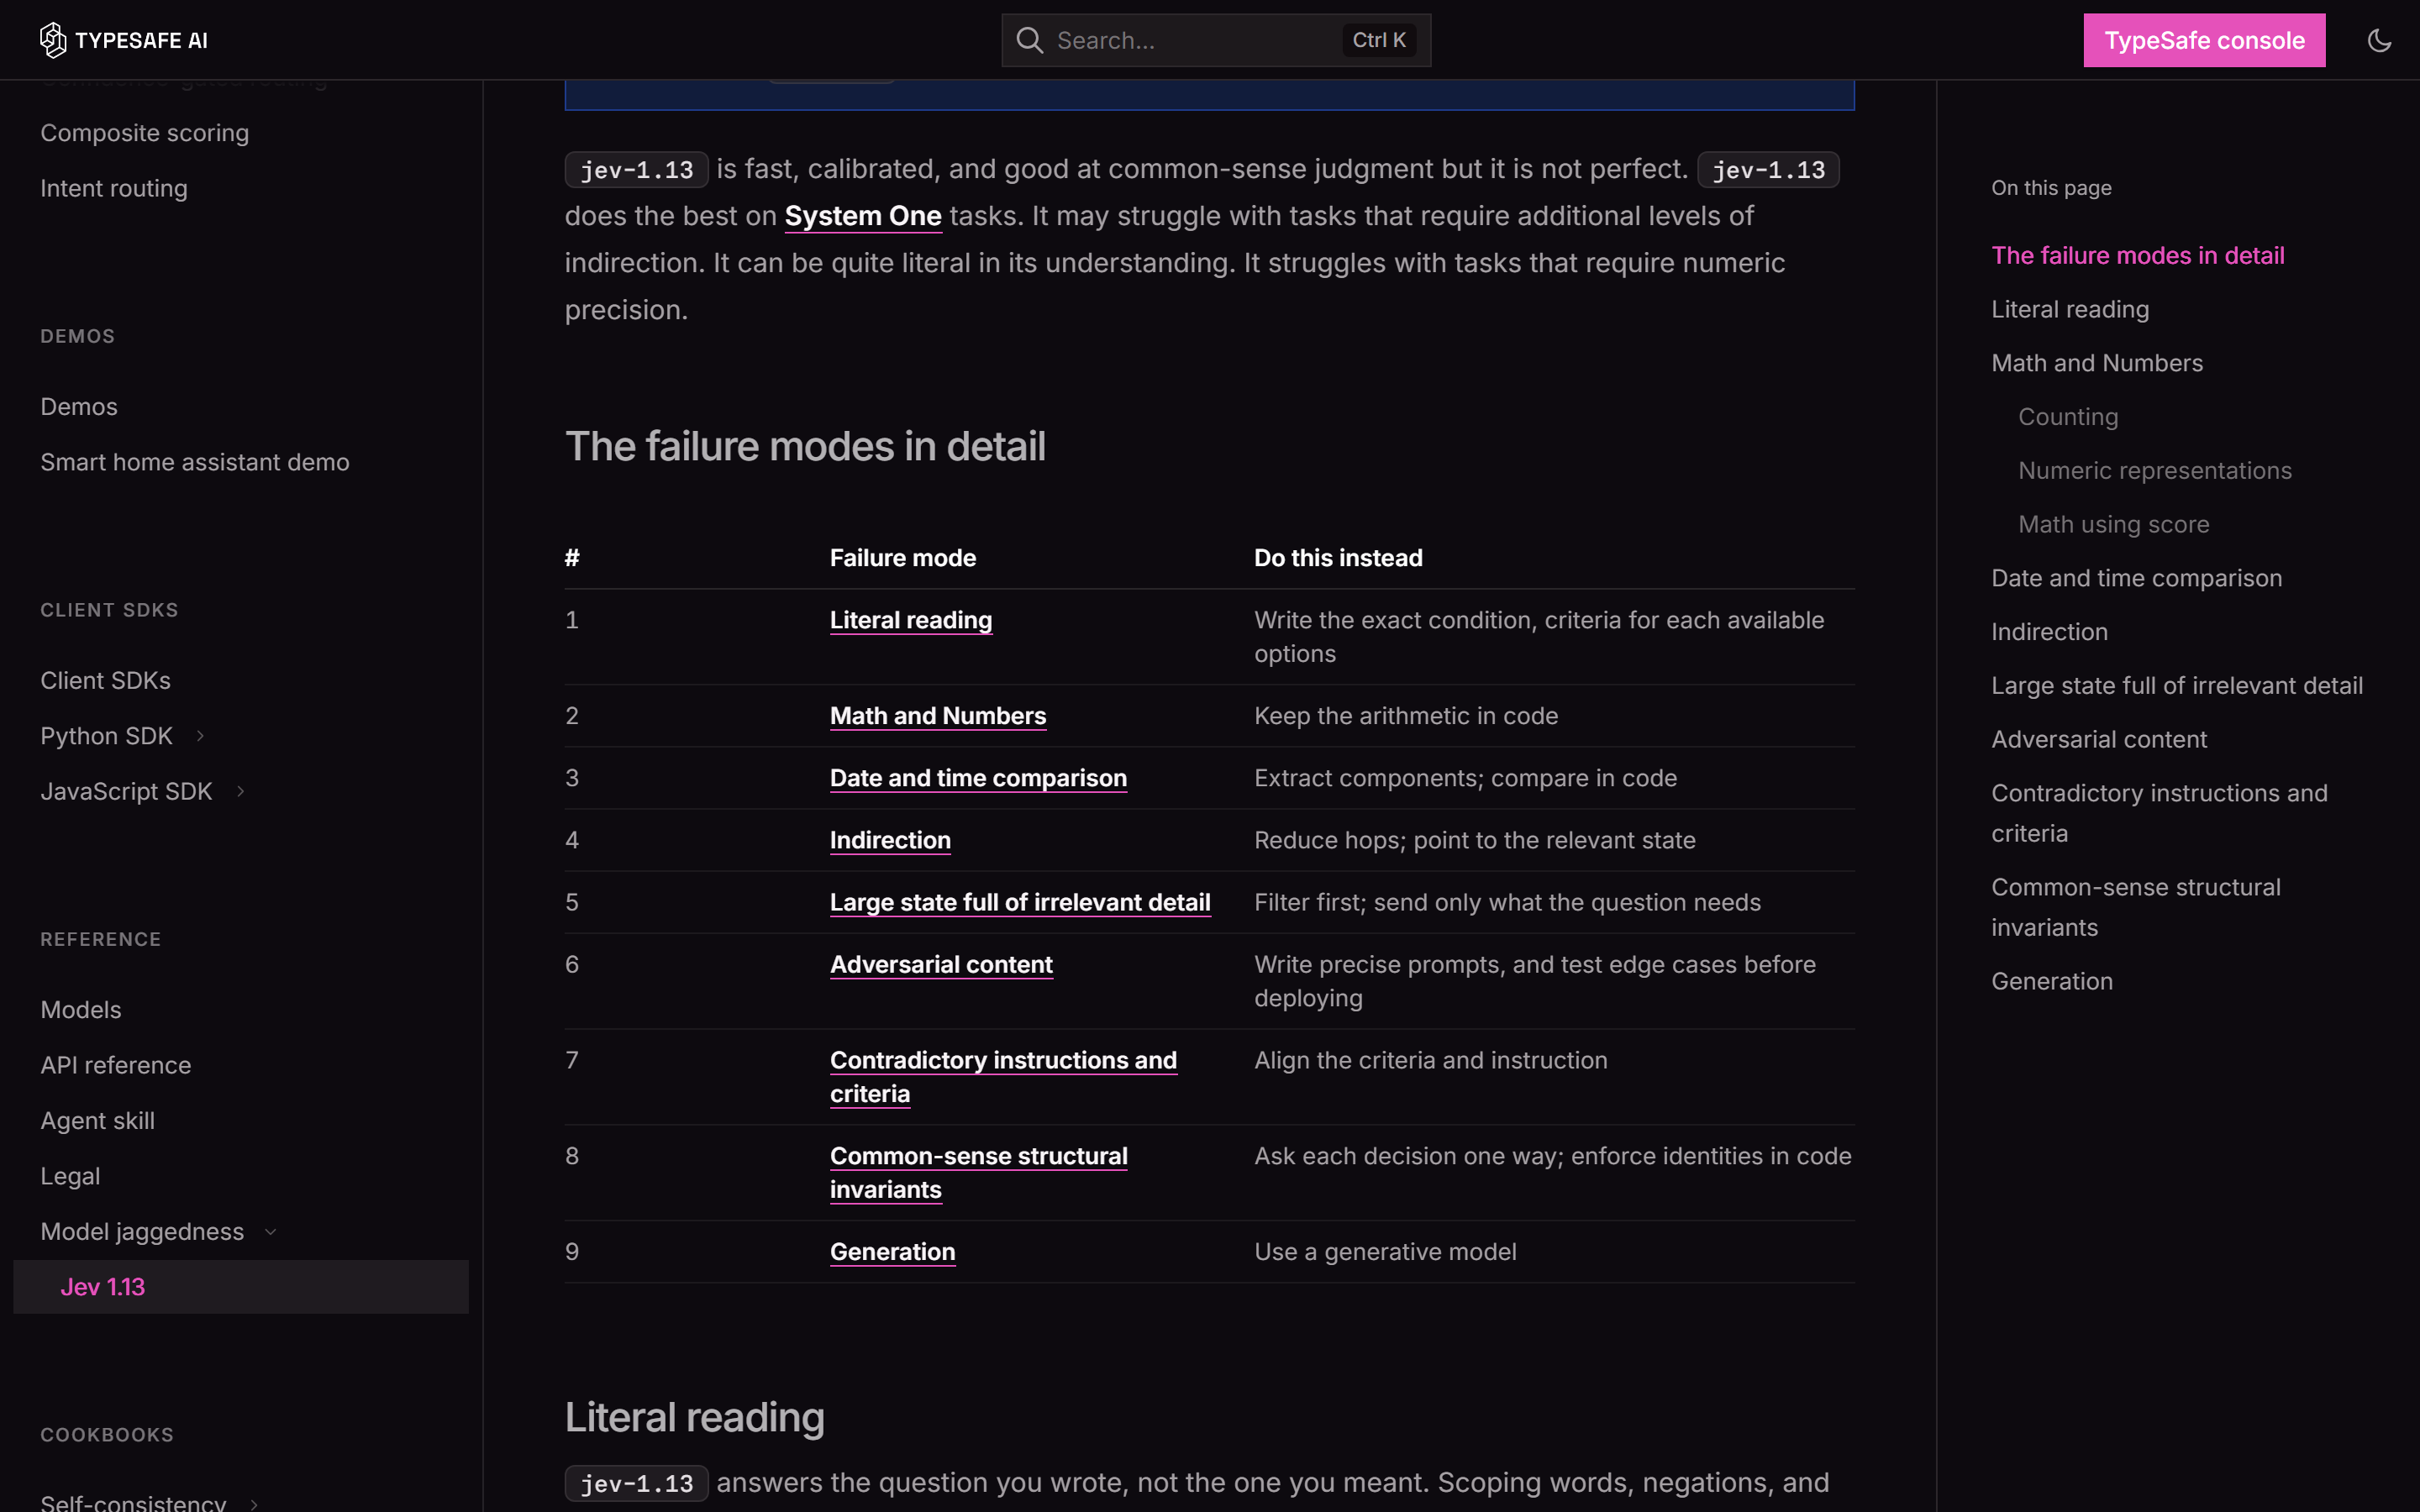
配图:官方文档 Jev 1.13 jaggedness 页面,9 条失败模式与推荐替代做法。图片为 TypeSafe 官方文档截图,版权归 TypeSafe AI 所有。
| # | 失败模式 | 官方建议 |
|---|---|---|
| 1 | 字面理解(只回答你写的字面问题) | 把精确条件、边界情形写进 instructions 与 criteria |
| 2 | 数学与数字 | 算术留在代码里 |
| 3 | 日期与时间比较 | 拆出年月日等成分,比较交给代码 |
| 4 | 多跳推理(间接指代、双重否定) | 减少跳跃层级,直接点名 state 里的字段 |
| 5 | state 里塞满无关细节 | 先在代码里过滤,只送问题需要的字段 |
| 6 | 对抗性内容(prompt 注入式操控) | 明确写清 criteria,上线前测边界用例 |
| 7 | instructions 与 criteria 相互矛盾 | 把 criteria 当作 instructions 的延伸,措辞对齐 |
| 8 | 「常识性结构不变量」不成立 | 别指望 Noul 与 Choice 之间的概率能互相换算 |
| 9 | 生成 | 要生成文本,就去找生成模型 |
其中第 8 条尤其值得记:官方实测,同一个问题「客户是否要求退款?」用 Noul 问得到 0.22,用二值 Choice 问得到 yes 0.01 / no 0.99(confidence 0.97);换个提问方式,P(退款) = 0.72 而 P(非退款) = 0.47,两者相加 1.19。也就是说,别把 Noul 上调好的阈值直接搬到 Choice 上,也别指望模型满足概率上的恒等式。
文档还明确点出 Jev 存在 context rot:state 越长、无关内容越多,准确率越低。
争议:1900 分底下,大家在拆什么
Hacker News 的讨论同时是这次发布最热烈的传播和最集中的批评现场。三类质疑最有代表性:
第一类:拆「不能幻觉」这个说法。 官方口径是「Jev 不给字符串、只返回类型安全的取值,所以不会幻觉」。评论区立刻在语义上做了分割:如果模型可以给出 0.95 的置信度然后判错,那和「自信地胡说」有什么区别?也有人站官方那边——「幻觉」指凭空造出无依据的内容,而 Jev 连造这个词的能力都没有;判断错了就是判断错了。官方自己在文档里的措辞其实更严谨:零类型错误是架构性质,校准说的是「0.8 的预测在大量样本里约 80% 正确」,不构成对单次答案的保证。
第二类:这不就是结构化输出吗? 反对意见认为主流模型的 JSON schema / 约束解码已经能给出合法枚举,Jev 只是更快更便宜;支持方的回应是——结构化输出给你一个值,Jev 给你值的分布,有了分布才能做「自动执行 or 转人工」的门控,这才是它能进生产系统的地方。
第三类:算不算「前沿模型」。 有评论认为把它放进 frontier 一栏是营销称谓;也有评论说它探索的是一条不同的刻度——不是「更聪明」,而是「单位时间能做出多少可依赖的判断」。
另有一种更宏观的读法(Forkast 的分析):Jev 的价值不在取代 LLM,而在押注未来的 agent 栈是模块化的——高频、低复杂度的判断交给专用原语,前沿 LLM 只负责真正需要推理的少数调用。
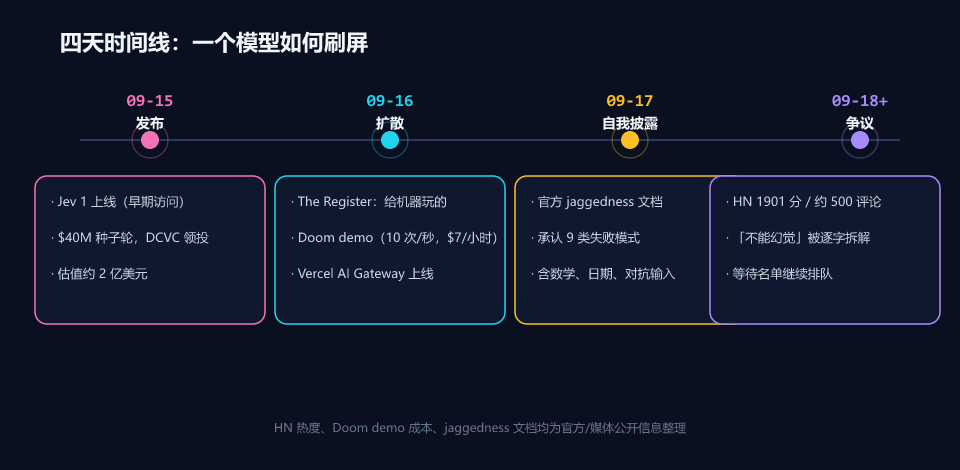
配图:从 9 月 15 日发布到 HN 争议的时间线,依据官方发布帖、The Register 报道、官方文档与 HN 讨论帖整理。
该不该上手:一份判断清单
适合先试的:任何一个你现在用 LLM 做的、输出是「几个选项里的一个」或「一个分数」的调用——工单分流、告警定级、内容审核前置、发票/回执字段核对、RAG 段落相关性过滤、给别的模型输出打分。这类调用通常占账单的比例不小,但复杂度低、失败可兜底,是最划算的试点。
先别碰的:需要推理与生成的任务(写代码、写文档、总结长文)、需要算术与日期比较的任务、需要模型自己规划多步的任务、以及需要图像/音频输入的场景(Jev 目前只吃文本)。
上线前务必做的三件事:① 把宽泛的判断拆成原子问题,用代码做加权组合,而不是把一长串要求塞进一条 instructions;② 把 confidence 门控写进流程——低置信直接转人工,别让它「猜」;③ 用你自己的数据先跑一批,观察校准是否成立(官方也承认阈值要按你的领域调)。
结语
Jev 不会写邮件、不会总结文档、不会解释报错栈——它连一个句子都不会造。它要做的是把过去两年里大量「用大炮打蚊子」的 AI 调用,换成一种软件真正能依赖的接口:明确的取值、诚实的概率、毫秒级的响应和便宜到可以到处用的价格。
它现在还很小:只吃文本,上下文有限,数学要你自己算,官方自己列了 9 条失败模式,第三方评测也还来不及出现。但它的方向值得记一笔——如果连判断本身都能变成一个类型,那 AI 走进普通软件的方式,可能不是聊天窗口,而是一行 if。
数据来源:TypeSafe AI 官方发布帖《Introducing System One Models & Jev》(2026-09-15);TypeSafe 官方文档(Jev 1.13 jaggedness / Primitives / Confidence / AI primer / Models 页面,docs.typesafe.ai);The Register《TypeSafe AI debuts model for machines that plays Doom》(2026-09-16);Vercel Changelog 与 AI Gateway 模型页(2026-09-16);DCVC 融资公告与 BusinessWire 新闻稿;Hacker News 讨论帖(1901 分、约 500 条评论);Forkast 分析《TypeSafe AI’s Jev Is Not an LLM — And That May Be the Point》;Techmeme、SiliconANGLE、WindowsForum 等媒体报道。文中所有性能与价格数字均来自官方公开口径,尚未有独立的第三方复现。
配图说明:官网/文档截图与官方发布帖图表均下载自 TypeSafe AI 官方站点(typesafe.ai / docs.typesafe.ai / jevai 相关页面),版权归 TypeSafe AI 所有,此处用于新闻报道与评论;流程图、杰文斯悖论示意图、时间线与封面为本站自制。


