一句话总结
10 月 9 日,TypeSafe AI 宣布以 75 亿美元估值融资 8.7 亿美元,由 Andreessen Horowitz 领投,红杉与老股东 DCVC 跟投。此时距离它的模型 Jev 公开发布只过了 三周。这轮估值的核心不是「更聪明的聊天模型」,而是一个反方向的赌注:Jev 不输出文本——它输出的是概率,公司称之为「校准过的决策」,官方自报比现有 LLM 快两个数量级、且不会幻觉,并称已有三分之一财富 500 强企业在用。当整个行业还在比谁的模型话说得更像人的时候,这家公司靠「不说人话」拿到了融资。
数据来源
本文事实来自:TechCrunch 报道《The maker of non-text AI model Jev valued at $7.5B just weeks after launch》(2026-10-09),融资额、估值、投资方、联合创始人履历与「三分之一财富 500 强」的采用比例均出自该报道;TypeSafe 官方发布文《Models & Jev》(作者为联合创始人 Diogo Almeida,发布时间对应 2026-09-15 的公开发布),模型架构、训练方法、RLCD、「两个数量级」与「不会幻觉」等表述出自该文;文中的准确率-成本图为该官方发布文所附图表。凡属公司自报的技术主张,本文均标注「官方称 / 自报」,与第三方可核实的融资事实分开表述。
三个已经发生的事实
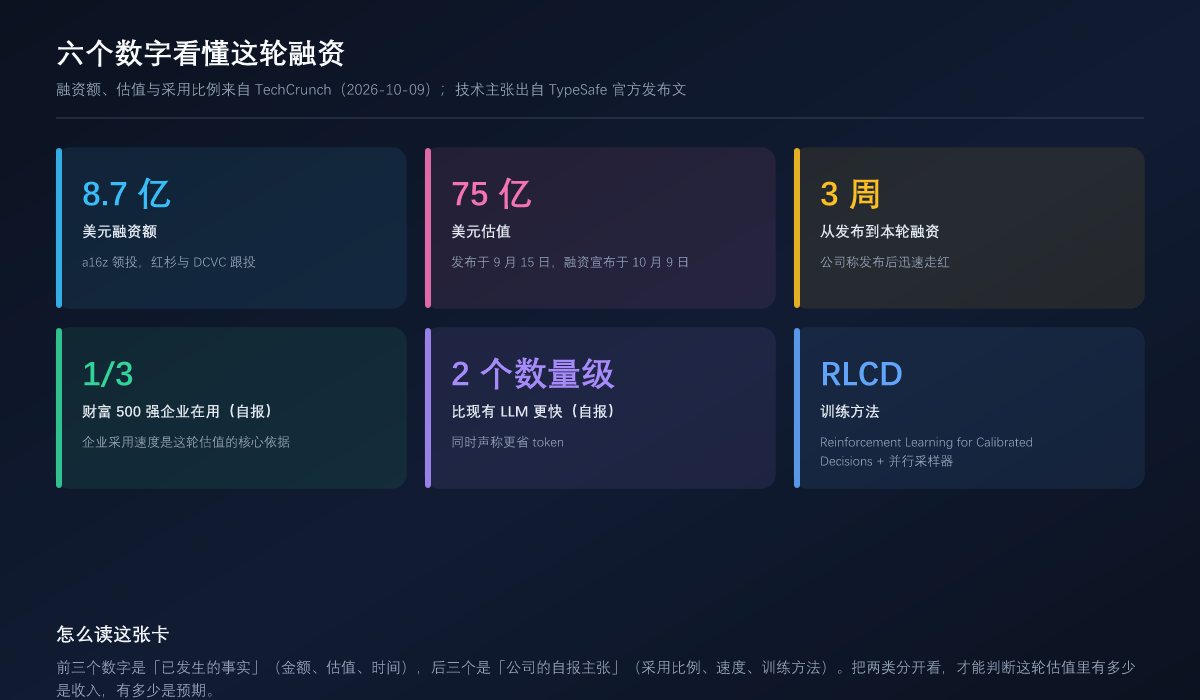
第一,钱和估值是真的。 8.7 亿美元融资、75 亿美元估值,由 a16z 领投,红杉与 DCVC 跟投。这是 TechCrunch 报道的第三方信息,不是公司自己发在官网的宣传数字。
第二,速度是反常识的。 Jev 在 9 月 15 日才公开发布并处于早期访问阶段,融资在 10 月 9 日宣布。三周。即便在现在这个融资节奏里,这个时间差也属于极端值。
第三,企业采用的说法来自公司自己。 「三分之一财富 500 强企业已经在用」是 TypeSafe 的表述,TechCrunch 用的是「公司称」的措辞。注意这里的区别:财富 500 强「在用」可以是一条业务线的一个试验项目,也可以是一个全面上线的生产系统,这两种情况相差三个数量级。
团队构成值得一提:联合创始人 Diogo Almeida 此前是 OpenAI 的研究员,Sasha Sheng 是前 Meta 研究工程师,Erik Gafni 是工程师兼创业者。公司在 2024 年成立,也就是说 Jev 是两年潜行之后的第一款公开产品。
「不输出文本的模型」到底是什么意思
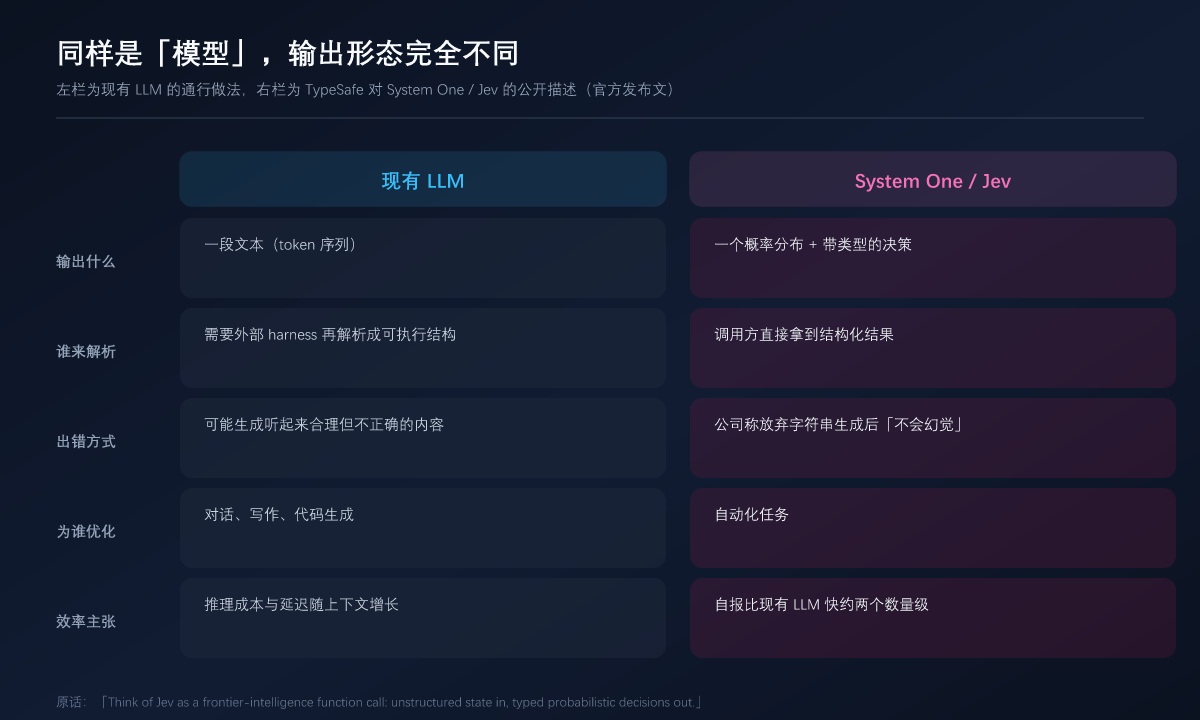
要理解这轮估值,得先理解这句话。Jev 基于 transformer 架构,但它不是大语言模型——差别不在骨干网络,而在输出层:
- 现有 LLM 输出的是标记(token)序列,也就是一段文本。要让它去驱动软件,中间必须再加一层 harness 去解析这段文本,把它变成程序能用的结构。
- Jev 直接输出概率,公司称之为「calibrated decisions」(校准过的决策)。按官方发布文的说法,Jev 放弃了字符串生成,换取了「优化过的结构化输出」,并且因此「不会幻觉」——因为它不再生成自然语言句子,也就不存在「编出一句听起来合理的话」这个失败模式。
Diogo Almeida 在接受 TechCrunch 采访时的解释是:「我们在人类语言这件事上做得很好了四年,但它对自动化没用,因为计算机说的是另一种语言。」官方发布文里给了一个更准确的说法:
把 Jev 理解成一个「前沿智能的函数调用」:非结构化状态进,带类型的概率决策出。
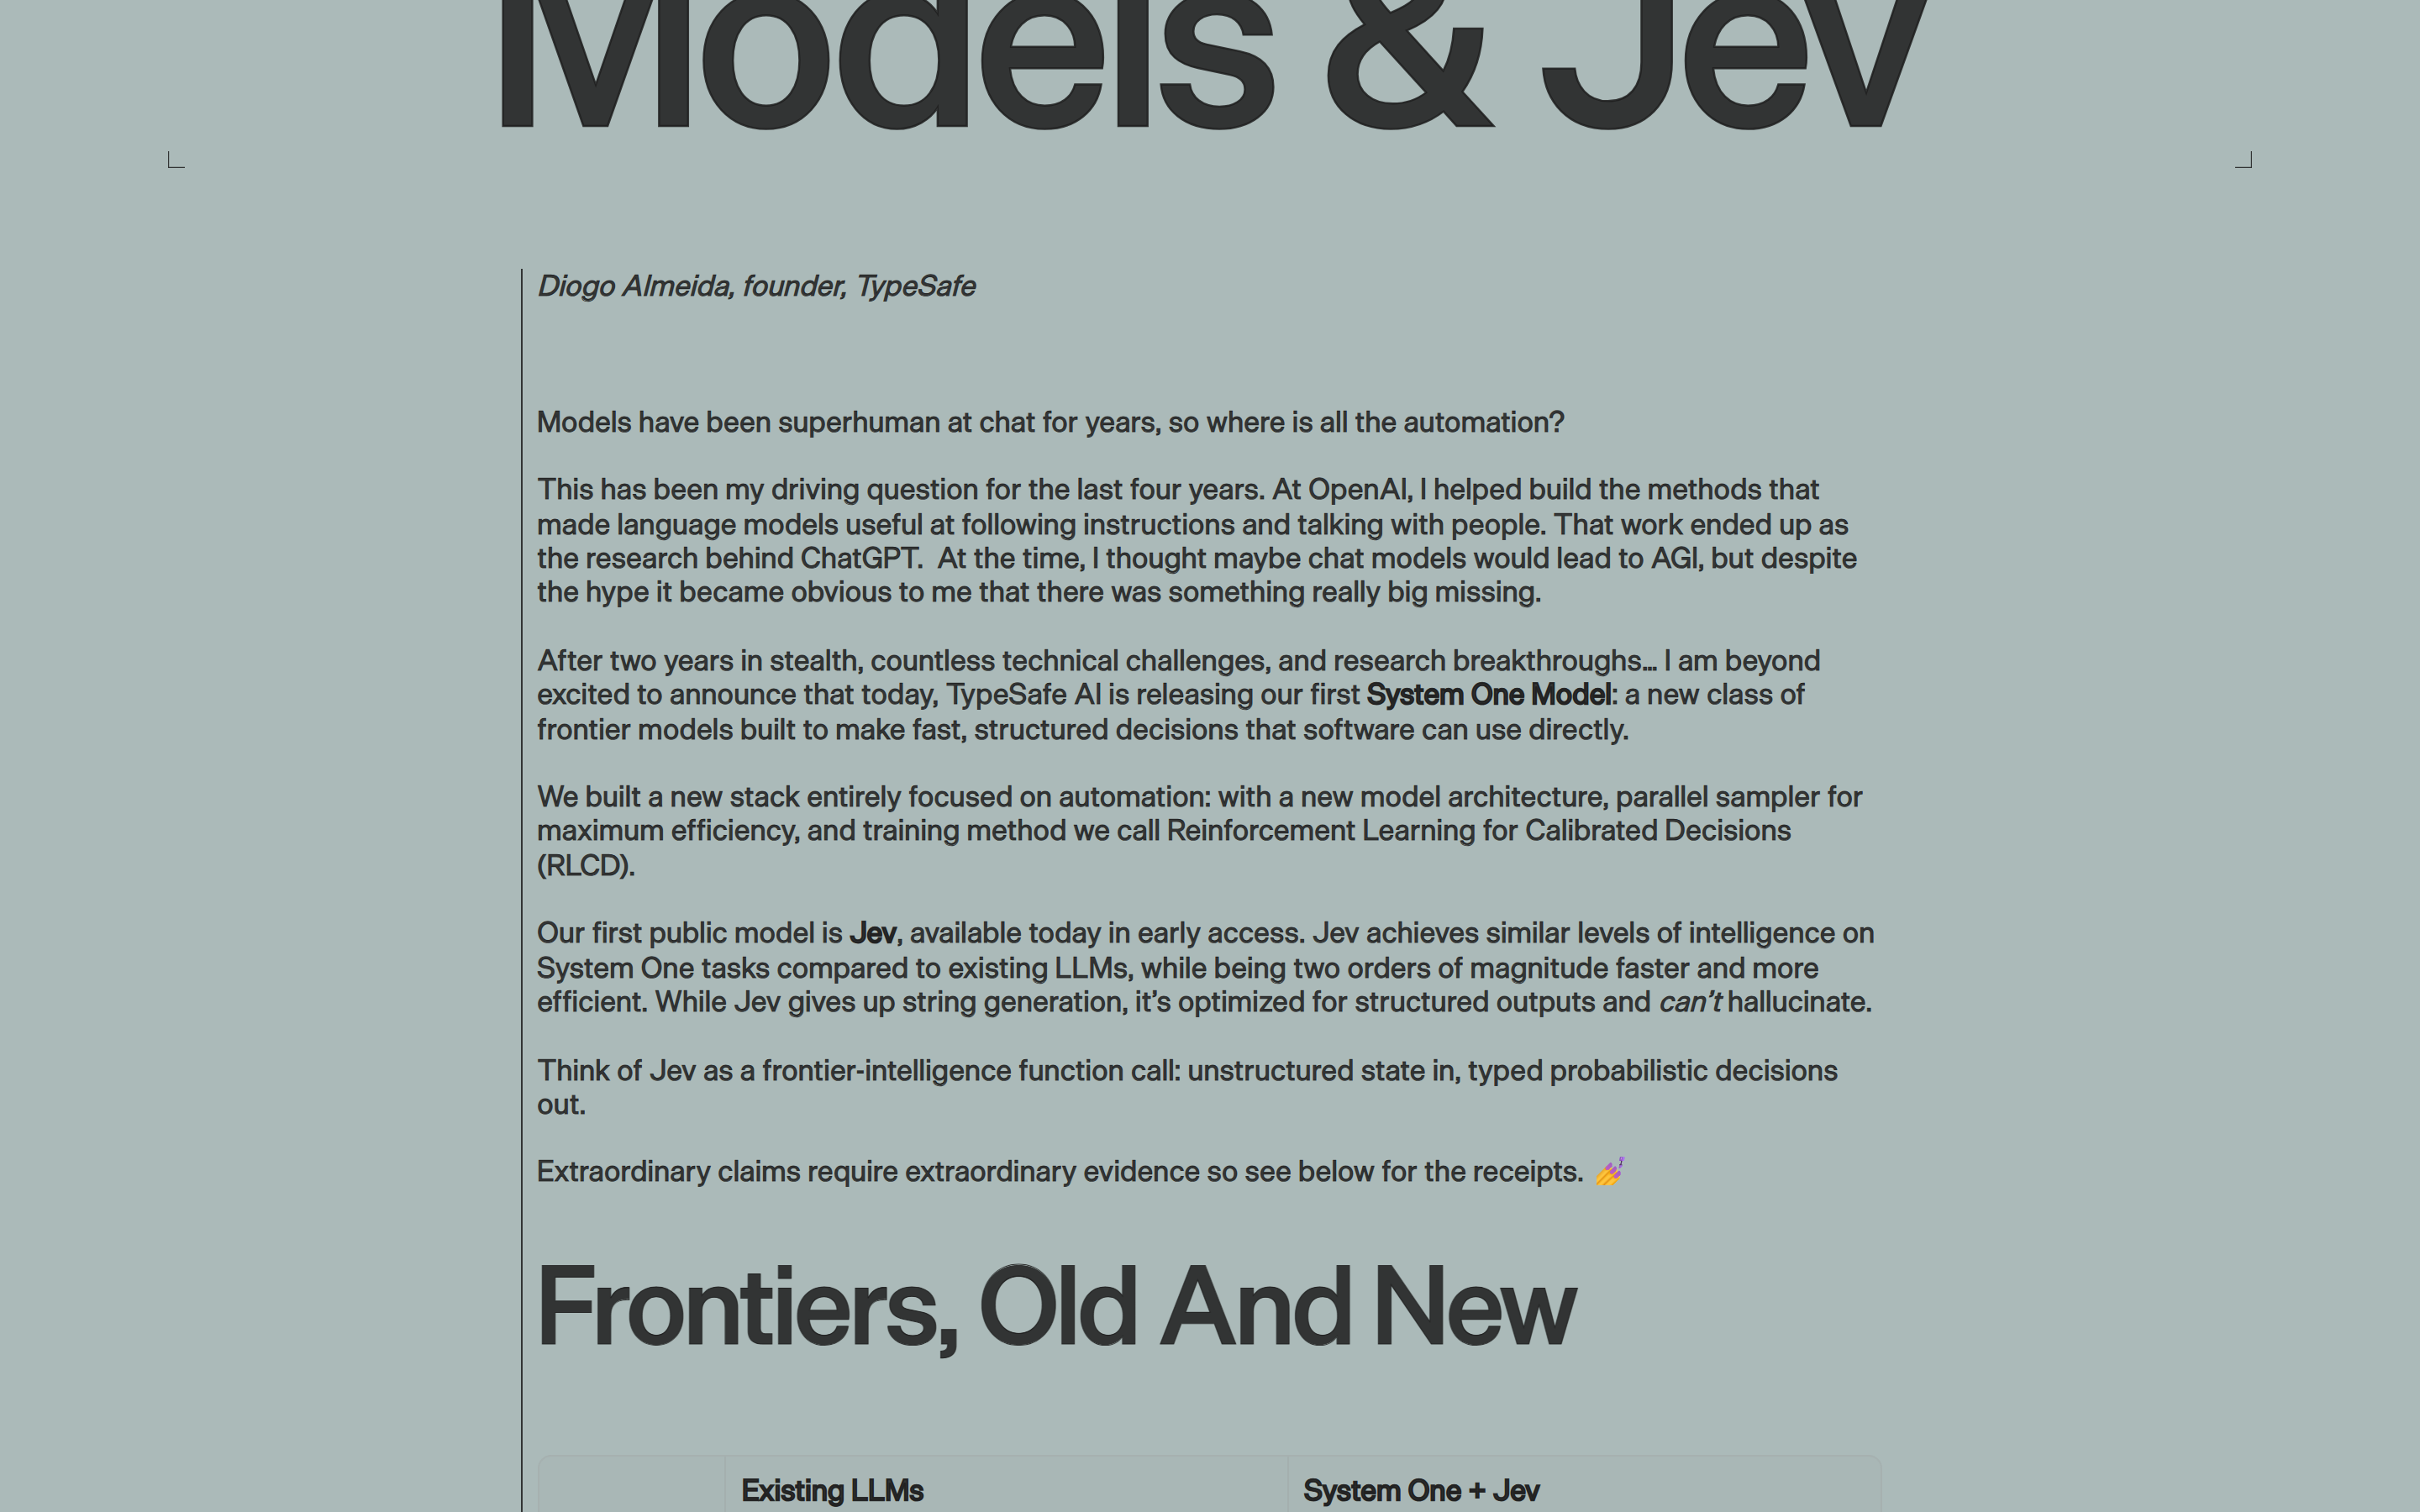
发布文里还写了技术栈的三件套:新的模型架构、为了最大化效率的并行采样器(parallel sampler)、以及一种训练方法 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。同时官方也承认了一个代价:Jev 在「System One 类任务」上的智能水平与现有 LLM 相当——注意是「相当」,不是「更强」,它的卖点从来不是智力上限。
官方给出的效率证据
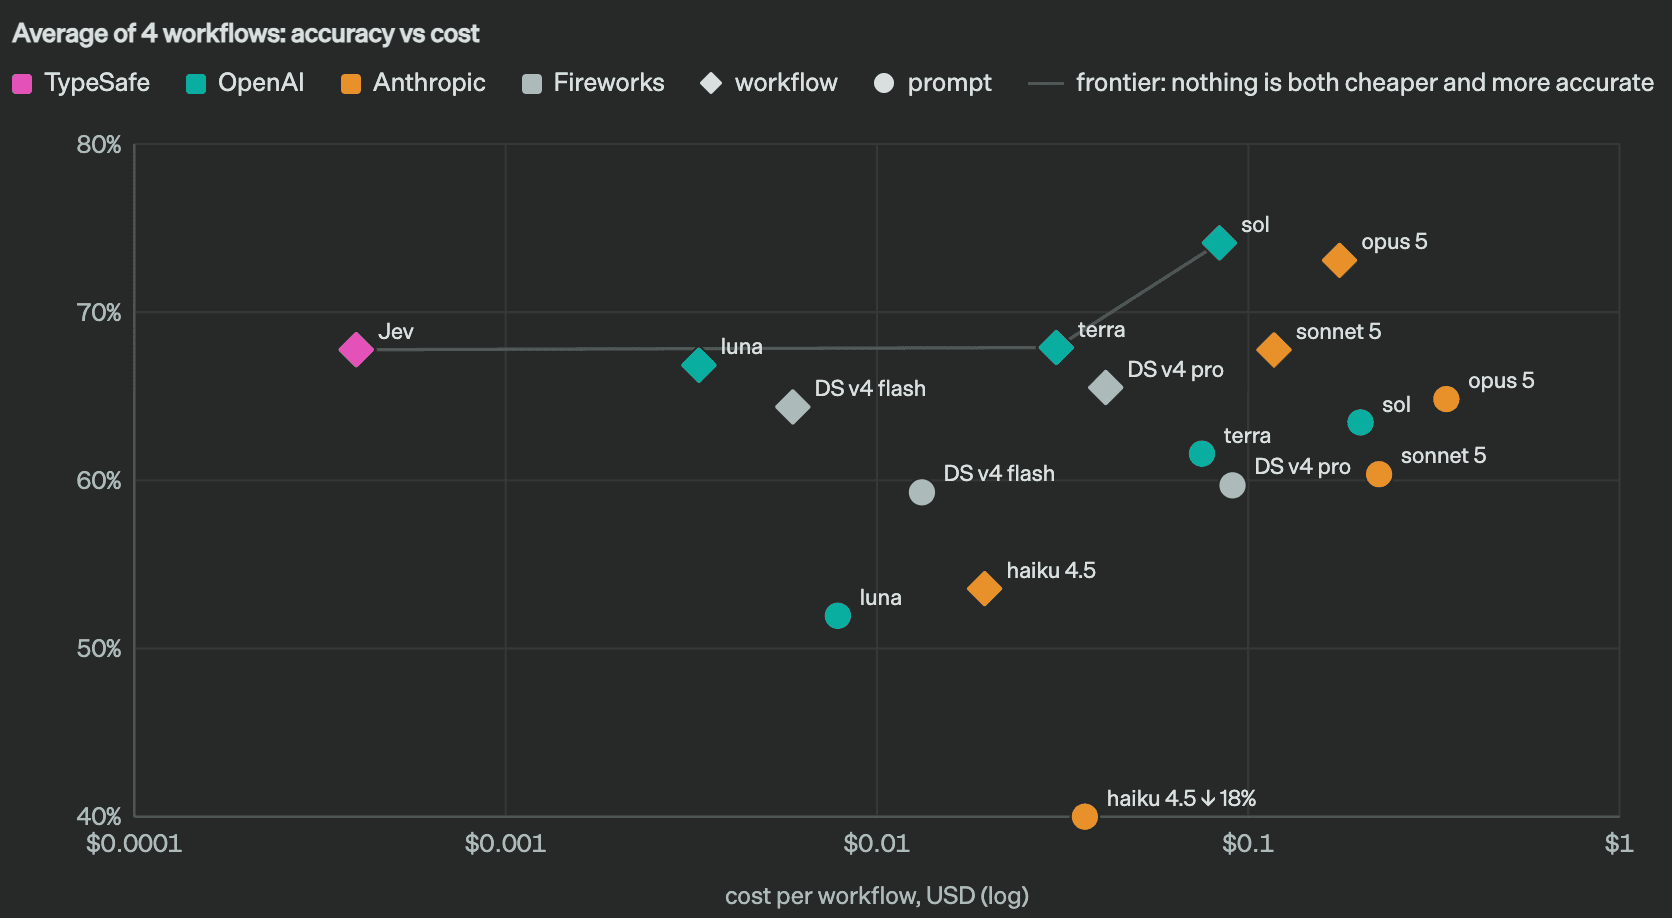
这是官方发布文里最有说服力的一张图,也值得逐条读清楚:
- 横轴是「每个工作流的成本」(对数刻度,从 $0.0001 到 $1);纵轴是准确率(40% 到 80%)。
- Jev(粉色)位于横轴最左端,成本落在约 $0.001 这一档,准确率约 67%。
- 图上的对照组包括 OpenAI(青色:luna / sol / terra)、Anthropic(橙色:opus 5 / sonnet 5 / haiku 4.5)以及 Fireworks 上的 DeepSeek 系列(灰色:DS v4 flash / v4 pro)。
- 官方画出的「前沿线」含义很明确:当时没有任何一个模型既比 Jev 便宜、又比 Jev 更准。
怎么读这张图才不算被带偏?它衡量的不是「谁最聪明」,而是「单位成本能换到多少准确率」。把 opus 5 这类模型放在场景里,它们的准确率更高(图上在 70% 以上),成本也高出一到两个数量级。Jev 的赌注是:大量自动化任务的正确答案本来就只需要 67% 那种「够用的准确率」,而成本差两个数量级才是能否规模化的关键。
需要注意:这张图是官方自测的 4 类工作流平均值,横轴成本含了每个工作流的 token 与调用开销。它对「Jev 在自己的评测集上成本极低」这件事是有说服力的,对「换成你的业务场景还是同一结论」则没有保证。
从发布到 75 亿:三周
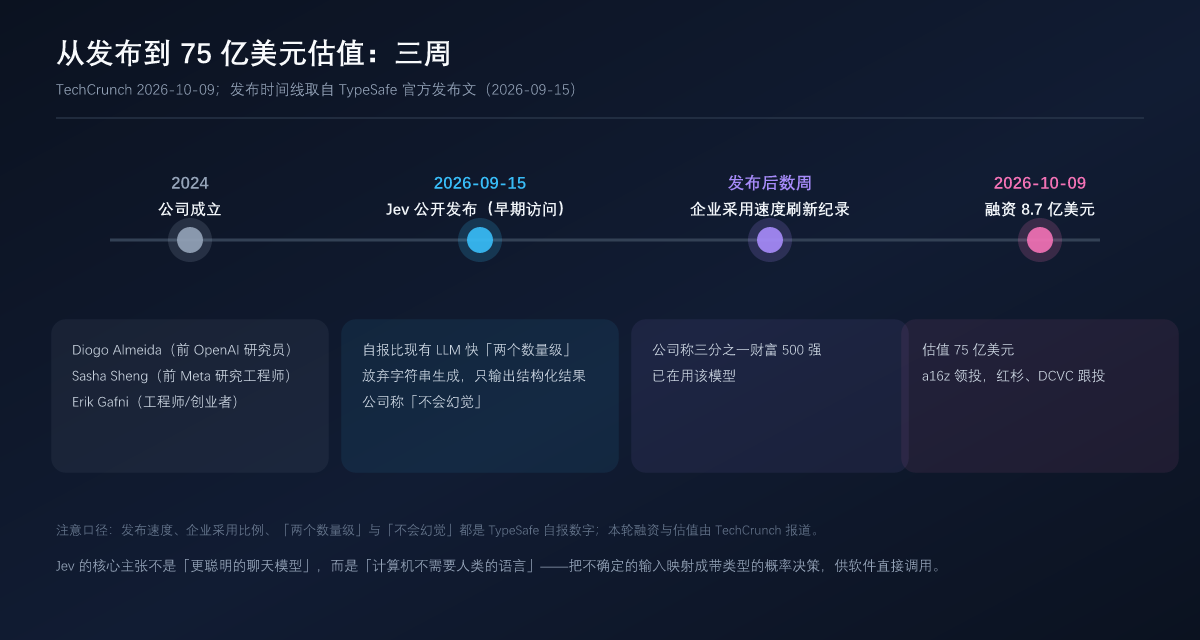
把时间线摊开看,这三周里发生的事情密度很高:2026-09-15 公开发布(早期访问)→ 发布后数周内走红、官方称三分之一财富 500 强在用 → 2026-10-09 宣布融资 8.7 亿美元、估值 75 亿美元。
这里面最值得琢磨的是中间那一段:一个发布三周的模型,凭什么让企业这么快做决定?两种解释都成立——要么是「把文本换成概率」确实解决了它们积压已久的自动化需求(比如之前用 LLM 做自动化时,那一层解析 harness 的开发和维护成本高得离谱),要么是「不做 LLM」这个标签本身的稀缺性,在模型同质化的当下被资本和企业同时放大了。
三个需要打问号的地方
一、「不输出文本」是不是护城河? 概率输出、结构化决策、校准训练——这些都不是不可复制的技术。真正难的是把它做成一门生意:同时提供足够低的延迟、足够好的校准质量,以及企业愿意接入的接口形态。如果这是工程化优势而非原理性优势,那么它被复制的速度会和被接受的速度一样快。
二、三分之一财富 500 强的「在用」,不等于收入。 早期访问阶段的采用往往价格极低甚至免费。从「在用」到「按量付费并续费」之间,隔着一次完整的采购流程和一次效果验证。 75 亿美元估值里,有多少对应已经发生的收入,有多少对应未来的预期,是无法从融资公告里看出来的。
三、「不会幻觉」是一个关于输出形态的陈述,不是一句关于正确性的保证。 放弃生成自然语言,确实消除了一种失败模式(编造听起来合理的句子);但概率决策同样会出错——它会给出一张标着高置信度的、错误的牌。「不会幻觉」在这个语境里的准确含义是「不会编句子」,而不是「判断总是对的」。 这一点在把 Jev 接进有真实后果的流程之前,必须自己想清楚。
对使用者意味着什么
如果你在做 AI 应用,这轮融资传递出三个可以直接用上的信号:
- 「把 LLM 的输出解析成结构化数据」这一层,正在被专门的产品替代。 这一层此前是每个自动化项目最脏、最难维护的部分——prompt 一改,解析器就崩。独立做一个「输出即结构」的模型,等于把这一层的维护成本从应用方转移到了模型方。
- 成本和准确率的权衡,比准确率的绝对值更值得算清楚。 官方那张图最有价值的部分不是 Jev 的位置,而是它示范了一种评估方式:把你自己的高频工作流列出来,量出「单位成本换多少准确率」的曲线。很多自动化场景里,67% 够用,甚至 60% 够用,只要成本和延迟允许你跑十次再投票。
- 选型时要区分「模型能力」和「产品形态」。 Jev 不是更强的模型,而是不同形状的模型。这提醒我们:在同一个「AI」标签下,模型正在按输出形态分裂成不同的品类——有的负责写,有的负责判断,有的负责执行。下一轮的工具选型,很可能不是「选哪个模型」,而是「这道题该交给哪种形状的模型」。
数据来源:TechCrunch《The maker of non-text AI model Jev valued at $7.5B just weeks after launch》(2026-10-09,融资额、估值、投资方、团队履历、「三分之一财富 500 强」采用比例);TypeSafe 官方发布文《Models & Jev》(模型架构、RLCD 训练方法、「两个数量级」与「不会幻觉」等技术主张,及所附准确率-成本图)。
图片出处:封面与示意图由 UU AI Hub 自制;《Models & Jev》发布文页面与准确率-成本图取自 TypeSafe 官方发布文原文。


