一句话总结
10 月 16 日,腾讯混元开源 Hy-Memory 2.0:一个模型(Hy-Memory-30B-A3B)+ 框架(记忆 SDK)+ 应用(MemHub)三层全开源的 Agent 长期记忆方案。它的专用记忆模型在四套记忆系统的综合基准上得分 55.49,反超闭源 Claude Opus 5 的 54.62;四大 benchmark 全部开源框架第一,但存储占用反而更小(29.2 条 vs mem0 的 145.2 条)。核心主张一句话:记忆不是「加长上下文」或「挂个 RAG」能替代的,它是一层可以单独训练、单独评测、单独替换的能力。
数据来源
本文事实依据来自:
- 腾讯混元官方发布页《Hy-Memory 2.0》(memory.hunyuan.tencent.com,2026-10-16)
- GitHub 仓库
Tencent-Hunyuan/Hy-MemoryREADME(含三类记忆场景说明与评测口径) - Hugging Face 模型卡
tencent/Hy-Memory-30B-A3B与技术报告(arXiv:2610.22196) - IT之家、新浪科技、第一财经等中文媒体报道(2026-10-16)
为什么「记忆」是个独立问题
很多人以为给 AI 长期记忆,靠更大的上下文窗口或**挂一个知识库(RAG)**就够了。腾讯混元在发布页里把这两条路都否了:
- 更大的上下文 ≠ 长期记忆:再大的窗口也只在「这一次对话」内有效,关掉就忘、跨会话断档,token 成本还越堆越高。
- 知识库/RAG ≠ 记住「你」:RAG 检索的是文档资料,回答通用知识;它不知道「这个用户是谁、偏好怎么变、上次聊到哪」。
记忆沉淀的是用户本人的事实、画像与意图,并且要随变化更新。这正是 Hy-Memory 想做的那一层。1.0 版(2026 年 5 月,论文里以 DCPM 命名)只覆盖聊天记忆、未开源;2.0 把记忆从「框架里的提示词技巧」升级成了「可单独训练、单独评测、单独替换的能力」,并一次性开源三层。
三层架构:模型、框架、应用各干什么
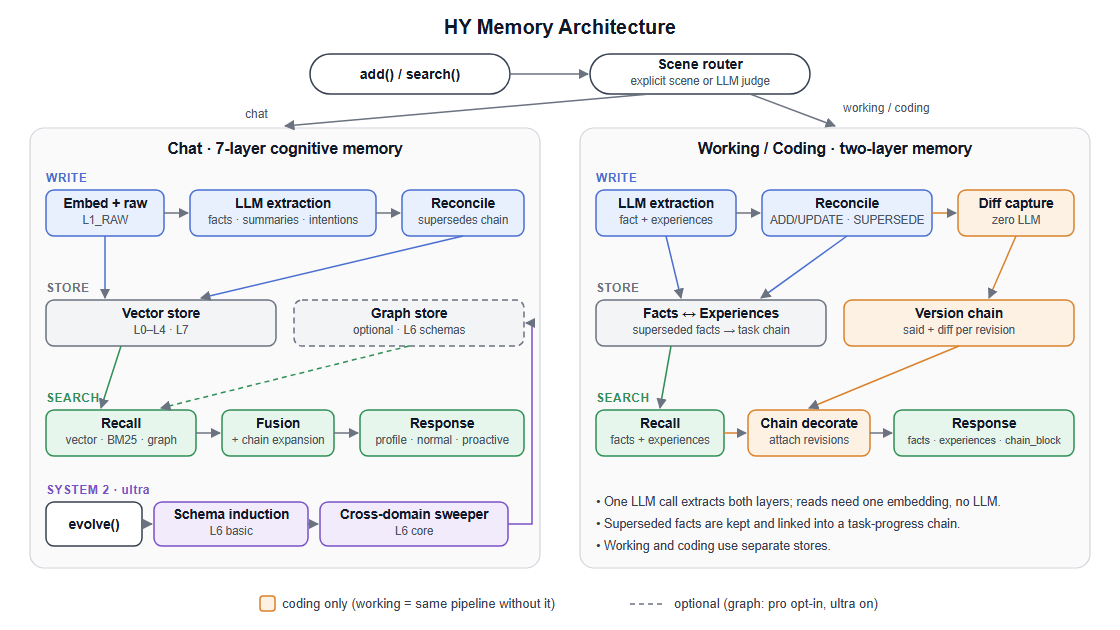
图片来源:腾讯混元 Hy-Memory GitHub 仓库(docs/images/architecture.svg)
① 模型层(Hy-Memory-30B-A3B)——负责记忆的读写。 专为记忆场景训练的 MoE 模型,约 3B 激活参数,负责「从对话里抽取该记住什么、怎么写进记忆、怎么更新」。它不绑定 Hy-Memory 框架,也可以接入 Mem0、MemOS 等其他记忆系统。
② 框架层(记忆 SDK)——负责记忆的存储、更新与召回。 这是 hy-memory Python SDK,把记忆分成三类场景管理:
- 聊天记忆:从「零散事实」升级为「完整事件脉络」,以事件为主体梳理时间、地点、人物等要素,关联事件的后续发展;回答需要多条线索时先合并重复、剥离冲突。
- 工作记忆(2.0 新增):双层结构——每次会话沉淀一条「事实」(这次任务做了什么),加上 0 到 N 条通过价值门槛的「经验」(值得复用的方法)。经验会带着适用条件一起存,复用前先判断当前是否满足,避免「照搬旧经验反而出错」。
- 代码记忆(2.0 新增):在工作记忆之上加装一条版本演化链,把真实代码改动(diff)存下来;哪怕某个中间版本早已不在当前代码树里,问「当初为什么放弃第一个方案」也能沿链找回决策说明和代码差异——而且记录 diff 不调用大模型。
③ 应用层(MemHub)——把记忆带到你正在用的 AI 工具里。 本地优先的记忆管理应用,提供 CLI 与 Mac App。用户授权关联应用后,可导入各工具的历史会话沉淀为本地记忆,之后各工具的新会话实时同步汇入同一份记忆。已支持 10 种 AI 工具:WorkBuddy、Cursor、Codex、Claude Code、OpenCode、OpenClaw、Qwen Code、Pi、Hermes、DeepSeek Harness。
三层可以独立使用,也可以组合成一套完整的 Agent Memory 方案。
数字:四个 benchmark 全第一,还更省存储
在聊天、工作、代码三类场景的 4 个 benchmark 上,对比 Mem0、MemOS、EverOS、OpenViking、RepoMemory、Simple RAG,Hy-Memory 均为开源框架第一:
| 场景 | Benchmark | Hy-Memory 2.0 | 关键对比 |
|---|---|---|---|
| 聊天记忆 | LoCoMo | 72.6% 准确率 | 高于 EverOS 的 71.9%,每题 token 从 1,159 降到 703(−39.3%) |
| 工作记忆 | MemoryArena | 55.31 平均分 | 领先次优 EverOS 10.2 个百分点 |
| 代码记忆 | CodeMemoryBench | 64.2% 问答 / 35.6% 解决率 | 高于 MemOS、Mem0 |
| 代码记忆 | SWE-ContextBench | 28.3% 解决率 | 高于 MemOS/Mem0 的 25.3% |
存储效率是更反直觉的一个点:在 PersonaMem 公开评测里,Hy-Memory 平均只沉淀 29.2 条记忆(单条约 256 token),而 mem0 是 145.2 条(单条约 58 token)。也就是说它「条数更少、单条更密」,靠演化链把同一话题的新信息更新进同一条,而不是无限堆新条目——数量可控,质量不降。
模型层:Hy-Memory-30B-A3B 在「四套记忆系统 × 六项指标」的等权平均上得分 55.49,高于 Opus 5 的 54.62、DeepSeek V4.1 Flash 的 53.64,以及同尺寸的 Qwen3-30B-A3B 的 44.37。相对其基座模型(47.66),记忆专项训练带来了 +7.8 分的增益。
已经跑在腾讯自己的业务里
Hy-Memory 不是实验室作品,官方列了三个内部落地案例:
- 腾讯自选股 AI 助手:跨天、跨会话记住用户交代的关注方向(如「这周只盯有色和半导体」),综合得分 64.3 → 79.6(相对提升 23.8%),多跳召回提升 40 个百分点;用户调整方向后旧方向归档但可追溯,不会再推回来。
- iWiki CTX 记忆插件:让多个 Agent 共享同一份长期记忆,251 道题里「只用记忆」的回答正确率 36.7%,高于「喂完整原文」的 24.7%(相对提升 48.6%)。
- 腾讯新闻(智声/新闻妹):长期偏好理解评测平均 91.68 分(满分 100)。
这对普通用户和开发者分别意味着什么
- 普通用户:如果你在 Cursor 里交代过的偏好、在 Codex 里定的规范、在另一个工具里做的决定互不相通,MemHub 提供了一个「跨工具共享一份记忆」的本地方案,且数据本地存储、不绑定厂商、兼容任意大模型。
- Agent 开发者:
hy-memorySDK 把「记忆读写」从自研负担变成几行代码接入;三类场景(聊天/工作/代码)对应三类记忆管线,比通用向量库更贴合「长期任务 + 多工具」的真实需求。 - 想做记忆方向的人:这是业界首个把「工作记忆」与「代码记忆」作为独立场景提出的框架,也是首个把「记忆模型」作为可训练、可评测组件单独开源的做法——技术报告的评测口径(Memory LLM 用 DeepSeek V4.1 Flash,judge 用 GPT-5.6-sol)已经给了复现的坐标。
图片出处:封面由 UU AI Hub 自制;架构图取自腾讯混元 Hy-Memory 官方 GitHub 仓库 README。


