一句话总结
GitHub 上有个 7.4k 星的中文开源项目 AIHOT,自称「一个自己找热点、自己写日报的网站框架」。我用三条命令在 Windows 上把它跑了起来,然后花了一晚上把整套 AI 行业的分类体系、实体名录和提示词换成商业航天,得到一个能自己抓新闻、自己打分、自己出日报的行业站 「发射窗口」。这篇文章把过程、坑和改造清单全部写出来——它值得复现的不是代码,而是那套「怎么让模型替你做编辑判断」的框架。
为什么是它:热门项目里能真正落地的没几个
先看数据。抓了 GitHub Trending 的日榜、周榜,以及 Search API 的新建高星项目(created:>2026-09-24 stars:>2000、pushed:>2026-10-18 stars:>15000)。筛完之后发现一件尴尬的事:大部分「热门项目」在普通人的机器上是跑不起来的。
| 项目 | 声量 | 我这台机器能不能跑 |
|---|---|---|
deepseek-ai/DeepInfer(DeepSeek 官方推理框架) | 极高 | ❌ 需 NVIDIA SM100 GPU + Linux + CUDA 13,或者昇腾 950 |
storytold/* 全家桶(纯 Rust 重写 Photoshop/Word/Excel/PDF) | 极高 | ⚠️ 要装 Rust 工具链编译大型 GUI,且 9 个仓库同一天建号 |
Gathin23/cleanyourtv(给 Android TV 去广告) | 高 | ⚠️ 需要一台 Android TV + ADB |
wheresryan22/anatomy(Claude Skill 画等距插画) | 中 | ✅ 但只是个绘图 Skill |
KKKKhazix/AIHOT(自己找热点写日报) | 7.4k 星 | ✅ Node 24 + Docker + 一个模型 Key |
顺带一个方法论提醒:GitHub Search API 返回的 stargazers_count 和仓库页面上显示的星数经常对不上。比如 DeepInfer 的 API 结果写着两万一千多,进仓库页面只有 228。判断一个项目值不值得碰,看仓库页面,别只看 API 返回的数字。
选 AIHOT 的理由很具体:
- 它不是玩具,是作者线上站(aihot.news)同一份引擎代码导出的;
- MIT 许可,作者在 README 里明确说「把名字换掉,它就是你的站」;
- 默认就按 DeepSeek 配置(
LLM_BASE_URL=https://api.deepseek.com/v1),而 DeepSeek 是我唯一有 key 的模型; - 它输出的是资产,不是 demo——跑完你手里多一个能上线的站,而不是一段跑完就删的示例代码。
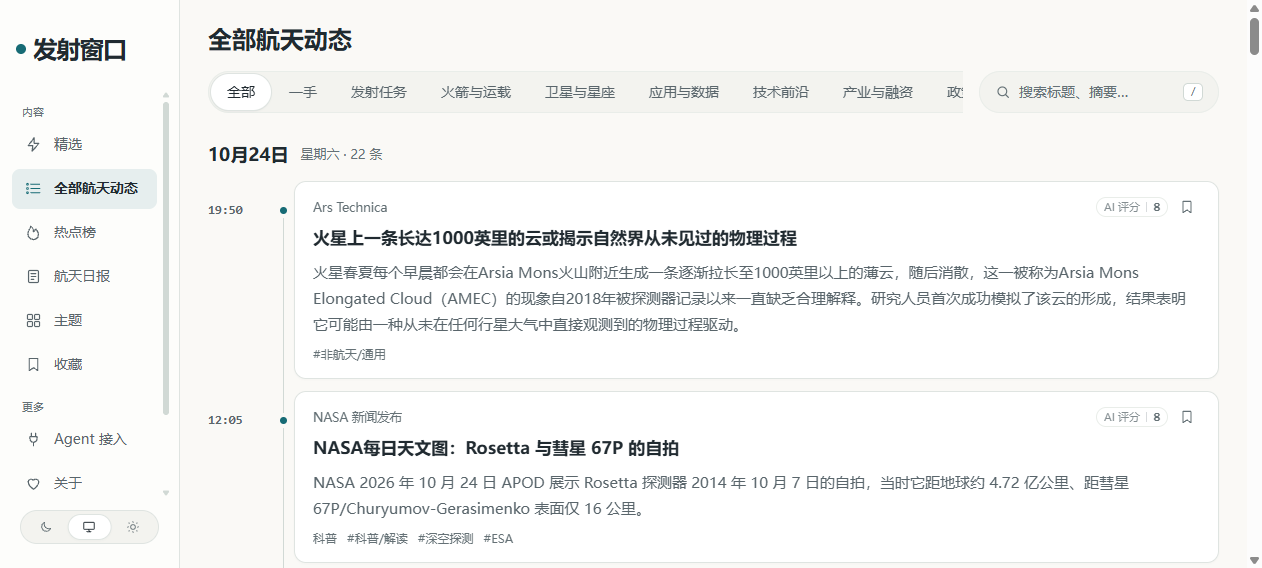
截图:改造后的本地运行实例(http://localhost:3000/all),内容为当日实际采集结果
它是什么:一条从信源到日报的管线
AIHOT 干的事,本质是把「编辑的日常判断」拆成六步流水线:
采集 → 判重 → 预筛 → 两次独立评分 → 中文标题摘要 → 事件聚簇 → 热点排序 → 日报/周报/月报
几个设计细节值得单独拎出来,因为它决定了这个东西能不能用:
① 同一份评分标准,独立打两次分。 两次之和要 ≥ 2×门槛才入选。这是对付「模型评分不稳定」最土也最有效的办法。
② 先聚事件,再算热度。 同一件事,官网发一篇、媒体转十篇、X 上吵一天,读者只需要看到一次。它先用标题摘要的向量(或文字重合度)找候选,再让模型判断「同一件事 / 后续进展 / 两件事」,写入前再复核一遍。热度按事件算而不是按文章算:48 小时内每个独立来源只算一次,24 小时减半——所以一家媒体发十篇也只算一票。
③ 提示词全公开、可改、不用改代码。 所有提示词在 industry/prompts/ 下,入选门槛在 industry/selection.ts。这一条是它能被改造成任何行业站的根本原因。
④ 热度、聚簇、出刊都能单独换模型。 环境变量里可以给每一步指定不同的 provider(PREFILTER_MODEL、SCORE_MODEL、GROUP_REVIEW_MODEL……)。预算敏感的部署可以让便宜模型干粗活。
技术栈:Node 24 · TypeScript · React Router(SSR)· Fastify · PostgreSQL 17 · pg-boss · Tailwind · Docker Compose。四个容器:web / api / worker / db。
复现:三条命令,四个坑
官方给的三条命令是这样的:
git clone https://github.com/KKKKhazix/AIHOT.git myhot
cd myhot
node scripts/init-env.ts --llm-key <你的模型 API Key>
docker compose up -d --build
在国内网络 + Windows 环境下,这四条(算上 cd)命令走了我三个来回。坑记下来,你复现时能省一晚上。
坑 1:Docker 装了,但守护进程没起来
error during connect: open //./pipe/dockerDesktopLinuxEngine:
The system cannot find the file specified.
Docker Desktop 的图标在开始菜单里,不代表它在跑。Windows 上要先把它拉起来,WSL2 后端启动约 16 秒才真正就绪。正确姿势是:后台启动 Docker Desktop.exe,然后轮询 docker info 直到成功,不要启动完立刻 compose up。
坑 2:apt 连不上 deb.debian.org(第一次构建失败)
E: Failed to fetch http://deb.debian.org/debian/pool/main/p/postgresql-common/...
   Unable to connect to deb.debian.org:80 (151.101.90.132), connection timed out
target setup: failed to solve: exit code: 100
有意思的地方在于:宿主机直连 deb.debian.org 是通的,0.4 秒返回 200;容器里测也通,1 秒。真正的问题是钉到某个 CDN IP(151.101.90.132)时偶发不通——典型的「能通但会卡」,重试不解决。
解法是在 Dockerfile 的 base 层把 Debian 源换成国内镜像。实测清华 146ms,比 deb.debian.org 的 1026ms 快 7 倍。
坑 3:换成 https 镜像源,反而彻底失败(这是我给自己挖的)
E: Unable to locate package postgresql-client
E: Package 'ca-certificates' has no installation candidate
「换 https 更安全」是直觉,但这里正好踩进循环依赖:ca-certificates 恰恰就是同一条 apt-get install 里正在装的包。https 握手需要 ca-certificates,而 ca-certificates 还没装上,apt 就直接认为「这个包不存在」。
镜像源必须用 http://,不能用 https://。 这一条能救半小时。
坑 4:npm 也要换源(作者其实留了开关)
AIHOT 的 Dockerfile 里有这么一行:
ARG NPM_REGISTRY=
RUN npm ci --no-audit --no-fund ${NPM_REGISTRY:+--registry=$NPM_REGISTRY}
注释直接写着「e.g. https://registry.npmmirror.com in mainland China」。作者是懂国内环境的,所以:
docker compose build --build-arg NPM_REGISTRY=https://registry.npmmirror.com
四坑复盘:作者专门为 npm 源写了注释和 build-arg,却没管 apt 源——因为他本人在能直连的环境里开发。所以国内复现开源项目,「apt 源 + npm 源」两块都要换,且 apt 要用 http。 这个结论适用于几乎所有 Node/Debian 底座的 Docker 项目,不止 AIHOT。
跑通的第一份证据
容器起来之后,我做了一件比看首页更重要的事:确认它真的在干活,不是空壳。
第一轮采集跑完,首页就出了精选内容,还带模型生成的中文标题、答案先行的摘要和「推荐理由」:
| 时间 | 来源 | 评分 | 标题 |
|---|---|---|---|
| 15:18 | Latent Space | 82 | 月之暗面发布 Kimi K3.1 Pro:2.8T 总参数、104B 激活,承诺 11 月 4 日开放权重 |
| 07:05 | TechCrunch · AI | 78 | OpenAI 宣布不再用实时互联网训练模型,改以缓存和模拟版本替代 |
| 05:11 | The Verge · AI | 80 | OpenAI 在无互联网环境下训练前沿模型,并发现智能体可借缓存通信 |
| 02:51 | Google Research | 60 | Google Research 在 IDWeek 2026 分享用基础模型推动结核病筛查落地 |
这说明整条管线是真的通了:采集 → 预筛 → 双次评分 → 中文标题摘要 → 推荐理由 → 聚簇 → 精选。不是「页面能打开」这种程度的成功。
到这一步,复现就算完成了。接下来才是真正有意思的部分。
改行业:从 AI 到商业航天
作者在 docs/customize.md 里写得很清楚:要改的东西几乎都在 site/ 和 industry/ 两个目录,代码基本不用动。我按这个路径改,站名定为 「发射窗口」(Launch Window)——既是发射术语,也暗合「信息窗口」。
信源:20 个,逐个实测(这一步千万别抄)
这是最容易被忽略、也最容易翻车的一步。不要照搬任何人的信源名单,包括这篇文章的。我把候选源一个个请求过去,结果是这样:
| 站点 | 实测结果 |
|---|---|
| SpaceNews / NASASpaceflight / Spaceflight Now / Space.com / Payload | ✅ RSS 可用 |
| Space Intel Report / Via Satellite / SpaceWatch Global | ✅ RSS 可用 |
| Universe Today / Space Daily / SatNews / Space Explored / Ars Technica | ✅ RSS 可用 |
| NASA Breaking News / ESA Space News | ✅ 官方一手,RSS 可用 |
| 国家航天局 cnsa.gov.cn / 中国载人航天 cmse.gov.cn / 泰伯网 3snews.net | ⚠️ 无 RSS,需 web_list 配 CSS 选择器 |
| 航天爱好者网 / 银河航天 / 中国航天科工 / 未来宇航 | ❌ SSL handshake 失败 |
| 中国航天科技集团 spacechina.com | ❌ 超时 |
| Blue Origin blueorigin.com/news | ⚠️ 429 Too Many Requests |
| ChinaSpaceflight chinaspaceflight.com | 🚨 域名已被劫持,RSS 里 5 条全是印尼赌博广告 |
| SpaceX spacex.com/updates | ❌ 整站 SPA,body 仅 3.4KB,无静态列表 |
最值得说的是那个被劫持的域名。chinaspaceflight.com 从名字看是最「对口」的中文航天站,抓下来的 RSS 是:
🎉 IBS4D – Jackpot Slot JACK THE GIANT HUNTER Rp824.000.000,- LUNAS!
🎉 IBS4D – Jackpot Slot WILD BANDITO Rp10.231.000,- LUNAS!
教训:选信源必须看它实际返回的条目,不能看域名和站名。 一个看起来最权威的域名,可能已经被别人接管去做灰产了。
最终入库 20 个:T1 官方一手 5 个、T1.5 权威行业媒体 3 个、T2 媒体 12 个;rss 16 个 + web_list 4 个。
没有 RSS 的站要自己写选择器,以国家航天局为例,它的列表是 <li class="new_cont_li">,但标题不在第一个 <a> 上(第一个是图片链接,节点文字为空——这就是我第一版选择器抓 0 条的原因):
{
  "url": "https://www.cnsa.gov.cn/",
  "parseMode": "html",
  "itemSelector": "li.new_cont_li",
  "linkSelector": ".news_wz a",
  "titleSelector": ".news_tit.pc",
  "allowUrlPrefixes": ["https://www.cnsa.gov.cn/n"]
}
改对之后,它抓到了当天最该抓的东西:「朱雀二号改进型遥四运载火箭发射成功」「我国成功发射卫星互联网低轨 27 组卫星」。
分类体系:9 个类别
原版是「模型 / 产品 / 行业 / 论文 / 教程 / 观点」,航天得换一整套:
发射任务 · 火箭与运载 · 卫星与星座 · 应用与数据 · 技术前沿 · 产业与融资 · 政策与监管 · 观点 · 科普
日报分节按这个顺序排。另外有个行业专属指标 RELEASE:原版报头显示「N 个新模型」,航天版显示「N 次发射」。
实体名录:45 个,每个都带型号别名
这一步决定了事件归组准不准。如果「朱雀三号」和「ZQ-3」被当成两家公司,聚簇就废了。所以每个实体都写了 aliases / orgNames / otherNames:
landspace: {
  name: "蓝箭航天", displayTag: "蓝箭航天",
  aliases: ["蓝箭航天", "蓝箭", "LandSpace"],
  otherNames: ["朱雀二号", "朱雀三号", "天鹊", "TQ-12", "ZQ-2", "ZQ-3"]
}
45 个实体分三组:国际(SpaceX、Rocket Lab、Blue Origin、ULA、Arianespace、Planet Labs……)、中国商业(蓝箭、天兵、星河动力、中科宇航、星际荣耀、东方空间、深蓝、垣信、中国星网、长光卫星……)、国家队与机构(航天科技集团、航天科工、国家航天局、载人航天工程、NASA、ESA、JAXA、ISRO……)。
还有一层 IDENTITY_LEXICON——27 条正则,用来防模型张冠李戴:摘要里提到 SpaceX,原文必须真的出现过 SpaceX / Starship / Starlink / Falcon / Dragon 之一,否则退回原标题、丢掉摘要。
提示词:真正的行业 KnowHow 在这里
这是整个改造里最花时间、也最值钱的部分。六份提示词全部重写,其中最核心的是评分权重表:
| 类型 | sig 实质份量 | nov 信息增量 | cred 证据强度 | reson 共振面 | act 可用性 |
|---|---|---|---|---|---|
launch_event 一次发射 | 4 | 2 | 2 | 2 | 0 |
vehicle_program 型号研制 | 3 | 2 | 2 | 2 | 1 |
satellite_system 卫星星座 | 3 | 2 | 2 | 2 | 1 |
industry_event 融资订单 | 3 | 1 | 2 | 4 | 0 |
research_paper 论文 | 4 | 2 | 2 | 1 | 1 |
opinion_analysis 观点 | 1 | 3 | 1 | 4 | 1 |
tutorial_explainer 科普 | 1 | 1 | 1 | 3 | 4 |
launch_event 把 sig 给到 4、act 给到 0,是有意的:一次发射成没成,是这个行业最硬的事实,但读者没法「马上用」它。 而 tutorial_explainer 反过来——份量不高但可用性拉满。原版 AI 行业是把 model_release 给成 3/2/2/2/1,这套重排就是「不同行业的注意力结构不一样」的具体体现。
另一份容易被忽略但极其关键的是预筛。行业站最大的噪声不是无关行业的新闻,而是看起来像但其实不是的词。所以 prefilter.md 里明确列了一张「必须 BLOCK」的清单:
星座占星、星座运势、火箭队、火箭速度、卫星店、太空主题餐厅、天文摄影、航空新闻、影视游戏中的太空题材……
最后一份是术语翻译规则。航天有大量一词多义的词,机器翻译几乎必错:
| 英文 | ❌ 常见错译 | ✅ 应该译成 |
|---|---|---|
| launch | 上市 / 推出 / 发布会 | 发射 |
| payload | 有效负载 / 工资单 | 载荷 |
| bus (satellite bus) | 总线 | 卫星平台 |
| static fire | 静态火灾 | 静态点火 |
| scrub | 擦洗 | 发射推迟 |
| nominal | 名义上的 | 正常 / 按计划 |
还有一条很具体的业务规则:标题里的「圆满成功」不能覆盖正文里的负面结果。 如果正文说载荷没进预定轨道、上面级异常,标题就必须如实写部分成功或失败。
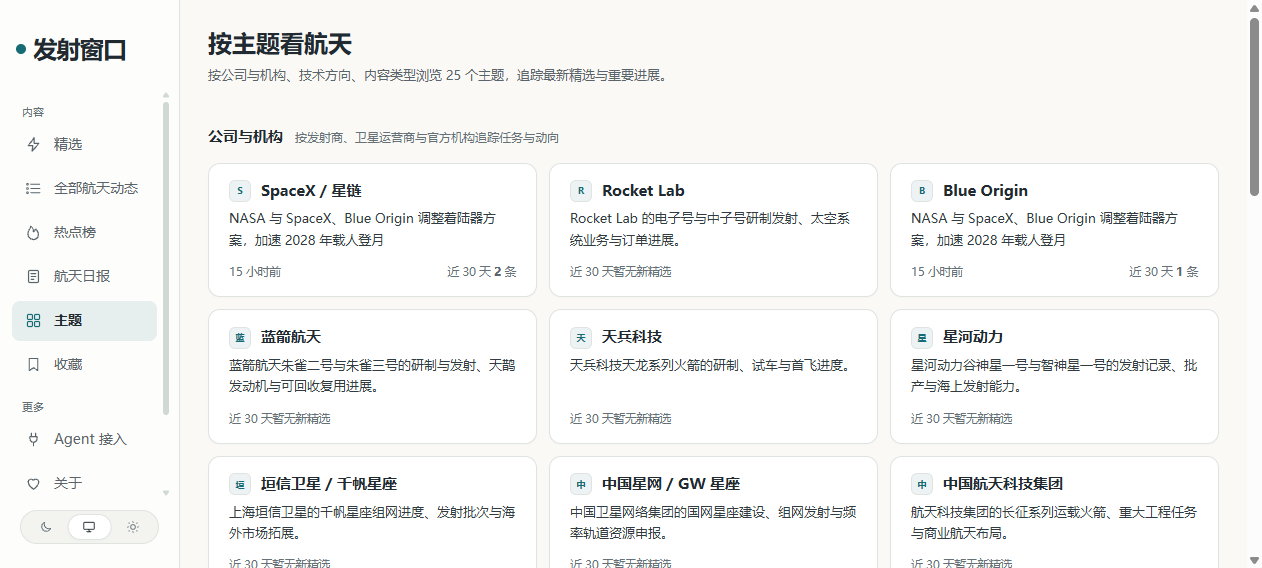
截图:改造后的主题目录(/topics),按公司、技术方向、内容类型三组组织
清库重跑:一个容易漏的细节
改完配置后我犯了个错:直接重启,结果站里混进了 Kimi、OpenAI 的内容。
原因是 industry/sources.json 只在首次启动时导入,而且——这是关键——从文件里删掉的信源不会从库里删。这是 AIHOT 有意的设计(避免覆盖后台的运营修改),但对改造场景就是个坑:原来那 18 个 AI 信源还躺在数据库里继续抓。
正确做法是先清库:
docker compose down -v # 删掉 aihot_db / aihot_data 两个卷
还有一个更隐蔽的坑:docker compose run --rm setup 跑的是镜像内的 sources.json,不是宿主机的。改了宿主机文件但没重建镜像时,seed 会把旧配置又灌回去。要么重建镜像,要么把目录挂进去:
docker compose run --rm \
  -v "D:/path/to/industry:/app/industry" setup
顺带一个配置校验的细节:web_list 类型的信源,顶层不支持 summarySelector,它只在 detail 子对象里合法。写错不会静默降级,会直接报 不支持的配置项。这个设计其实很好——宁可失败也不要静默退回通用解析,把菜单和句子碎片当文章收进来。
结果:它真的能自己出内容
清库重跑之后,20 个信源里 19 个抓取成功,一共约 150 条:
- 国家航天局 10 条(含「朱雀二号改进型遥四运载火箭发射成功」)
- 中国载人航天 7 条
- Rocket Lab 6 条
- 其余 16 个 RSS 各 8 条(首次回填上限,之后按
interval_minutes常态抓取)
模型跑完 128 条分析后,首页出了精选,而且聚簇在工作——两条 Artemis 的报道被合到一起,并标注「另外 2 家也报道了」:
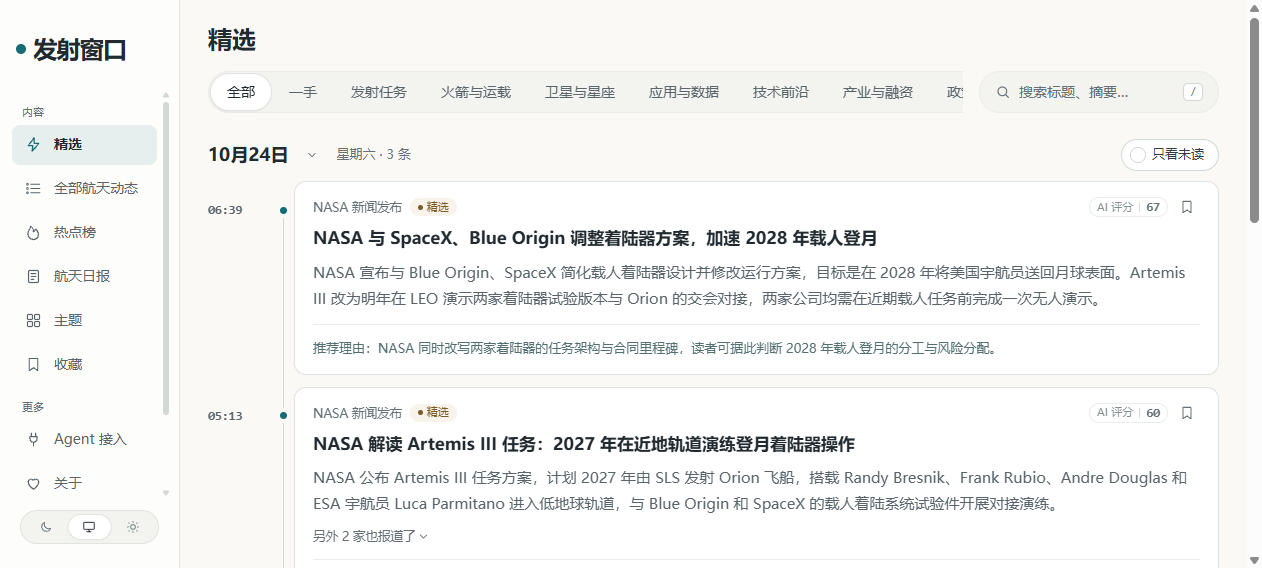
截图:首页精选(/),内容为本地实例实际产出
一个多小时里,它自己完成了「采集 → 判断 → 写作 → 聚簇 → 精选」的全流程,没有人干预。
跑起来之后才暴露的三个真问题
复现和改造是完成了,但真正的问题都是跑起来之后才浮出来的。这三个我都动手解决了,过程比复现本身更有意思。
① 报头字:上游脚本对多字中文 subject 有 bug
日报页顶部的报头字是一张 SVG 字形图(Noto Sans SC Black 转成的路径),由 scripts/nameplates.ts 从行业词生成。站点改名成「航天」之后,得重新生成——然后踩了一串坑。
先是容器内 /app 不可写,npm i 在 workspace 根目录也根本不落盘,最后靠 npm pack 解包 tarball 才把 opentype.js 和字体装进去。
生成成功了,宽度从 718.3 变成 901.1(「航天日报」比「AI 日报」宽),但渲染出来是这样:「航」完整、「天」完全空白、「报」只剩一个偏旁。
根因是作者原本的 subject 是「AI」——两个拉丁字母,走 isLatin 分支。他从没测过 2 个中文字的情况。 脚本按 unicode-range 从 Noto Sans SC 的十几个 woff2 切片里挑字体再取字形,多字中文时部分切片取到的字形不完整。
我的解法是绕开字形路径,改用 <text>:两个独立元素分别承载 id="accent" 和 id="ink",元素本身不设 fill,让 Nameplate.tsx 里 <use href="...#accent" className="fill-accent"> 的 CSS 继承生效。字体回退链 Noto Sans SC → PingFang SC → Microsoft YaHei。
验证方式值得说一下:我没等日报出刊,而是写了个等价于 Nameplate.tsx 的测试页(<use> 引用外部 SVG + 外部 class 控色),跑 Playwright 截图逐字核对——四个字完整、双色正确、archive 版反色也对。
代价是放弃了作者「每个系统都是同一枚静态字形标志」的保证。对中文站来说这个取舍划算:读者几乎都有苹方或微软雅黑,差异肉眼不可辨。
② 门槛:AI 行业的默认值,在这里把真新闻挡在了门外
industry/selection.ts 里默认的 T1 60 / T1_5 65 / T2 76 是作者在 AI 领域调出来的。跑第一天:约 150 条内容只选出 3 条。
我把评分分布拉出来看了,然后发现一件很直观的事:
| 分数 | 条数 | 代表内容 |
|---|---|---|
| 85 | 1 | SpaceX 三季度营收 147 亿美元,AI 业务首超 Starlink |
| 78 | 2 | Xona 完成 2.5 亿美元 D 轮融资 |
| 75 | 2 | 日本 MMX 火星探测器搭 H3 发射 / Vulcan 停飞,太空军六次任务转交 SpaceX |
| 67 | 2 | NASA 公布 Artemis III/IV 方案 |
| 62 | 6 | 星舰 15/16 试飞 + FAA 环评、Rocket Lab 签 20 次发射合同 |
| 58 | 12 | Blue Origin 扩建发射台、太空军采购合同、Voyager Griffin 环测 |
58 分以上,没有一条是噪声。 而 76 的门槛把 Blue Origin 扩建发射台、Rocket Lab 那 20 次发射的合同——主流航天媒体会做头条的东西——全挡在外面。
下调成 T1 52 / T1_5 58 / T2 62 之后,评分够线的从 3 条增加到 7 条(归组去重后进页面的是其中一部分)。
顺便说一句:进去的那几条里,Xona 的两轮融资新闻还并排躺着。这就是下面第 ③ 点要说的问题。
这里有个必须说清楚的机制:文档里写得很坦白,「改了提示词,之后的新资料按新版判断,已经判过的不会重算」。所以那两条 75 分的(Vulcan 停飞、MMX 发射)仍然是旧门槛下的判定结果,跑完并没有自动翻案——新门槛只对之后处理的条目生效。想要历史数据也按新标准重判,得删掉对应的分析记录让它重跑(会重新调模型)。
作者给的正规校准路径是:自己标 100–200 条「该选/不该选」做成 gold 集,跑 scripts/eval-selection.ts 看准确率/查准率/查全率,再回去改评分提示词。我用分数分布做的是快速近似,方向对,但门槛最终是你的编辑口味的量化,这一步没有捷径。
③ 聚簇:不配 embedding,同一件事会被算成五条
这个是我觉得最值得记的一个坑。
Xona 同一轮 2.5 亿美元 D 轮融资,在库里是 5 条独立记录:
78 | Xona 六星入轨并完成 2.5 亿美元 D 轮融资,计划 2027 年初启动 Pulsar 导航
78 | Xona 完成 2.5 亿美元 D 轮融资,推进 Pulsar 商业 GPS 星座
73 | Xona Space Systems 完成 2.5 亿美元融资,估值 24.5 亿美元
72 | Xona Space Systems 完成 2.5 亿美元 D 轮融资,估值 24.5 亿美元
61 | Xona 完成 2.5 亿美元 D 轮融资,用于扩展 Pulsar 导航星座
首页只有一处「另外 2 家也报道了」,那是英文同源报道文字高度相似才匹配上的。
根因是没配 embedding 服务。 AIHOT 的归组要先用向量在最近两周里找候选,没配 EMBEDDING_BASE_URL / EMBEDDING_API_KEY 时降级成「比对文字重合度」——中文标题换个说法(「完成 D 轮融资」vs「完成 2.5 亿美元融资,估值 24.5 亿美元」)就召不回候选了,模型再准也没有机会判断。
DeepSeek 不提供 embedding 接口,得另外接一家(阿里云百炼的 text-embedding-v4 或其他 OpenAI 兼容的 /embeddings)。这直接决定「同一件事只出现一次」能不能成立——不配的话,热点榜会明显偏低,精选里也会出现同一件事占两条的情况。
仍然存在的一个缺口
中文一手源偏少。 现在只有国家航天局和中国载人航天两个官方中文源,加一个综合媒体(钛媒体,靠预筛过滤非航天内容)。国内商业航天的一手信息大量在微信公众号上,而公众号信源需要「极致了」的 API key(按请求计费)。这块要么买 key,要么自己写转发。
另外记录一个具体的标签误判:Ars Technica 那条「火星上一条长达 1000 英里的云」被模型打上了 非航天/通用 标签——行星科学被误判成非航天。这类边界要在 prefilter.md 和 structure.md 里持续补规则。
这套东西能怎么用
抛开「发射窗口」这个具体产物,AIHOT 真正值得学的是它怎么把「编辑判断」写成可执行的规则:
- 两次独立评分:用工程手段对付模型的评分抖动,比调 prompt 求稳定更靠谱
- 按事件算热度,不按文章算:每个独立来源只投一票,天然抗刷量
- 提示词与代码分离:
industry/整个目录就是「行业配置包」,换行业不用碰一行 TS - 噪声清单和入选标准同等重要:大部分行业站做不好,不是因为选不出好东西,而是因为挡不住坏东西
- 防幻觉写在数据层:
IDENTITY_LEXICON让「摘要提到的公司原文必须出现过」,这比在 prompt 里写十遍「不要编造」有用
至于它能做什么:行业热点站、竞品监控、给自己看的每日简报、给 Agent 用的结构化数据源(它自带 MCP、RSS、OpenAPI、llms.txt)。它输出的是一份能被机器读的结构化内容,这在 Agent 时代比一个人看的网页值钱。
复现成本也值得说清楚:一台普通 Windows 机器、Docker、一个 DeepSeek key,一个晚上。真正花时间的不是跑起来(那是半小时的事),而是「把行业 KnowHow 写进提示词」——那部分谁也替不了你。
本文所有截图均取自在本地运行的真实实例(http://localhost:3000),数据为 2026-10-24 当天采集结果。项目地址:github.com/KKKKhazix/AIHOT(MIT)。


