一句话总结
2026 年 9 月 15 日,Salesforce 在 Dreamforce 大会上发布 Koa——公司第一个 CRM 推理模型,基于 NVIDIA 开放权重的 Nemotron 3 Super 后训练而来。它被塞进 Agentforce(Salesforce 的智能体平台),专门处理「更新商机、流转工单、安排跟进」这类多步骤企业任务。官方给的两个关键数字是:CRM 基准上达到或超过领先模型,错误减少 3 倍;训练数据全部是合成场景,没有用任何客户真实数据。更值得注意的是它背后的态度转变——过去企业要让智能体做长链条推理,只能把请求发给 Claude 或 ChatGPT;现在 Salesforce 说,这件事也可以在自己家的信任边界里做完。
数据来源
本文事实依据:
- Salesforce 官方新闻稿《Announcing Koa: Salesforce’s First CRM Reasoning Model, Built on NVIDIA Nemotron》(salesforce.com/news,2026-09-15)
- TechCrunch《Salesforce and Nvidia’s new reasoning model is everything the AI labs should fear》(2026-09-15,作者 Julie Bort,含对 Salesforce AI EVP Jayesh Govindarajan 与 NVIDIA VP Kari Ann Briski 的采访)
- NVIDIA 官方博客《‘Now We Can Know Everything and Do Anything,’ Jensen Huang Says at Dreamforce》(blogs.nvidia.com,2026-09)
27 年的 CRM 经验,第一次被「搬进模型里」
先把 Koa 是什么说清楚。
它不是又一个通用大模型的微调版本,而是一个「懂业务结构」的推理模型。Salesforce 官方的说法是:Koa 用「近三十年 CRM 部署沉淀下来的企业知识」构造的专有合成数据集,对 NVIDIA Nemotron 3 Super 做后训练,目标是让模型理解一单生意怎么推进、一个服务工单怎么流转、不同行业的流程差在哪。
Marc Benioff(Salesforce 董事长兼 CEO)在新闻稿里的表述很直白:
「Salesforce 最有价值的东西不是平台,而是我们积累的关于企业业务如何真正运转的知识。有了 Koa,这些知识被放进了模型本身。」
这句话解释了为什么这件事意义大于一次普通的产品发布:企业软件的护城河,从「数据存在我的数据库里」变成了「业务逻辑烧进了我的模型权重里」。
Koa 之前:多步推理必须「外发」
要理解 Koa 的分量,得先看它替掉了什么。
在 Koa 之前,Agentforce 客户搭建的智能体,如果遇到需要长链条、多步骤推理的任务(例如「把这个商机推进到下一阶段,并同步安排跟进会议」),请求会经由 Agentforce 的 AI 网关(AI gateway)——也就是决定用哪个模型来接这一单的调度层——转发给前沿模型:Claude 或者 ChatGPT。
也就是说,企业最贴近业务现场的那部分推理请求,是要离开自己的系统边界、发到第三方模型提供商那里的。
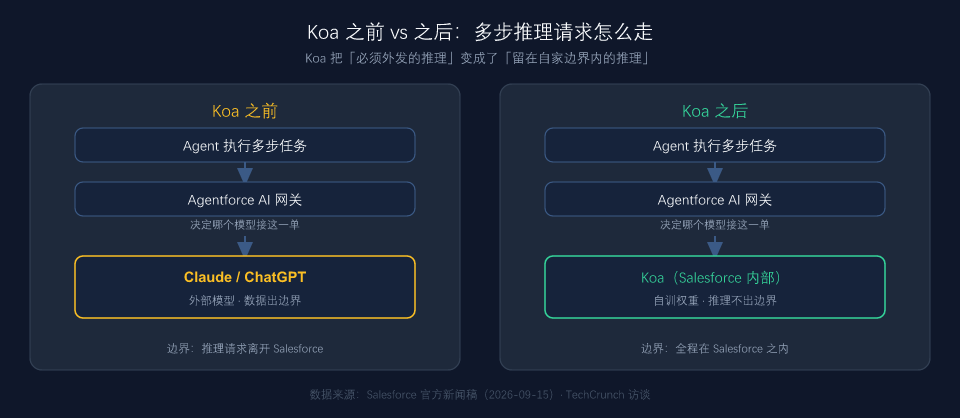
Salesforce AI 执行副总裁 Jayesh Govindarajan 对 TechCrunch 的表述,基本就是这次发布的动机说明:
「我们做了很多小而专的任务模型,它们属于 Agentforce 的产品组合。但推理这件事,我们一直依赖前沿模型提供商。直到现在。」
Koa 是怎么被训出来的:开放权重底座 + 全合成企业场景
Koa 的训练路线值得单独拆开看,因为它恰好回答了两个企业最关心的问题——数据会不会外流,以及成本能不能算得清。
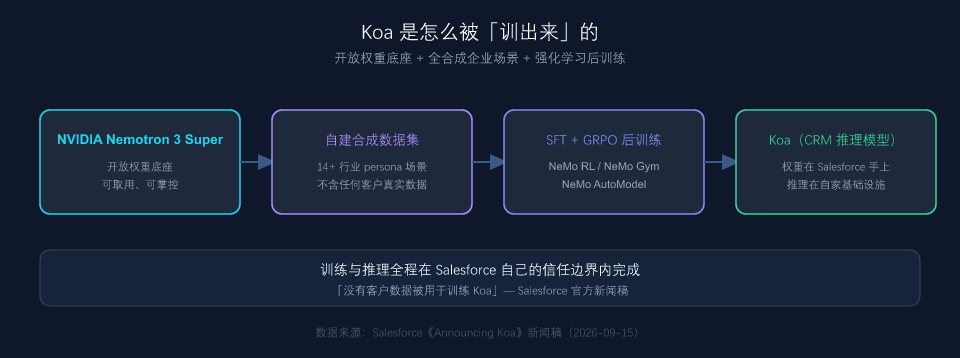
第一,底座用开放权重,而不是从头训。 Govindarajan 说得很坦率:Salesforce 一直想训自己的企业级前沿模型,卡点从来不是算力,而是缺一个可用的预训练底座——需要同时满足三件事:属于美国本土(sovereign)、达到当时最优水平(state of the art)、并且训练数据来源清晰可追溯(clear data provenance)。
他顺带点了一个很有意思的对比:
「我们根本不知道 Qwen 是用什么数据训练的。」
这句话是当下「开源模型地缘政治」最直白的注脚:开放权重带来的自由,和数据来源的可审计性,是两件不同的事。 对企业与政府客户而言,后者往往才是采购决策的那道门槛。
第二,训练数据完全合成。 官方明确写了「没有客户数据被用于训练 Koa 推理模型」。做法是构造覆盖 14 个以上行业(制造业、金融服务、医疗、旅游等)的合成场景:每个场景配一个角色(persona)加一组任务,再把它必须调用的工具序列和动作路径标注出来。Govindarajan 描述得挺具体——他们模拟了一个客户服务环境,从「愤怒的来电客户」一直演到「正在促成交易的销售」。
第三,后训练方法是标准组合拳。 监督微调(SFT)加上基于 GRPO 的强化学习,工具链是 NVIDIA 的 NeMo RL、NeMo Gym 和 NeMo AutoModel。Salesforce 的说法是,模型因此学到的不只是「给出正确答案」,而是「一步步做出正确动作」。
NVIDIA 生成式 AI 软件副总裁 Kari Ann Briski 则把价值总结成了一个词:tokenomics(token 经济学)。她说 Nemotron 的推理架构是「token 高效」的,而企业真正需要的是三件套——主权 AI、首 token 时延、高效推理。
「自训一个」和「租一个」,差的从来不是能力上限
很多讨论会把这类发布解读成「企业模型要挑战前沿实验室」。但从官方给出的对标维度看,Koa 争的并不是能力天花板,而是四项工程与合规指标。
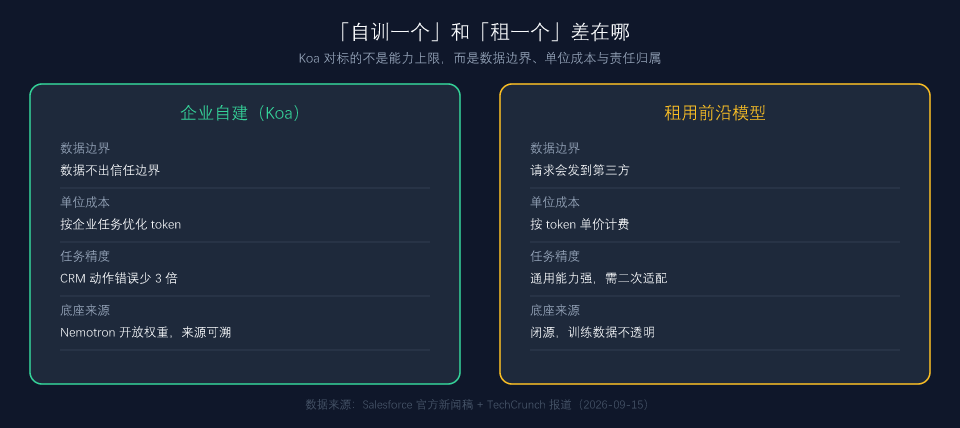
- 数据边界:Koa 的权重由 Salesforce 掌控,后训练与推理都发生在自己的信任边界内,推理阶段没有客户数据跨过边界;租用前沿模型意味着请求必然出界。
- 单位成本:官方强调 Koa 在客户实际想做的任务上「更便宜——按烧掉的 token 算」。这对高频、长链条的客服与销售流程是刚需。
- 任务精度:在 Salesforce 自建的 CRM 基准上(包含更新商机、流转工单、安排跟进等真实任务),Koa 在 CRM 动作上达到或超过领先模型,错误减少 3 倍。注意这是厂商自建基准,需要独立复现才能当定论。
- 底座可追溯性:Nemotron 是开放权重,来源与许可可查;闭源前沿模型的训练数据构成不对外披露。
同一个 Dreamforce,两个方向的动作
值得注意的是,Salesforce 并没有把这件事做成「跟前沿实验室翻脸」。
同一个大会上,他们还发布了 Claudeforce——与 Anthropic 的合作,允许企业把 Claude 当作 AI 交互界面,而数据继续留在 Salesforce 的系统记录里,由 Salesforce 的基础设施保障。另外,双方把 Nemotron 模型与加速计算引入 Missionforce,面向政府和受监管机构,支持私有云、**气隙网络(air-gapped)**等环境。
把三件事放在一起看,Salesforce 的策略其实很清楚:
| 场景 | 用什么 | 数据在哪 |
|---|---|---|
| 通用对话、复杂开放推理 | 前沿模型(Claude 等) | 通过网关外发,但业务记录留在 Salesforce |
| 高频 CRM 流程推理 | Koa | 全程不出信任边界 |
| 政府 / 受监管 / 气隙环境 | Nemotron 系模型 + 加速计算(Missionforce) | 私有云或本地 |
翻译一下:企业开始按「任务的敏感度与频率」分层选模型,而不是无脑全押一家。 这比「谁打败谁」的叙事更接近真实的企业采购逻辑。
已经有人在用了
官方披露的落地情况是:Koa 已在 Salesforce 内部使用(例如一个 Slack 里的智能体,帮员工找信息、办日常事务),并进入客户试点,名单包括 1-800Accountant、Baxter Credit Union(BCU)、Engine、Formula 1、UChicago Medicine 和 Xero。
三个观察
一、企业 AI 的竞争重心,从「模型能力」挪到了「边界与账本」。 Koa 的所有卖点——本土底座、数据可溯源、权重自持、token 更省——没有一条是「更聪明」。这正是企业级采购的真实排序。
二、合成数据正在成为企业模型的默认训练材料。 「不用客户数据也能训出业务专精模型」这件事如果被反复验证,会显著降低企业使用 AI 的合规阻力,也会让「数据 = 燃料」的直觉变得不那么绝对。
三、开放权重模型的价值,正在从「便宜」转向「可掌控」。 Govindarajan 那句「我们不知道 Qwen 训在什么数据上」,说明在企业与政府市场里,开放权重的真正卖点是可审计性,而不是免费。这对所有做开源模型的团队都是一个明确的信号。
信息来源:Salesforce 官方新闻稿 · TechCrunch 报道 · NVIDIA 官方博客
配图说明:封面与内联示意图由 UU AI Hub 生成;koa-salesforce-nvidia.jpg 来自 Salesforce Newsroom 官方新闻稿配图,koa-jensen-dreamforce.jpg 来自 NVIDIA 官方博客 Dreamforce 现场照片,均为官方公开素材,此处仅作报道引用。


