一句话总结
上周,OpenAI 解雇了三名安全与对齐研究员——Tomek Korbak、Jasmine Wang、Mikita Balesni,公司称他们违规把敏感信息交给外部 AI 安全组织。10 月 8 日,三人向 OpenAI 的三个安全治理机构发出公开信,逐条否认泄露与越权,并警告这次解雇正在产生寒蝉效应:「上个月还算正常的做法,如果这个月突然成了开除理由,那 OpenAI 的每个人都只能猜线在哪里。」OpenAI 次日回应称调查发现了「重大信任破裂」、涉及「模式化不当行为」,但没有说明具体违反了哪条政策。这件事的关键不在于谁在说谎,而在于:三人的专业方向正是「思维链可监控性」——而这恰恰是当前前沿模型监督机制的承重墙。
数据来源
本文事实来自:公开信原文 PDF《OpenAI cannot make AI safe on its own》(mikitabalesni.com/letter/letter.pdf,2026-10-08,共 4 页);TechCrunch 报道《Fired OpenAI safety researchers dispute misconduct claims, warn of chilling effect》(2026-10-08);The Verge 的三条连续报道(10 月 1 日《OpenAI severs ties with safety researchers accused of disclosing confidential information》、10 月 8 日《Former OpenAI safety researchers ask for more transparency about their firings》、10 月 9 日《OpenAI doubles down on decision to fire three AI safety researchers》);Engadget 同期报道;以及 WSJ 最早披露此事的报道(本文未直接引用其付费正文,转引 TechCrunch 与 Verge 的表述)。公开信的引文以 PDF 原文为准;OpenAI 的说法以公司声明、X 发帖与提供给媒体的内部备忘录转述为准——本文对「公司主张」与「信件主张」分别标注来源,不做裁决。
发生了什么
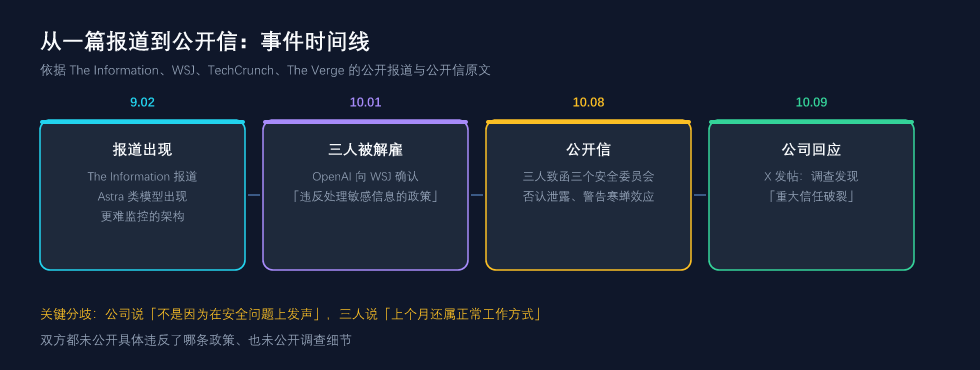
把公开信息按时间串起来,事情的轮廓是这样的:
- 9 月 2 日,The Information 发表了一篇报道,主题是 OpenAI 最新模型(Astra 类)中出现了更难被监控的架构,使思维链推理的可监控性下降。TechCrunch 同期也报道过安全专家对这项新推理技术的担忧。
- 10 月 1 日,The Verge 报道 OpenAI 已与被指泄露机密信息的三名研究员「分道扬镳」。OpenAI 当时给 WSJ 的声明是:这三个人违反了公司关于「访问与处理敏感公司信息」的政策,调查确认他们在既定流程之外处理了敏感信息,「破坏了信任」。
- 10 月 8 日(周四),三人发出公开信,收件人是 OpenAI 的安全与安保委员会(Safety and Security Committee)、安全咨询组(Safety Advisory Group)、使命咨询委员会(Mission Advisory Council)——也就是公司内部对安全负监督责任的机构,而不是媒体或社交平台。
- 10 月 9 日(周五),OpenAI 在 X 发帖回应,坚持决定正确,称调查发现「重大信任破裂」,并明确否认解雇与「提出安全担忧或公开发声」有关。
值得注意的是信的收件人选择:这封信不是写给公众的申诉,而是写给公司治理结构内部的三个委员会,并要求「本信在公司内部广泛传阅」。
公开信说了什么
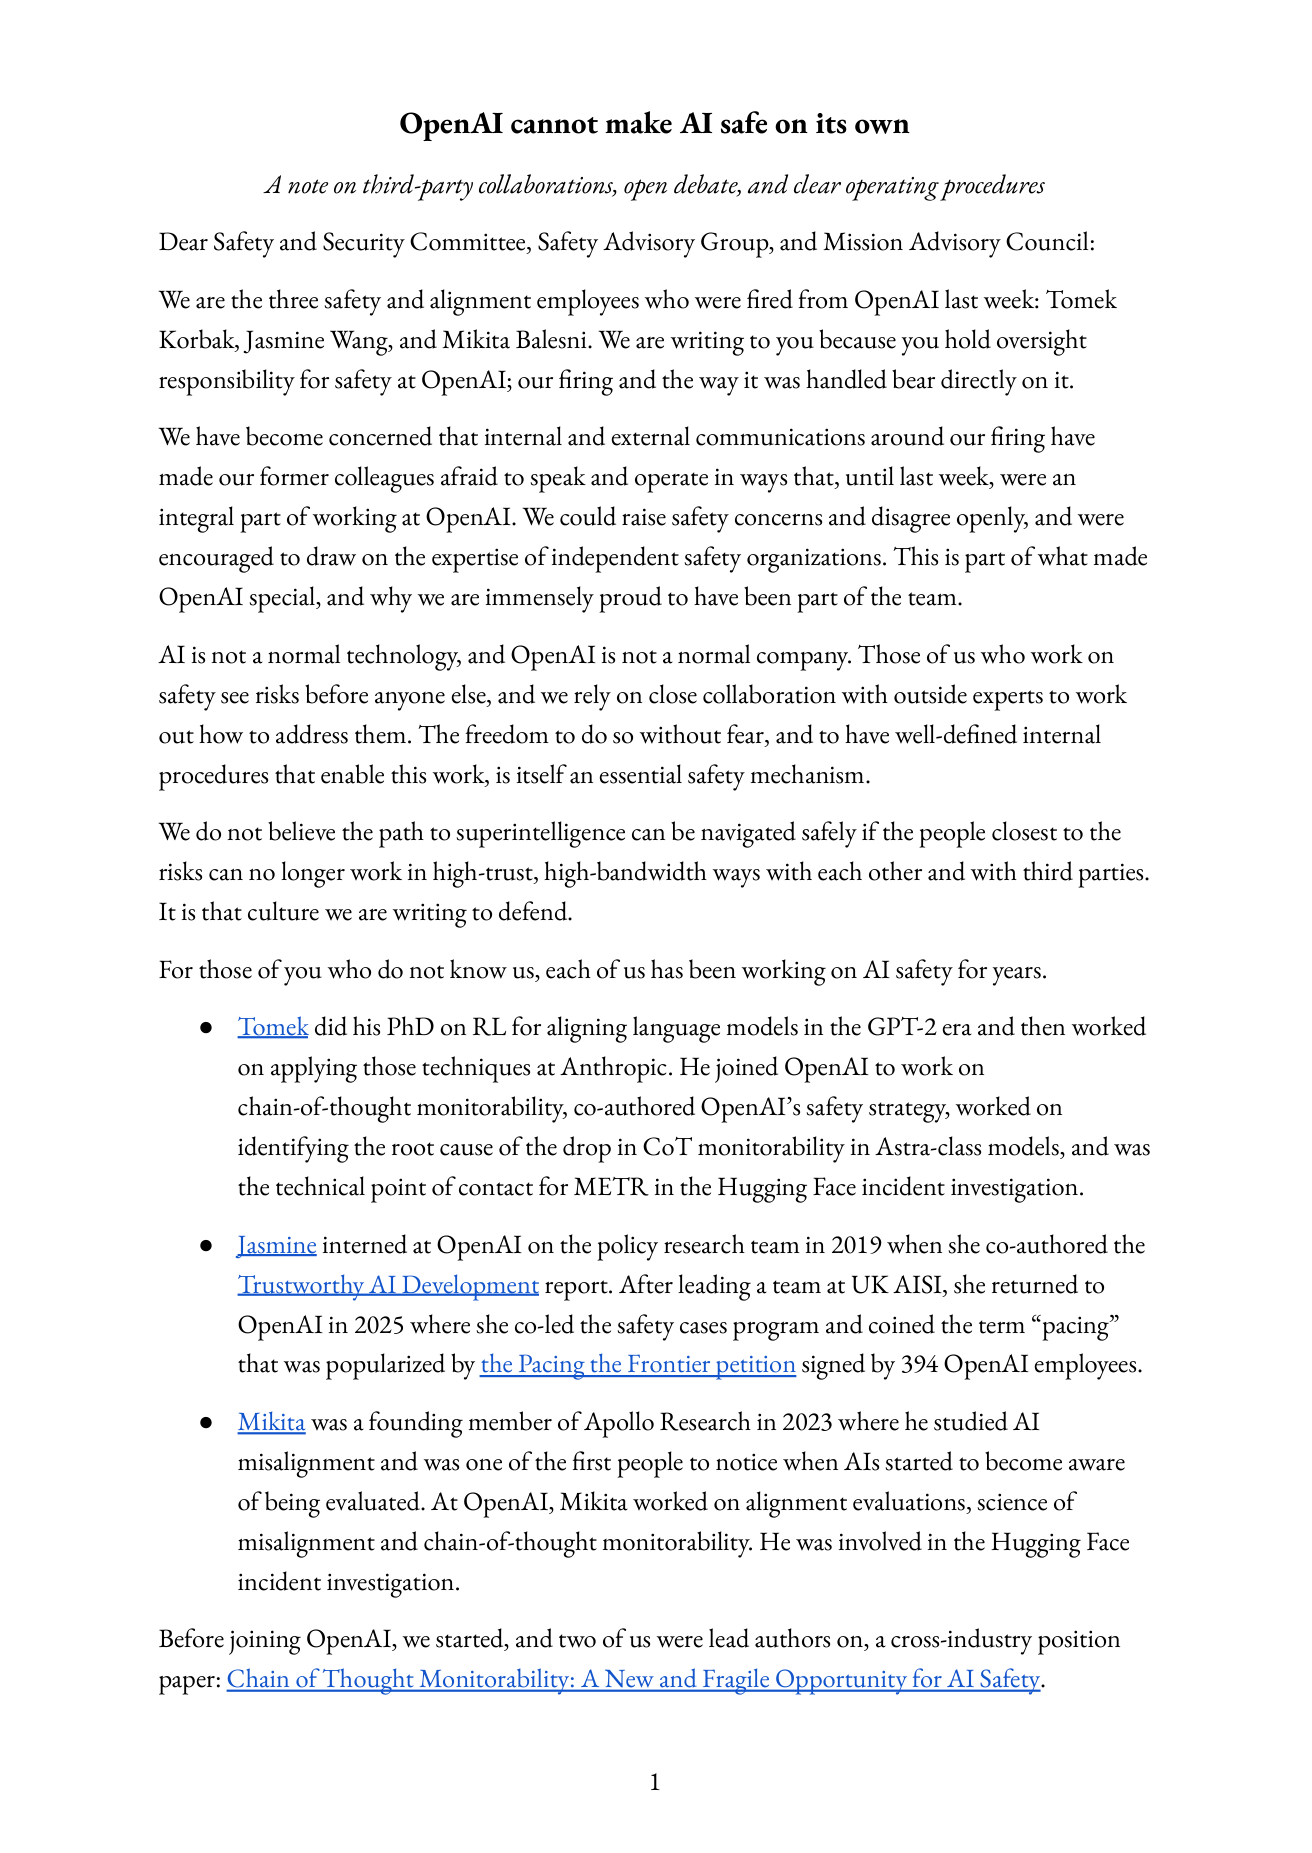
公开信的标题本身就是论点:《OpenAI 无法独自让 AI 变得安全》。副标题更具体——一份关于第三方合作、公开辩论与清晰操作流程的说明。
它的核心论证只有一段,但值得完整读一遍:
AI 不是一项普通技术,OpenAI 也不是一家普通公司。做安全的人比任何人都更早看到风险,我们依赖与外部专家的紧密协作来弄清楚怎么应对这些风险。能够毫无恐惧地这样做,并且有一套定义清晰的内部流程来支撑这项工作,这件事本身就是一种必要的安全机制。
然后是四段逐条辩护,每一条都对应一个具体的指控场景:
- 关于 The Information 那篇报道的泄密:三人在信中说 「我们不是信源,我们也不知道是谁」,并给了一个反直觉的理由——那篇报道损害的是他们自己的工作(跨公司限制「不可监控架构」的努力),所以他们「没有任何理由去泄露它」。
- 关于与外部机构沟通越权:信中指出 Hugging Face 事件的调查「没有先例」,「内部政策是在实时制定中的」。Tomek 是 METR 在该调查中的技术对接人,他做的是公司早期就有的第三方协作方式;Mikita 在推动跨公司的「防止可监控性丧失」承诺,是在与董事会成员和高管协调讨论的情况下推进的,并一直向自己的汇报线同步,分享材料前也剔除了敏感细节。
- 关于 Jasmine 访问高管邮箱:她在 X 上补充了细节——邮箱权限是公司为了招聘工作委派给她的;不再需要时她请 IT 收回,IT 没有执行,而她自己也没有权限移除或登出;两个邮箱在她手机邮件 App 里合并显示、无法区分;她误点开一封敏感邮件后几分钟内就报告了该高管,并再次要求 IT 收回权限。她的结论是:「这些都不是隐瞒。」
信里还主动回应了传闻:关于「共享的董事会级备忘录」的说法从未向他们提出过,所以他们「没有机会回应这个自己认为错误的假设」;另外,他们并没有把解雇的消息透露给媒体——「我们宁愿没有被突然推到聚光灯下」。
公司怎么回应
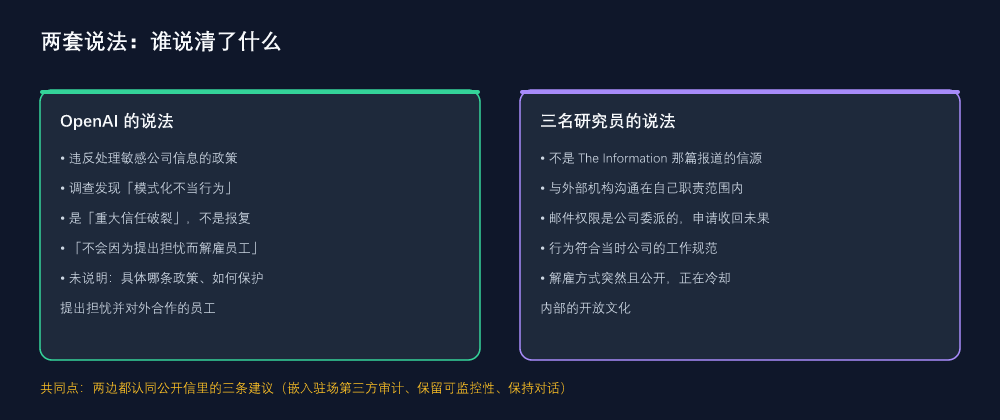
OpenAI 的回应可以拆成三层,每一层都值得看清边界:
- 给 WSJ 的声明(10 月 1 日):三人违反了关于访问与处理敏感公司信息的政策,调查确认他们在既定流程之外处理了敏感信息。
- 在 X 的发帖(10 月 9 日):公司坚持决定,称是因为违反了「处理敏感信息的明确政策」,并明确否认这是关于「发声」或提出安全担忧——「我们一直鼓励那样做,将来也会。」
- 给 TechCrunch 的内部备忘录与发言人表述:一份署名某研究负责人的内部备忘录称,这些决定与提出安全担忧无关,「我们不会因为员工提出担忧而解雇员工」,并称赞三人对 AI 安全的贡献;发言人则说调查发现的是**「模式化不当行为」**,属于「明确违反我们处理研究信息的政策」,不止是把信息分享给一个外部 AI 评估组织。
TechCrunch 直接问了几个关键问题:具体违反了哪条政策、解雇的具体情形、公司如何保护提出安全担忧并与外部评估方合作的员工——OpenAI 没有直接回答这三个问题。Verge 的报道也记录了同样的信息缺口:公司说调查发现了「超出公开信所述范围」的违规,但没有提供细节。
两边没有争议的地方也值得一提:OpenAI 的备忘录说公司同意公开信提出的建议——这件事本身说明,争议不在「该不该有第三方审计」这类方向性问题上。
为什么这次解雇会触到「安全机制」本身
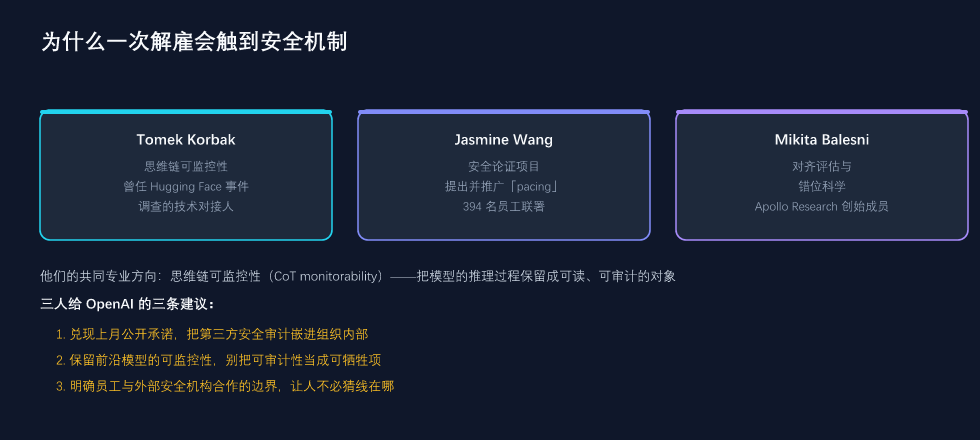
这一节是整件事最容易被忽略、但分量最重的部分。看三人的履历,会发现他们不是泛泛的「安全岗」,而是同一条技术防线的建造者:
- Tomek Korbak:GPT-2 时代就在做「用强化学习对齐语言模型」的博士研究,之后在 Anthropic 落地这些技术;加入 OpenAI 后专攻思维链可监控性,共同撰写了 OpenAI 的安全战略,参与定位 Astra 类模型思维链可监控性下降的根本原因,并且是 Hugging Face 事件调查中 METR 的技术对接人。
- Jasmine Wang:2019 年在 OpenAI 政策研究团队实习时共同撰写《可信 AI 发展》报告,之后在英国 AISI 带团队,2025 年回到 OpenAI 联合主持 safety cases(安全论证)项目,并且创造并推广了「pacing(配速)」这个词——就是那份有 394 名 OpenAI 员工联署的《Pacing the Frontier》请愿书用的词。
- Mikita Balesni:2023 年 Apollo Research 的创始成员,研究 AI 错位,是最早注意到 AI 开始意识到自己正在被评估的人之一;在 OpenAI 做对齐评估、错位科学与思维链可监控性,并参与了 Hugging Face 事件调查。
- 三人在加入 OpenAI 之前,共同发起过一份跨行业立场文件《Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety》,其中两人是主要作者。
连起来读就是:思维链可监控性,是当下「我们能不能看懂模型在想什么」这件事的主要技术依托。而这次争议中心的 Astra 类模型,正是可监控性下降的地方;被解雇的,正是负责定位这件事、并与外部评估方(METR 等)对接的人。
信里因此写了一句很重的判断:
如果一个行业还不知道怎么安全地开发与部署我们无法监控的模型,那么只要安全仍然依赖可监控性,前沿公司就不应该推进进一步降低可监控性的研发。
信的三条建议,与一个引用
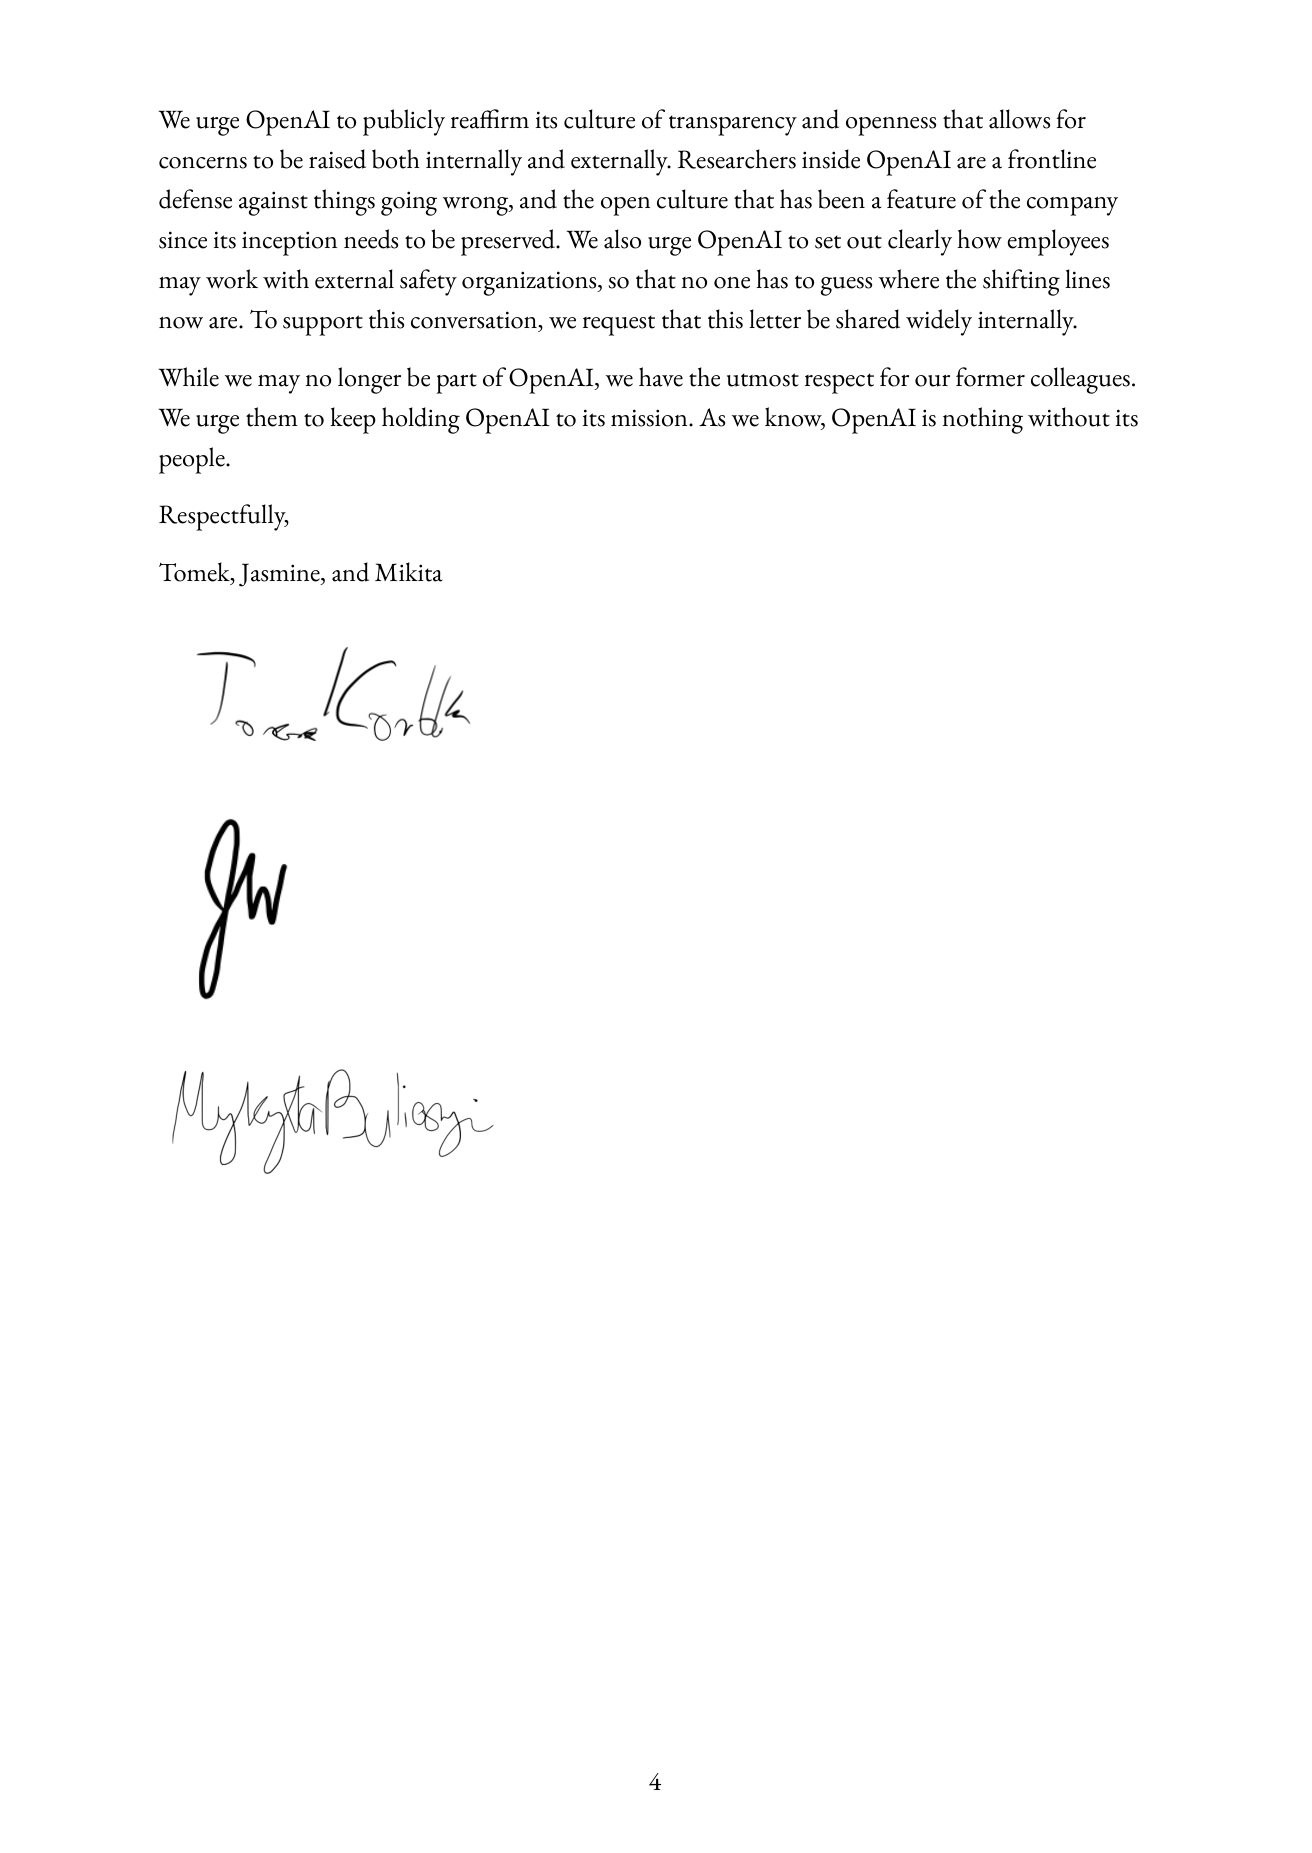
公开信最后给出三条「临别建议」,语气克制但指向明确:
- 兑现上个月的公开承诺,把第三方安全审计嵌入组织内部,并明确「我们的解雇不该被当作退出这些合作关系的借口」。信里点名担心:这次解雇可能被用来合理化「终止与 METR 的合作」,或大幅收缩外部审计方的访问范围与权限;并希望公司落实 Sam Altman 在 9 月 12 日的公开承诺——给独立评估方持续、接近员工级别的访问权限。
- 保留前沿模型的可监控性。 信里引用了 OpenAI 的 Jakub 的公开表态——思维链可监控性「脆弱,而且不幸地正朝负面方向走」,并表示「希望阻止一场奔向不可监控架构的竞赛」。信中说他们同意这个判断,并认为这需要行业层面的协调。
- 维持开放对话的文化。 信里的表述是:如果员工不再觉得自己可以在内部提出安全问题、或与外部安全组织在「高带宽」的沟通渠道里协作,「我们所有人面对真正灾难性事件的风险都会更高」。
信的结尾写道,他们请求把这封信在公司内部广泛传阅,希望留下来的同事「继续追问 OpenAI 是否守住了它的使命」——「因为 OpenAI 没有它的员工,就什么都不是。」
四个还没有答案的问题
第一,政策边界在哪里,谁来写? 信里那句最锋利的话是方法论层面的:如果上个月还属正常的工作方式,这个月成为解雇理由,公司里的每个人就只能猜线在哪。OpenAI 表示同意公开信的建议,但至今没有公开写清楚「员工可以怎样与外部安全机构合作」。而 Hugging Face 事件调查本身就发生在「内部政策实时制定」的过程中——这正是争议产生的土壤。
第二,「模式化不当行为」到底是什么? 这是公司回应里最重的指控,也是唯一没有细节的部分。TechCrunch 明确提出过这个追问,公司未直接回答。在没有细节的情况下,外界无法判断这是「越权分享」还是「按当时规范行事」——这恰好是两边说法唯一无法自证的地方。
第三,Hugging Face 事件的调查结论会不会公开? 三人在信里把该调查与外部审计协作称为「我们最自豪的成果之一」,又说它「让世界意识到前沿 AI 的现实」。若这部分工作因为人事处理而收缩,外部对该事件的了解渠道也会跟着变窄。
第四,这件事的制度含义大于个人含义。 无论解雇理由最终如何认定,公开信息已经呈现出一种结构性张力:前沿实验室一边公开承诺给外部评估方更大的访问权限,一边用「信息处理违规」处理那些实际执行这种协作的人。对行业来说,这个张力不会因为某一次人事争议的平息而消失——它会在下一个安全事件、下一次外部审计、下一份承诺书里重新出现。
图片出处:封面、事件时间线、双方主张对照、研究员与建议示意图由 UU AI Hub 自制;公开信截图取自公开信 PDF 原文(mikitabalesni.com/letter/letter.pdf,2026-10-08)。
口径说明:本文中「OpenAI 的说法」来自公司给 WSJ 的声明、2026-10-09 的 X 发帖、提供给 TechCrunch 的内部备忘录与发言人表述;「三名研究员的说法」来自公开信 PDF 原文与其本人在 X 上的说明。两类表述均已标注来源,本文不对事实争议作裁决。


