一句话总结
9 月底,独立数学家顾问组刚建议 AI 公司「不要把数学成果当营销工具」;10 月 7 日,OpenAI 就把 722 篇数学手稿一次性推上了 GitHub。这些手稿来自一个内部未发布的模型,官方口径是:平均每个结果花掉约 3 小时 ChatGPT Pro 算力,整个评测过程中模型被喂了大约 4000 道题,最后聚合成 372 个结果族。其中最受关注的一处,是 README 里点名的 CM 阿贝尔簇上的 Hodge 猜想——千禧年七大难题之一。
数据来源:OpenAI 官方仓库 openai/math(2026-10-07 首次提交,README / CONTENTS.md / formalization.yaml / overview.pdf 均取自仓库公开文件)、The Verge 同日报道(记者 Robert Hart)。
这次放出的到底是什么
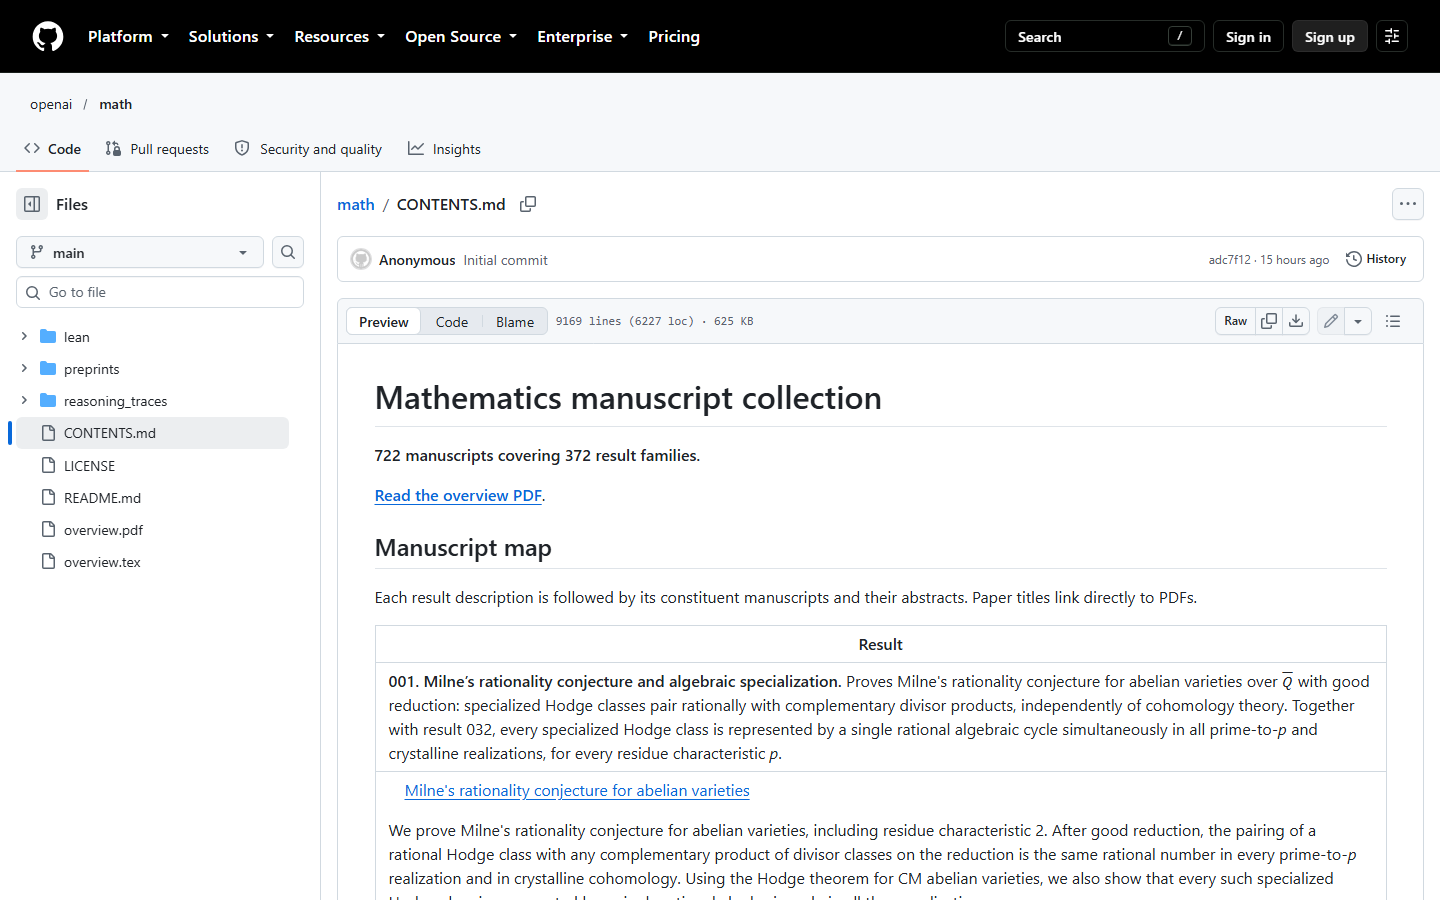
不是一篇论文,也不是一个基准分数,而是一整个资料库。openai/math 仓库根目录下并列着四个东西:preprints/(722 个目录,每个放 PDF、源文件与引用说明)、lean/(形式化证明库与 formalization catalog)、reasoning_traces/(抽出的推理摘要)、以及一份把全部结果串起来的 CONTENTS.md 清单。README 对仓库内容的定义只有一句:
This repository contains mathematical manuscripts and supporting proof artifacts produced by an internal OpenAI model.
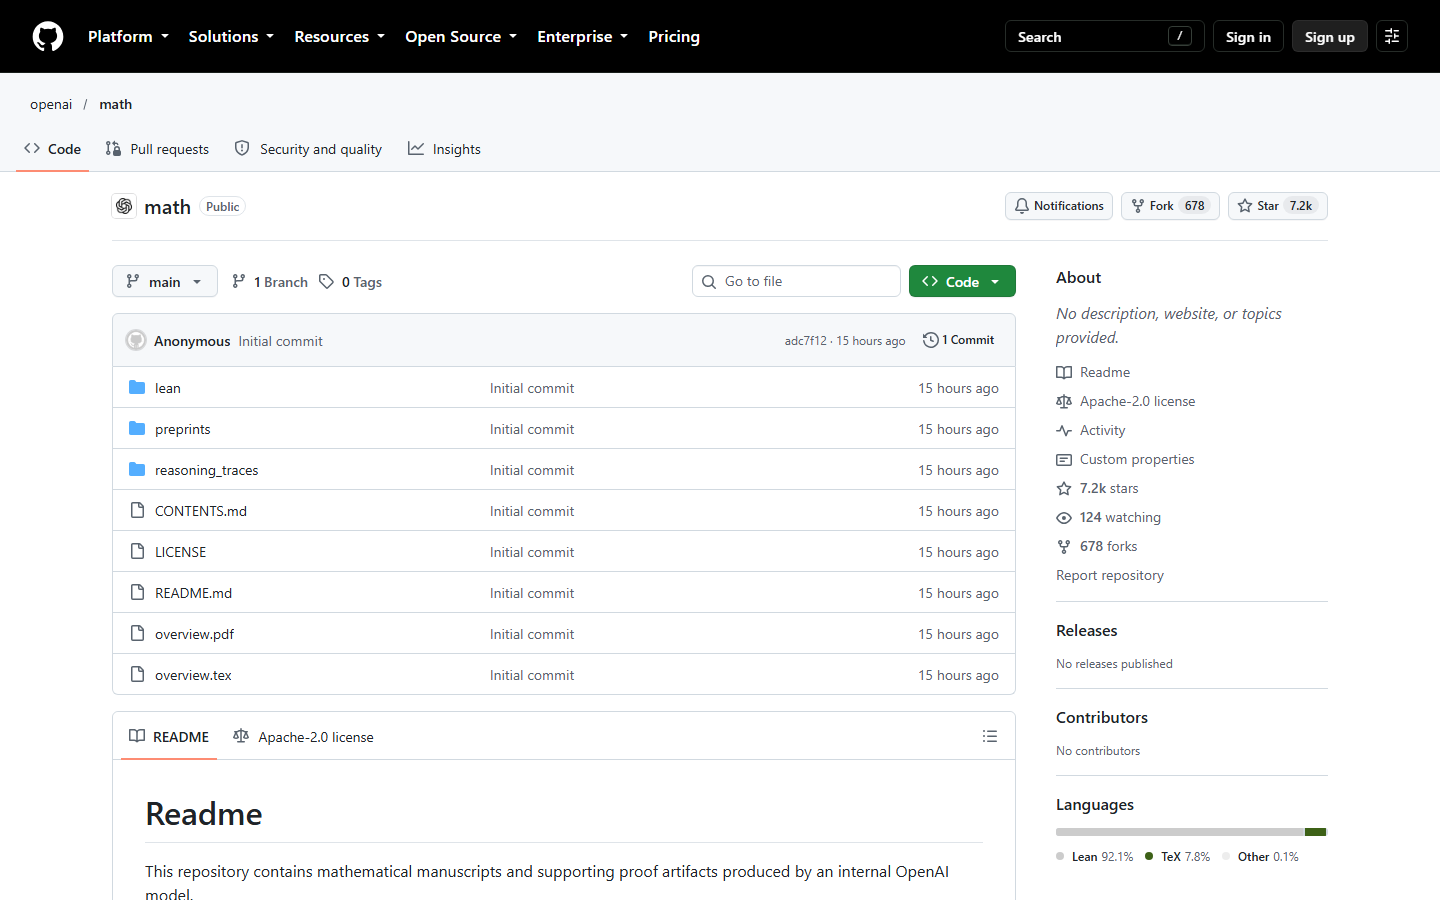
一个直观的细节:仓库只有 1 次 commit,作者显示为 Anonymous,License 是 Apache-2.0。它不是「开源研究过程」,而是一次性的成果倾倒——这也正是争议的起点。
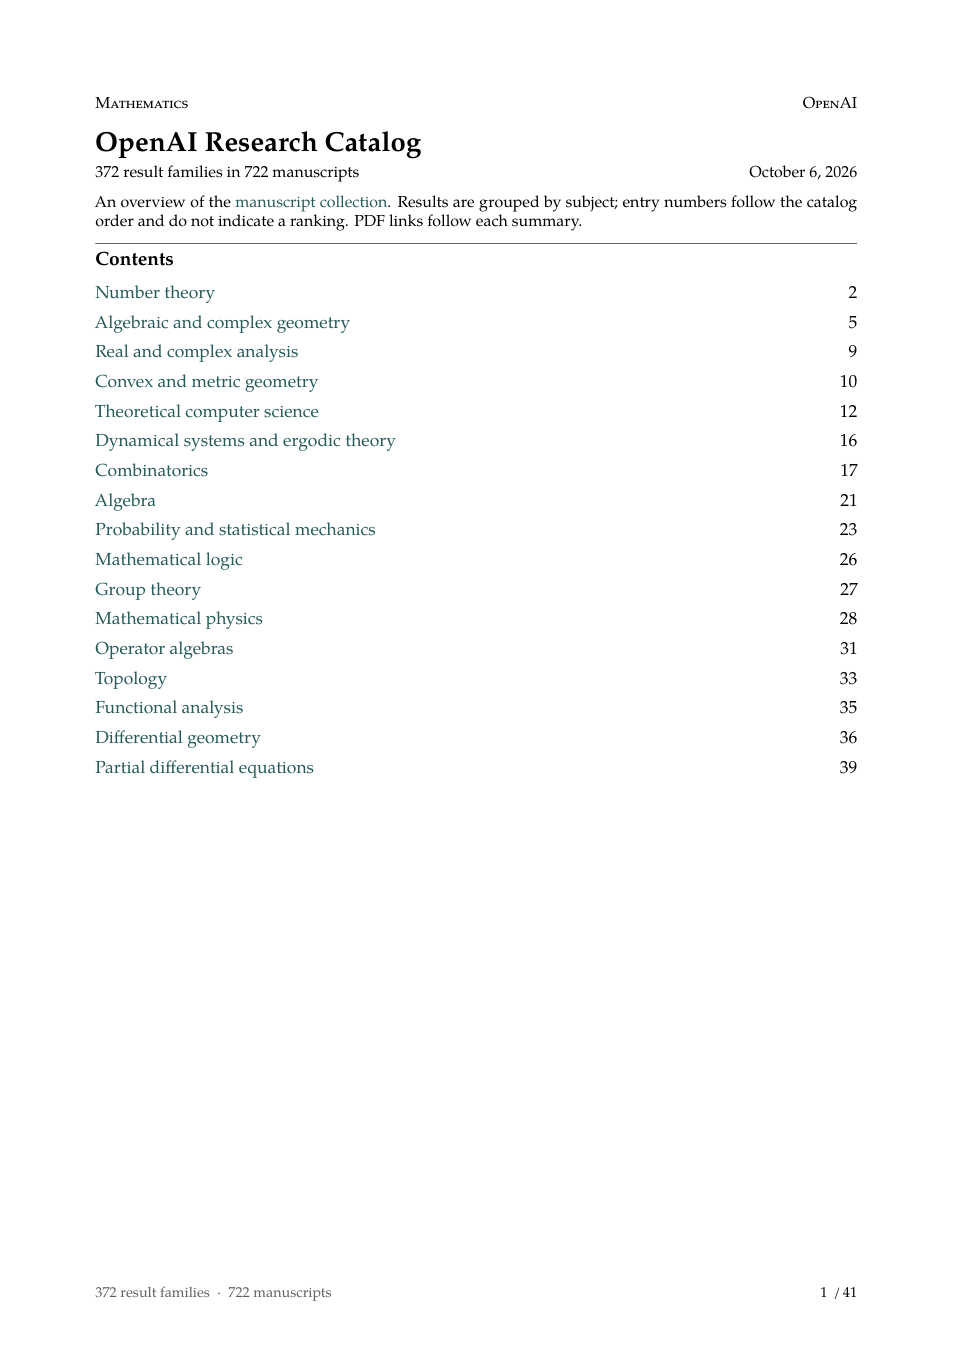
按 overview.pdf 的分支目录,这些结果铺得很开:数论、代数与复几何、实与复分析、凸几何、理论计算机科学、动力系统与遍历论、组合数学、代数、概率与统计力学、数理逻辑、群论、数学物理、算子代数、拓扑、泛函分析、微分几何、偏微分方程……基本覆盖了纯数学的主要分区。
数字怎么来的:约 4000 道题、每个结果约 3 小时
README 里有一段把口径写得很清楚的话,值得原样记住:
On average, each result used three hours of ChatGPT Pro thinking compute with that model. Over the course of the evaluation, the model was posed approximately 4,000 problems.
翻译一下:模型被喂了大约 4000 道开放研究问题,平均每个最终结果消耗约 3 小时的 ChatGPT Pro 级思考算力;随后把输出聚合成结果族与手稿,并「要求达到适当的显著性水平」,才得到现在这份目录。
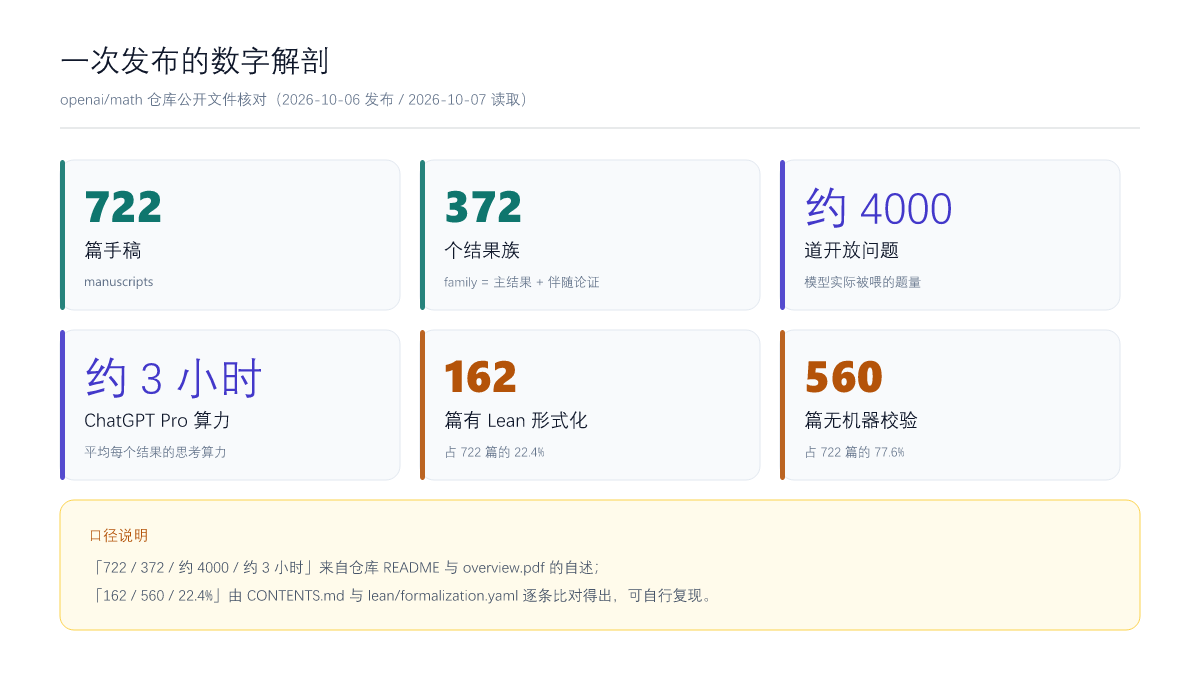
这里有个容易被忽略的口径差异:README 说的是被喂了约 4000 道题,而最终公布的是 722 篇手稿 / 372 个结果族。也就是说,题目数量远多于产出数量——中间经过了「聚合 + 显著性筛选」。OpenAI 自己把这段写成了方法说明,而不是把 4000 道题都算成「成果」。
另外附带说明:OpenAI 在 9 月曾表示其模型「在大多数数学领域解决了 100 多个长期开放问题」。从「100 多个开放问题」到这次的 372 个结果族,规模确实在放大。
校验的缺口:162 篇有 Lean,560 篇没有
这是整件事里最该盯住的地方。
仓库带了一个 Lean 形式化库(lean/formalization.yaml)。把 722 个手稿目录与形式化目录逐条对齐后,能对应到形式化证明的约为 162 篇,占 22.4%;剩下约 560 篇(77.6%)没有机器可查的证明。这不是外界猜的,是仓库自己的数据能算出来的。
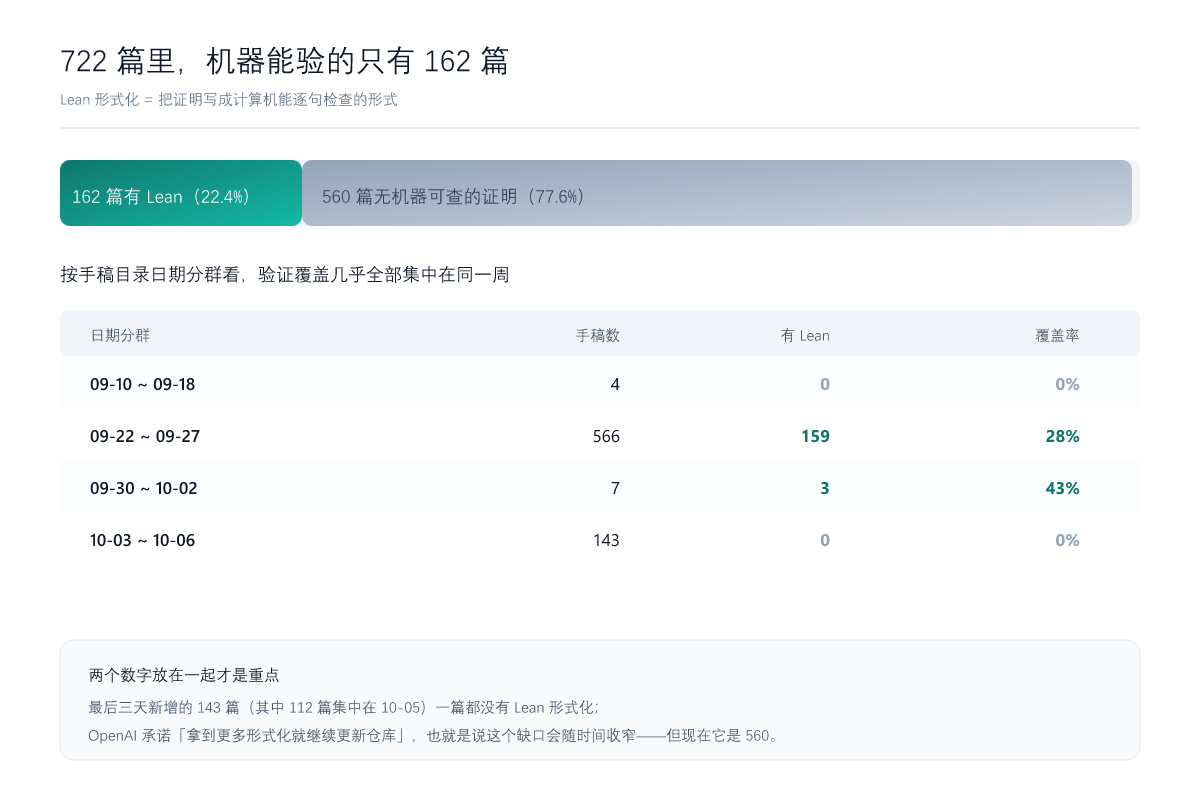
更值得说的是时间分布:把目录名里的日期拆开统计,9 月 22 日至 27 日那批(共 566 篇)里有 159 篇带 Lean;而最后几天新增的 143 篇(10 月 3–6 日,其中 112 篇集中在 10 月 5 日)一篇都没有 Lean。换句话说,越是新近的结果,越缺机器校验。(另有 2 个目录未标注日期,因此这里按 720 篇分组。)
OpenAI 对此没有回避,README 原文是:
This collection includes results at different stages of verification. Not all have accompanying Lean formalizations. We will continue to update this repository with Lean formalizations as we obtain them.
后一句还补了半句:「部分未形式化的结果可能存在问题」(Some of the unformalized results could have issues)。这句自我保留,比任何外部质疑都更有分量——它等于承认:722 这个数字里,混着不同成熟度的东西。
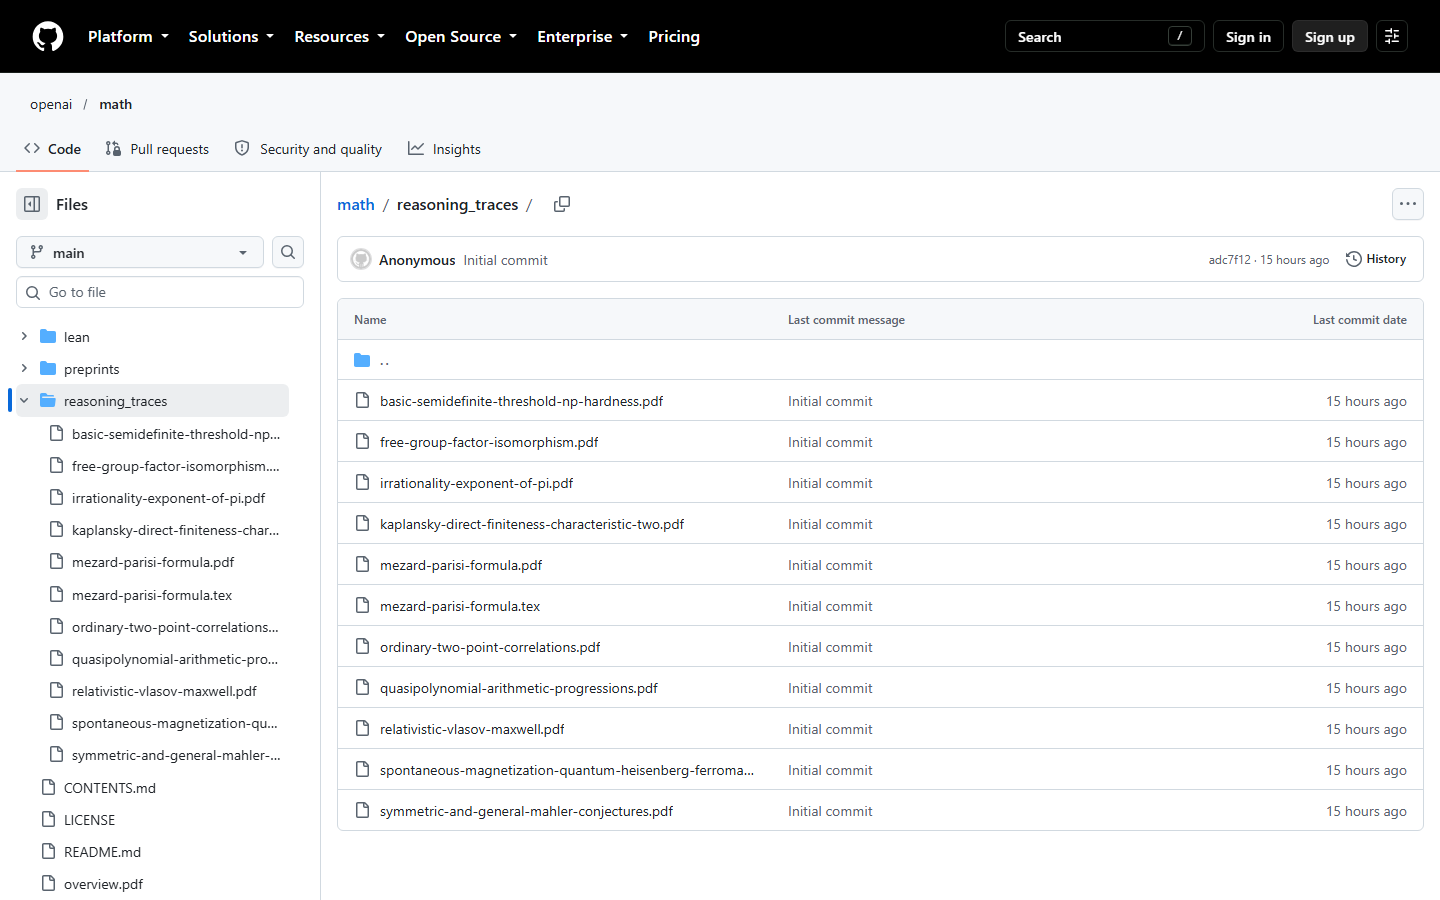
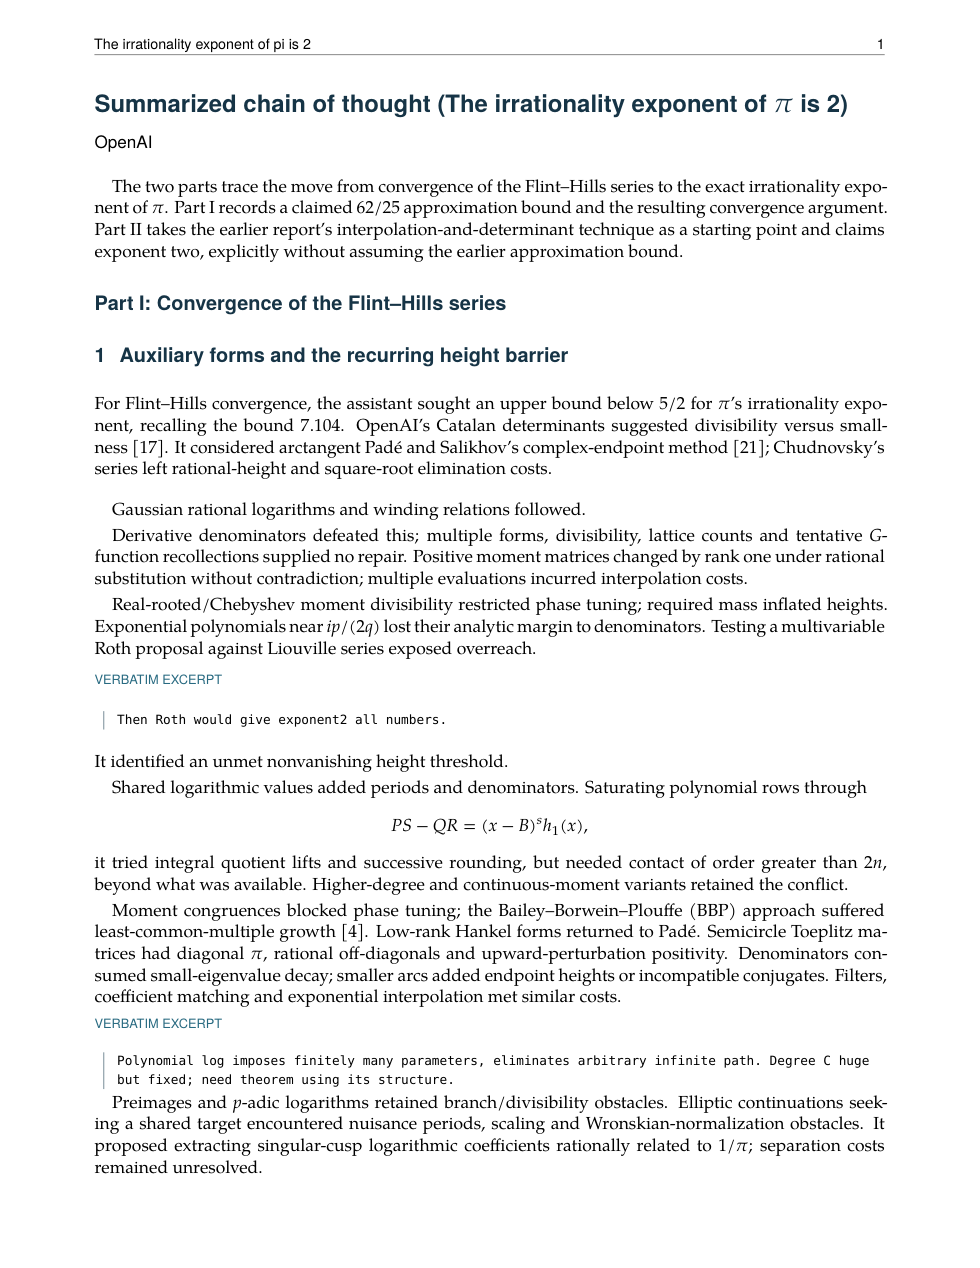
好消息是,模型这次不只交了结论,还交了思维过程摘要。reasoning_traces/ 目录下公开了 10 个结果族的推理链(族 007、017、087、102、159、197、221、271、287、362),从「π 的无理指数是 2」到「Mézard–Parisi 公式」,都是可以逐段读的。
两处例外:Hodge 猜想与 ζ 函数
README 把「不按标准流程走」的工作单独点了出来:
Exceptions to this fixed procedure include work on a zero-free region for the Riemann zeta function and proof of the Hodge Conjecture for CM abelian varieties.
CM 阿贝尔簇上的 Hodge 猜想——Hodge 猜想本身是千禧年七大难题之一,CM 情形是它的一个重要特例方向。The Verge 在报道里也确认,这批结果中「包含与一个千禧年难题相关的结果」。另有黎曼 ζ 函数的无零点区域工作,其中 Re(s) > 11/12 的那份写作为了可读性经过了人工编辑——这一条 OpenAI 主动写在了 README 里,属于必要的披露。
需要说清楚的是:这不等于千禧年难题被解决。README 只说自己做了 CM 情形的证明工作,而完整 Hodge 猜想仍在开放状态。把它读成「AI 攻克千禧年难题」,是对这批材料最常见的误读。
时机很微妙:顾问组 9 月底刚说「别把数学当营销」
更耐人寻味的是时间线。今年 9 月底,一个名为 AGMAI(Advisory Group on Mathematics and Artificial Intelligence)的独立数学家顾问组发布了第一份建议,其中明确要求 AI 公司:
- 尽快发布数学结果,且尽量走既有学术渠道;
- 披露模型名称、提问方式与算力成本;
- 「不要把数学结果的发布当作推广自家模型的营销手段」(refrain from treating the release of mathematical results as marketing vehicles)。
不到两周,722 篇手稿就以「一次 commit 全量倾倒」的方式上线了。OpenAI 对此的说明是:这批结果通过 GitHub 仓库发布,带有论文修订与引用协议,同时也在探索其他符合委员会指南的社区托管方案。
客观地说,这次发布确实附带了算力估算、题目数量、推理摘要和形式化清单,比「只发一条推文宣布突破」要透明得多。但「GitHub 一次性倾倒 722 篇、其中 560 篇没有机器校验、全部未经同行评议」这套做法,仍然把数学界推到了一个不轻松的位置:没有任何一个数学社区能在一夜之间消化 722 篇手稿。
争议的另一半指向更现实的问题:这些结果建立在大量人类数学家的既有工作上,如何署名、如何引用、如何区分「模型独立完成」与「模型站在前人肩膀上」,行业至今没有共识。The Verge 的报道把这一年的状态概括为——AI 实验室冲进数学的速度,已经让研究实践、学术伦理与署名规则同时承压。
为什么这件事值得记一笔
抛开立场,三个可验证的事实值得留下:
- 规模真实存在:722 篇手稿、372 个结果族、约 4000 道题的评测过程,都能在公开仓库里逐条点开核对,不是宣传语。
- 校验缺口是明账:能对上 Lean 形式化的约 162 篇(22.4%),越新的批次越少;OpenAI 自己也承认未形式化的部分「可能存在问题」。这个比例,比「多少个开放问题被解决」更能说明当前的水平与边界。
- 发布机制正在被倒逼成形:顾问组的建议、仓库的修订与引用协议、推理摘要的公开,都是这一轮之后才被迫明确下来的规则。对后来者来说,这套「怎么发、发什么、披露到哪一层」的默契,可能比 722 这个数字更有长期价值。
对普通用户而言,最直接可用的部分反而是 reasoning_traces/ 里那 10 份推理摘要——它们展示了大模型在真实前沿问题上的思考长相:不是灵光一闪,而是大量失败的路线、被排除的构造和一步步收紧的界。想理解「AI 做数学」到底长什么样,从那里开始读,比看新闻标题有用得多。
总结
- 10 月 7 日,OpenAI 在 GitHub 公开
openai/math:722 篇手稿 / 372 个结果族,来自内部未发布模型; - 官方口径:评测约 4000 道题,平均每个结果约 3 小时 ChatGPT Pro 算力,结果经聚合与显著性筛选;
- 校验是明账:约 162 篇带 Lean 形式化(22.4%),其余约 560 篇未经机器校验,全部未经同行评议;
- README 点名两处例外:CM 阿贝尔簇的 Hodge 猜想与 黎曼 ζ 函数无零点区域(后者写作经人工编辑),但完整 Hodge 猜想仍开放;
- 发布时机紧贴 AGMAI「别把数学当营销」的建议,把「AI 与数学界如何相处」的问题从伦理讨论推向了具体机制。
图片出处:封面与「数字解剖」「校验缺口」示意图由 UU AI Hub 自制;仓库首页、CONTENTS.md、reasoning_traces 目录、overview.pdf 与 π 推理摘要页面取自 OpenAI 公开仓库 openai/math。


