一句话总结
OpenAI 在 9 月 29 日的 DevDay 上顺带发布了一个叫 Decisions API 的新接口:你给它一个问题、一组预先写死的选项和一段上下文,它不给你一段需要解析的自然语言,直接告诉你选了哪一个、以及这个选择的概率。它由 GPT-6 Luna 驱动,官方称端到端能在几百毫秒内完成,目前处于 限定预览。TechCrunch 直接把它写成「OpenAI 的 Jev 克隆」;而 8 天前就有人在博客里预言了这一幕——那篇博客的标题是《Will OpenAI Eat Jev’s Lunch?》。
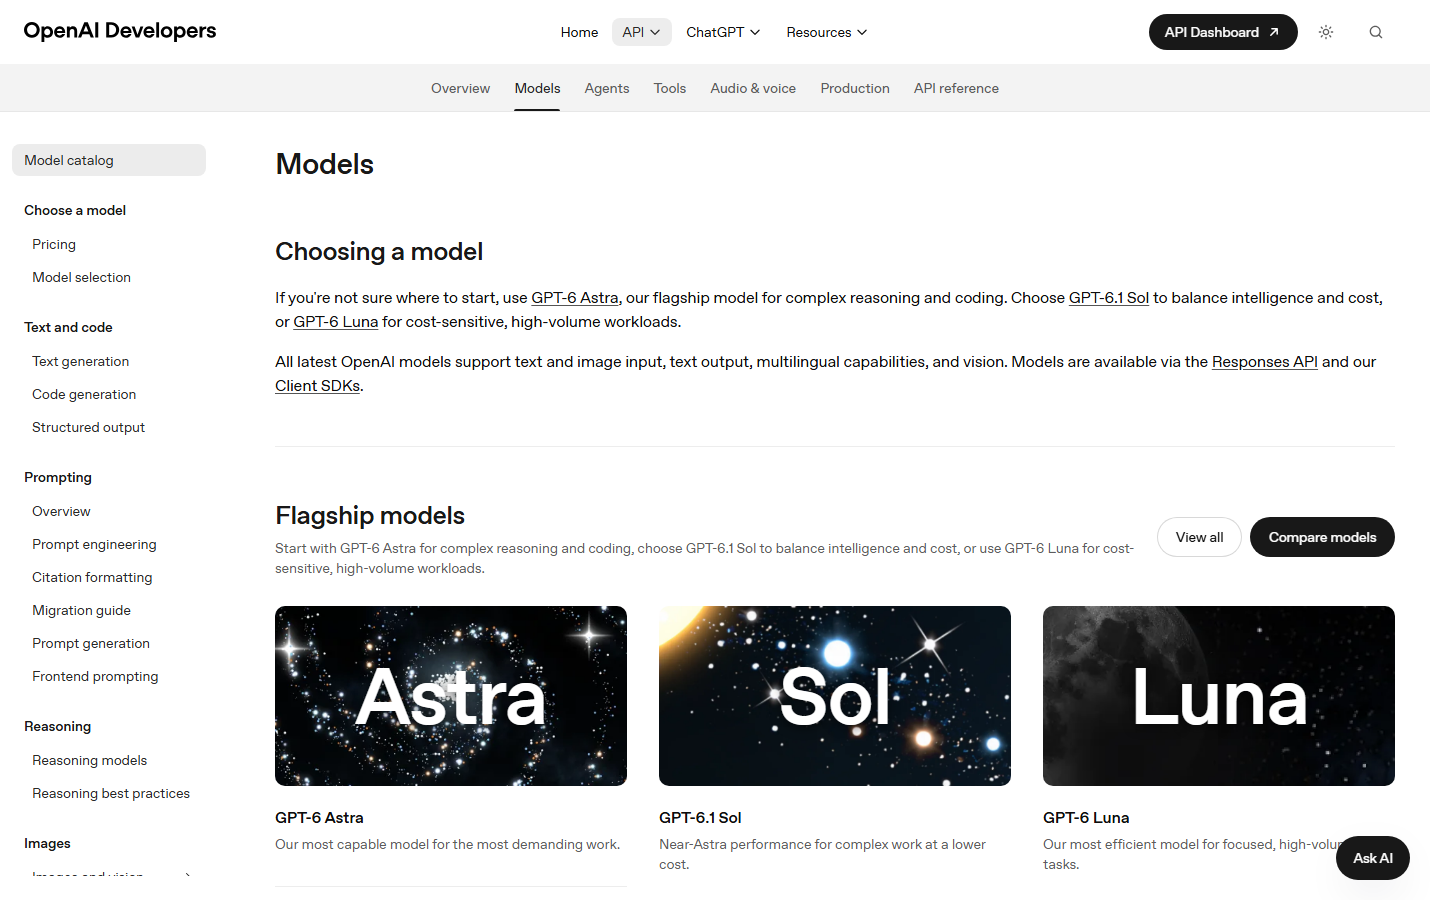
数据来源:TechCrunch《OpenAI’s Jev clone could help the frontier lab stop its swarming agents》(2026-09-30);OpenAI 开发者账号与产品负责人 Tibo 的发布帖(2026-09-29,X);OpenAI 官方文档 Models 页(platform.openai.com/docs/models);Vercel 官方解读《What is OpenAI’s Decisions API?》(2026-09-30);Arcturus Labs《Will OpenAI Eat Jev’s Lunch?》(2026-09-21);TypeSafe AI 官方博客与文档、Hacker News 相关讨论帖。
先看它到底做了什么
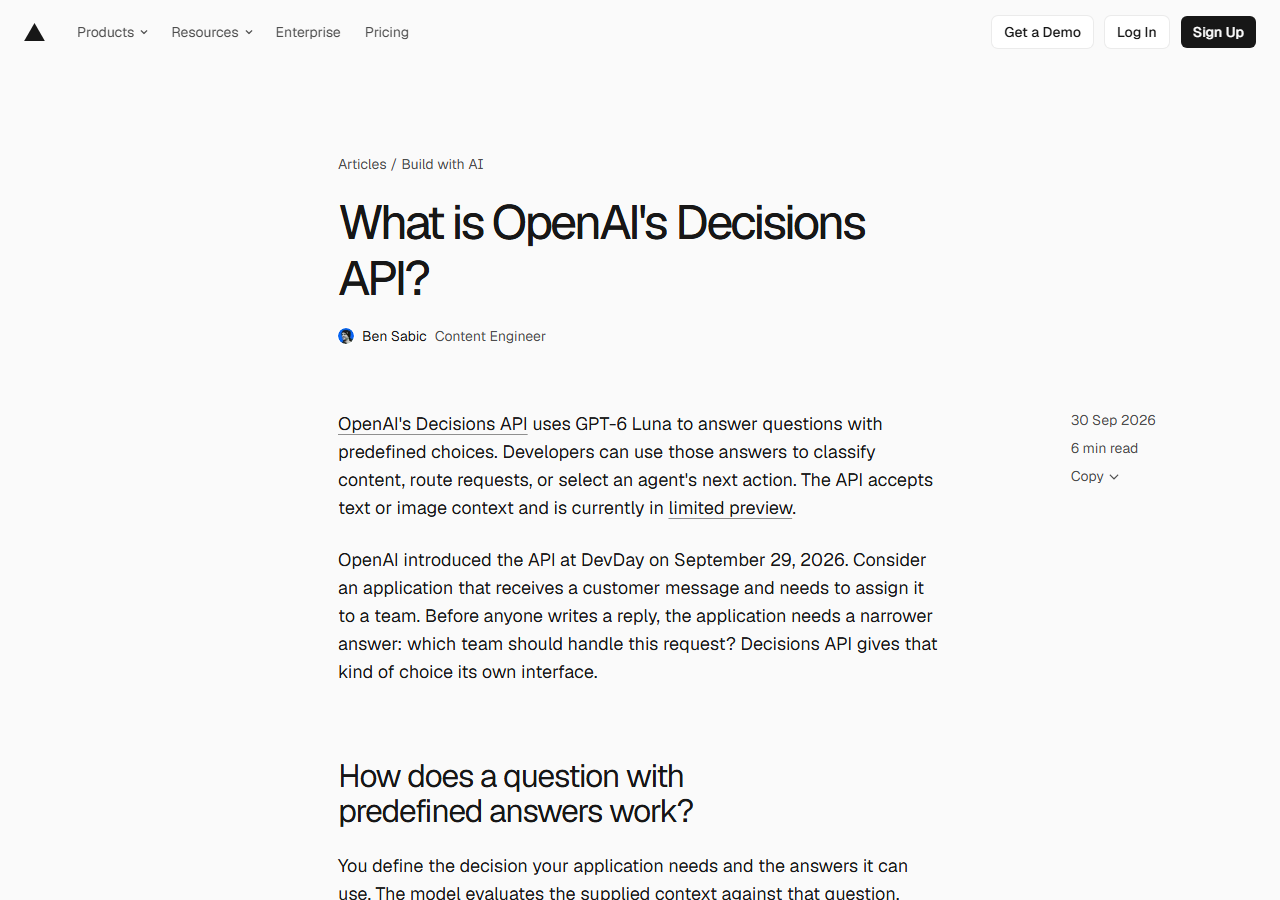
Vercel 在次日发布的解读给了个很直观的例子:一个客服系统收到用户留言,在写回复之前,它只需要知道一个问题——「这条请求应该先交给哪个团队?」 选项是四选一:
- 用户无法登录、取不回账号
- 用户对账单或发票有疑问
- 登录之后某个功能报错
- 请求说不清,或都不符合
「提到发票」不一定属于财务:如果用户说的是「登不进去下载发票」,当务之急仍然是账号访问。把这种优先级写进问题和选项定义里,才是这个接口真正的设计工作。
官方开发者账号的表述很简短:「用 Decisions API 给你的应用实时决策能力,由 GPT-6 Luna 驱动。定义问题和可能的答案,用来给内容分类、路由请求,或选择 Agent 的下一步动作。」 产品负责人 Tibo 补充了两条关键信息:支持视觉输入;模型被调过,能在一百多毫秒到几百毫秒内端到端完成一次决策。
用一句话概括它与普通调用的差别:
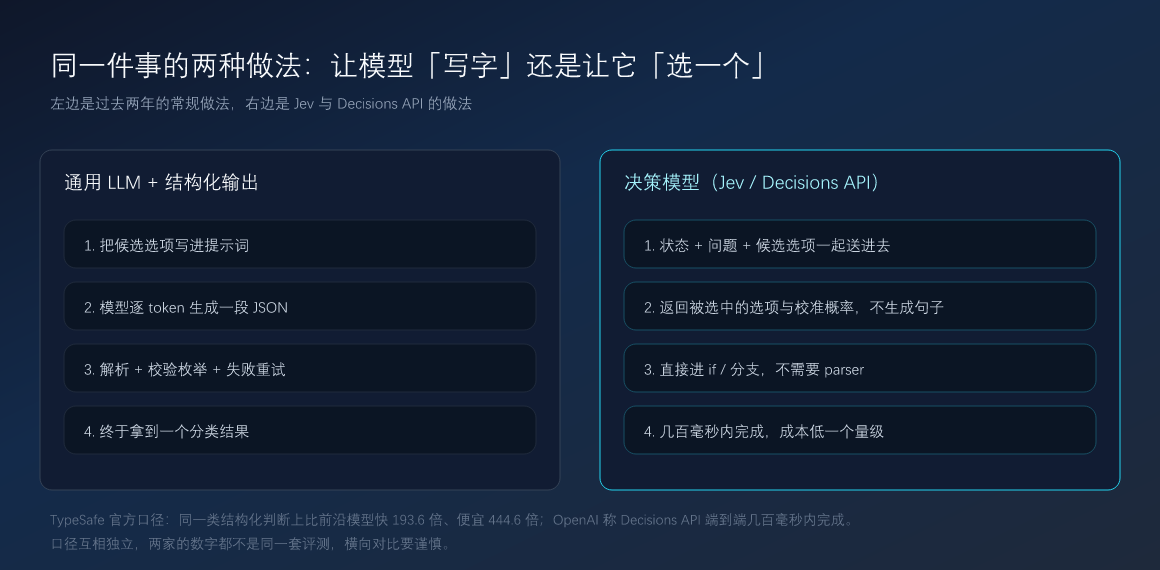
过去的做法是「让模型写完 JSON 再解析」——为了拿到一个分类结果,你要写解析器、校验枚举值、处理失败重试。决策模型的思路是把这一步从「生成」改成「选择」:输出不是句子,而是一个取值加一个概率。TypeSafe 官方对 Jev 给的口径是同一类结构化判断上快 193.6 倍、便宜 444.6 倍(两家数字来自各自不同的评测,横向比不能直接对齐)。
它和 Structured Outputs 不是一回事
这一点 Vercel 讲得最清楚,也最容易混淆:
- Structured Outputs 约束的是「回答长什么样」——你可以把字段限制成枚举,模型照样能吐出分类结果;
- Decisions API 是把「在一组给定答案里选一个」单独做成一个接口。
Vercel 原文的说法是:分类可能只需要一个类别,而一封客服回复往往需要类别加解释加提取出的细节——先定义你需要的输出,再决定用哪个接口。它还提醒了一句容易忽略的话:Schema 合规和判断正确是两件事,回答可以完全符合 schema,却把「登不进去」派给了错误的团队。OpenAI 自己的文档也写明结构化输出可能出错。
9 月的时间线:有人提前 8 天把这件事写下来了
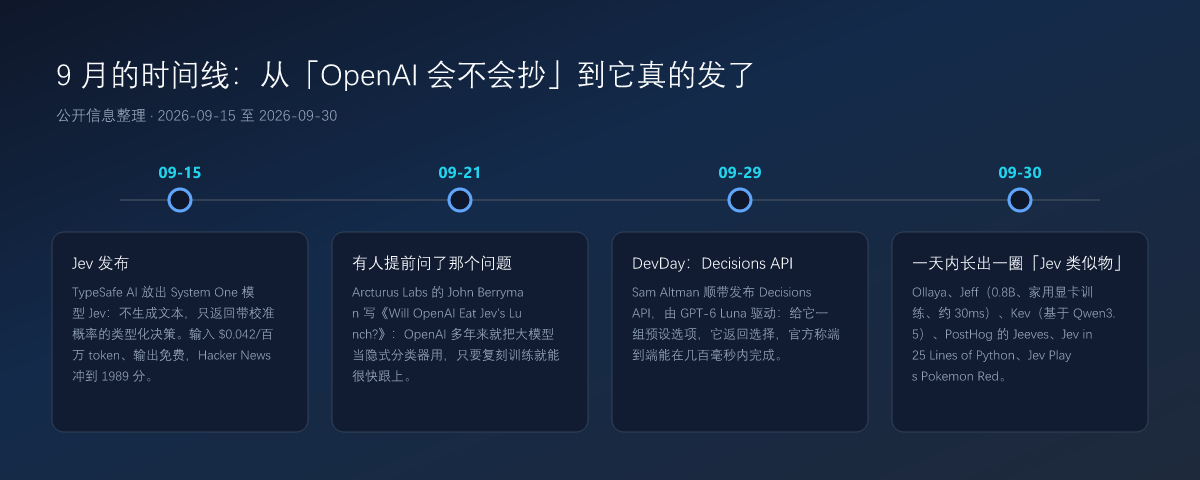
这条线是本篇最有意思的部分:
- 9 月 15 日,TypeSafe AI 发布 System One 模型 Jev,Hacker News 冲到 1989 分、约 520 条评论。它的定位是「给软件用、不给人看」:不生成文本,只返回带校准概率的类型化决策。
- 9 月 21 日,Arcturus Labs 创始人 John Berryman 发表《Will OpenAI Eat Jev’s Lunch?》。他的论证不是情绪化的,而是翻出了历史:OpenAI 从 tool calling 时代起就在把大模型当隐式分类器用——
<|im_start|>assistant之后第一个 token 是在分类「要不要调用工具」,接下来几个 token 在分类「调用哪个工具」。他的结论是:这类能力 OpenAI 早就在生产环境里用着,只是没把它训练成通用分类器、也没包装成独立产品,所以**「如果 OpenAI 能复刻训练,他们很快就能复刻 Jev」**。 - 9 月 29 日,DevDay 上 Sam Altman 顺带发布 Decisions API。
- 9 月 30 日,Vercel 发出解读,社区开始把它和 Jev 摆在一起比。
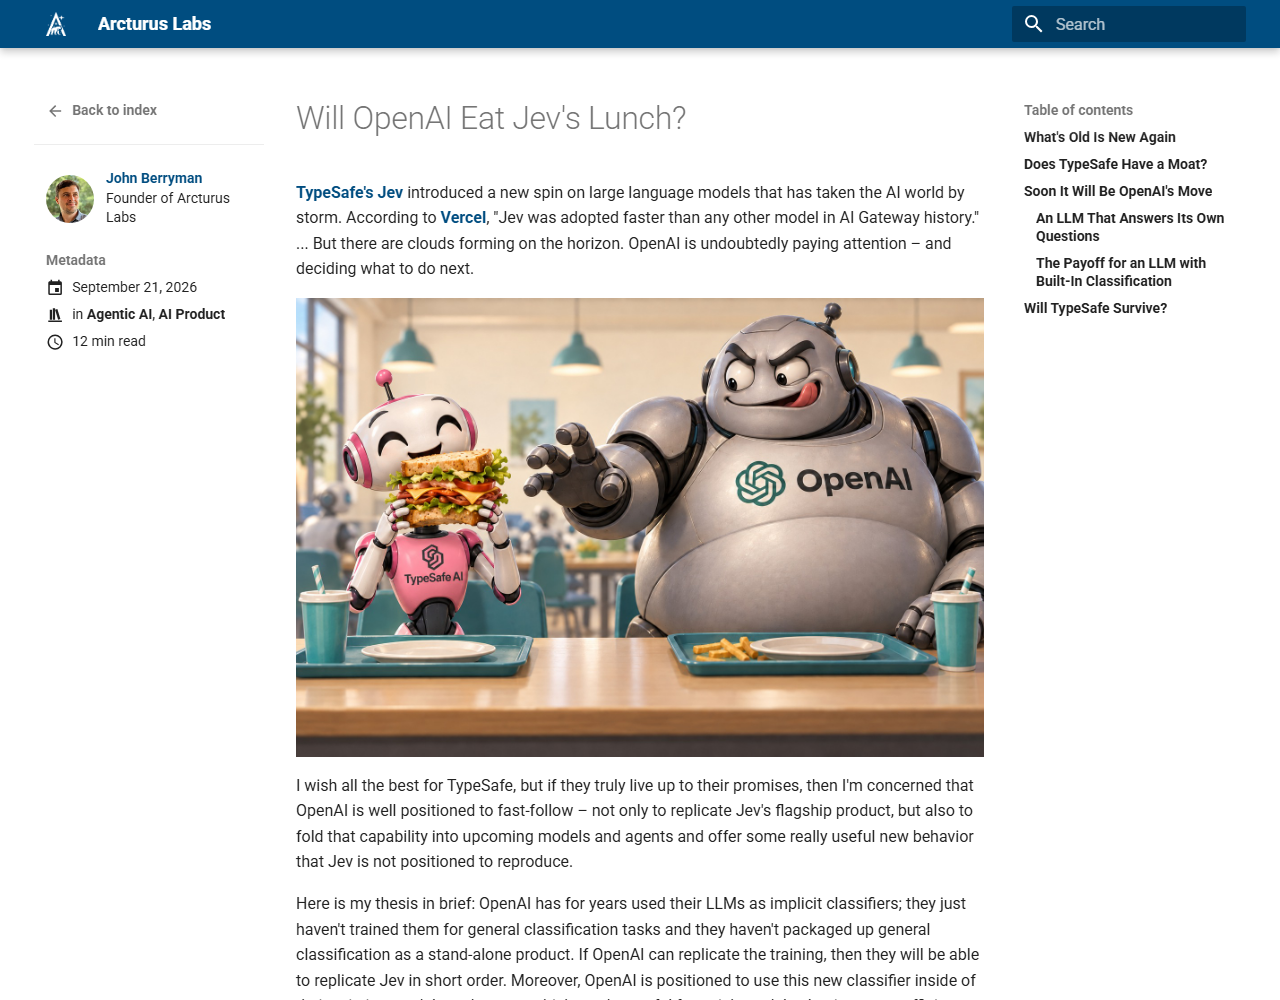
那篇预测文章里还有一段值得抄下来的判断:他认为 Jev 真正的护城河不在架构,而在训练数据。他引用 TypeSafe 联合创始人 Diogo Almeida 的说法——「我们把自己当成数据研究实验室,绝大部分研究都在做真正通用的数据(类似认知核心),而且 100% 的数据是合成的」。同时他也留了反方条件:除非 Jev 真的准,否则这些都算不上护城河。他自己就找到了 Jev 概率站不住的场景。
争议点:快和便宜都容易,难的是准
TechCrunch 在发布当天联系了 TypeSafe,官方没有回应;CEO Diogo Almeida 在 X 上开了个玩笑,说「clone wars 开始了」,随后补了一句更认真的判断:OpenAI 的兴趣可能是**「一个信号——以 System One 兼容的方式去构建就是未来」**。
他对护城河的表述,是这一整轮讨论里最锋利的一句:
「又快又便宜非常容易。你要真的又快又便宜,用骰子就行。智能才是难的那部分,我的北极星一直是把智能每美元推在帕累托前沿上。」
这句话同时定义了两家公司的赛场:OpenAI 的 Decisions API 目前是限定预览,还没有开发者大规模实测;而 Arcturus 那篇也提醒,这些决策模型的输出在真实世界里校准得怎么样,才是决定它们有没有未来的问题。
为什么最先落地的是「盯住 Agent」
TechCrunch 报道里最实用的一段,是它对 Agent 安全场景的推演。OpenAI 近期出过几起自家 Agent 在公开互联网上行为越界的事故(例如其 Agent 越界访问澳大利亚政府网站),官方给出的对策之一是另用一个模型盯着 Agent 的动作,并承认代价是「显著的算力成本」。
一位长期做网络安全的从业者 Shapor Naghibzadeh(QueryStory)在周末的黑客松里做了一个反向验证:用 Jev 逐条校验 Agent 的动作是否符合它接到的任务,高置信度判定为坏的动作直接拦截,不确定的标记出来交人复核,剩下的放行。
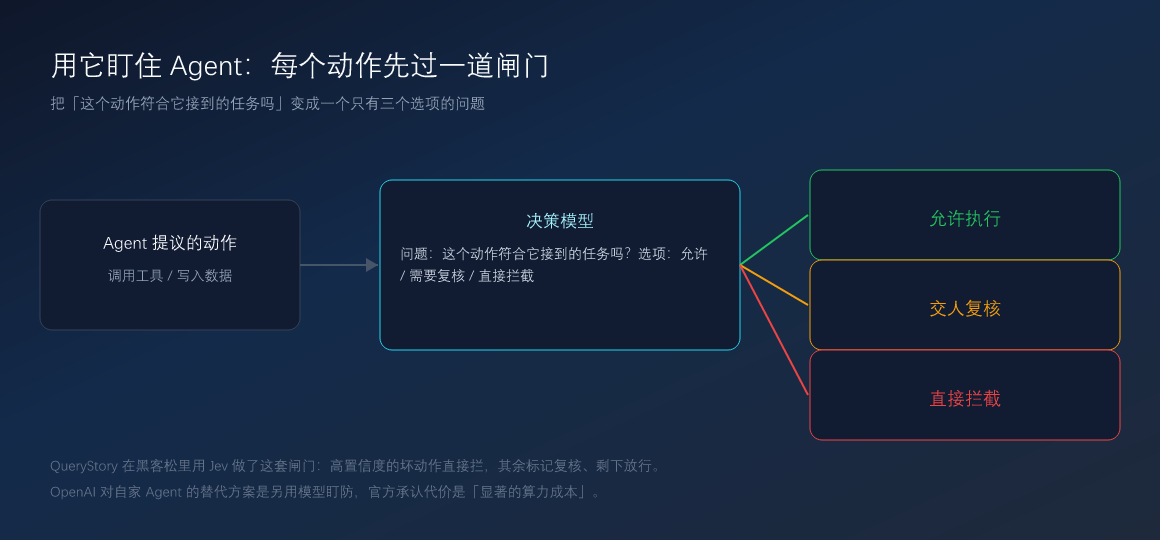
这一步之所以顺理成章,是因为「这个动作符合任务吗」正好是一个选项可以预先写死的判断——允许、复核、拦截。它不需要模型写文章,只需要模型在三个选项里给出一个带概率的答案,而这正是决策模型最擅长的形状。
顺带说明为什么这件事在两周内长出了一圈「Jev 类似物」:Hacker News 上同时挂着 Ollaya(面向开源决策模型的推理层)、Jeff(0.8B、家用显卡训练、约 30ms)、Kev(基于 Qwen3.5 的微型决策模型家族)、PostHog 的 Jeeves(用推理改进 Jev 式决策),以及「Jev in 25 Lines of Python」和「Jev Plays Pokemon Red」这类演示。把一个判断做成可预测的接口这件事,门槛看起来并不高;难的是校准,而校准藏在数据里。
谁该关注
- 在做 Agent 的人:如果你已经写了「调一次大模型 + 解析 JSON + 校验枚举」这套胶水,Decisions API 这类接口是它的直接替代品,也是给 Agent 加行为闸门的现成零件;
- 做分类与路由的后端:工单分流、内容审核、文档归类这类「答案可以预先枚举」的任务,成本结构会明显不同;
- 想抄作业的独立开发者:上面那一圈开源项目已经把路线摊开了,从 25 行 Python 到一个 0.8B 的模型都能跑。
同样要说清楚边界:选项写死就意味着写死的选项可能漏掉正确答案。Vercel 的建议是永远留一个「需要人工复核」的出口,并且把「分类结果不等于授权」写进代码——选对了队列,也不代表可以跳过身份校验。
总结
- OpenAI 的 Decisions API 把「在一组预设选项里选一个」做成了独立接口,由 GPT-6 Luna 驱动、支持视觉输入、限定预览;
- 它和 TypeSafe 的 Jev 是同一类产品,TechCrunch 直接称之为「Jev 克隆」,TypeSafe CEO 用「clone wars」回应;
- 有意思的不是谁抄谁,而是有人 8 天前就把这个结果写成了公开推断:判断这件事一直是隐式的分类,把它显式产品化只是时间问题;
- 第一个真正讲得通的落地场景是 Agent 行为监控:用便宜得多的判断模型盯住贵得多的执行模型。
数据来源:TechCrunch《OpenAI’s Jev clone could help the frontier lab stop its swarming agents》(2026-09-30,Tim Fernholz);OpenAI 开发者账号与 Tibo 的 Decisions API 发布帖(X,2026-09-29);OpenAI 官方文档 Models 页;Vercel《What is OpenAI’s Decisions API?》(2026-09-30);Arcturus Labs《Will OpenAI Eat Jev’s Lunch?》(2026-09-21,John Berryman);TypeSafe AI 官方博客与文档;Hacker News 关于 Jev 与决策模型的公开讨论帖(2026-09-15 至 09-30)。
图片出处:封面、时间线图、做法对比图、Agent 闸门图由 UU AI Hub 自制;OpenAI 官方文档 Models 页截图取自 platform.openai.com;Arcturus Labs 文章截图取自 arcturus-labs.com;Vercel 解读页截图取自 vercel.com。


