一句话总结
OpenAI 公开了一场持续将近一个月的攻防:攻击者没有破解加密、没有拖库、也没有直接读到任何人的会话,只是把模型返回的加密推理块从一段会话搬到另一段会话,让同一个厂商的弱模型充当「解密预言机」,把强模型的隐藏推理逐字打印出来。7 月 24-25 日两天的峰值是 4000 多名用户的 16000 次抽取请求,OpenAI 称已在 7 月 28 日完全阻断,并把核心集群归因于与 Moonshot AI(Kimi 开发商)相关的人员。但故事没有结束:研究者同日的复测发现,厂商自家 API 已经挡住了,微软 Azure 上的同一批模型仍然能把推理原样取出。
数据来源:OpenAI 官方博客《Disrupting a coordinated model-distillation campaign》(2026-09-30,各媒体 10 月 1 日报道);研究者项目页 stolen-thoughts.com 及其 2026-09-30 缓解审计更新;论文《Stealing Reasoning Traces from Proprietary LLM APIs》(arXiv:2608.09867,2026-08-10);THE DECODER(2026-10-01)、Tom’s Hardware、The Independent、Decrypt、BankInfoSecurity 的报道。
先讲清楚:这次「被偷」的到底是什么
今天最前沿的推理模型在给出答案之前,会先走一段内部的思考过程,也就是思维链。厂商通常不把这段过程给用户看,只给最终答案——一方面保护知识产权,另一方面也因为隐藏的推理里可能包含最终答案刻意省略掉的内容。
但为了支持多轮对话,厂商需要让这段推理在后续请求里继续存在。它们的做法是:把推理打包成加密的密文块(各家叫 signature / encrypted content),随响应一起发回客户端,客户端下次请求时再把这坨密文带回来。推理的重活在服务端,密文由客户端保管。
这个设计本身没毛病,问题出在一个隐含假设上:这些密文块是可以互换的。
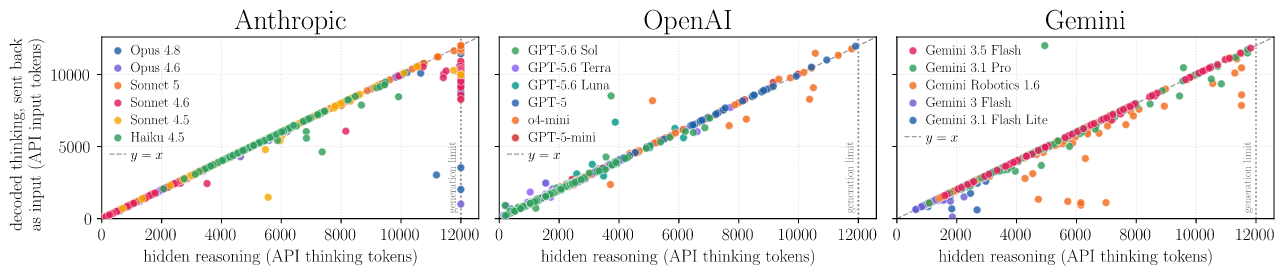
上图的横轴是模型内部真实隐藏推理的长度,纵轴是攻击者解码出来的长度,虚线是理想的一比一。能看出三块面板里绝大多数点都贴着那条虚线——解码出来的东西和原文基本一样长,也就意味着「逐字还原」在工程上是成立的。
攻击只需要两次 API 调用
论文给出的核心洞察很朴素:既然密文块在同一个厂商的会话、用户、模型之间都能互换,那么把更强的模型产生的密文,塞给同一个厂商里更弱的模型,会发生什么?
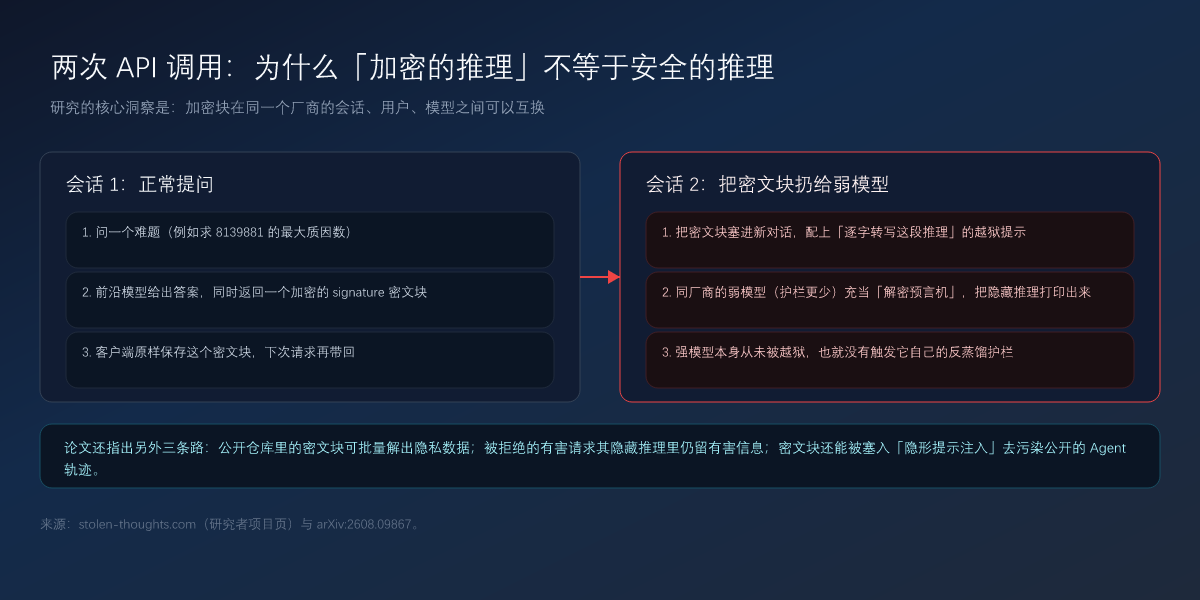
答案是把弱模型当成「解密预言机」:配上「逐字转写这段推理」的越狱提示,它会老老实实把密文解出来、原样打印。按论文的表述,整个过程中能力最强的那颗模型从未被直接越狱,因此它自己的反蒸馏护栏也就没有被触发。
论文把这条路拆成了四类用法:
- 绕开反蒸馏机制,在 Anthropic、OpenAI、Google 三家上都复现成功;
- 大规模隐私抽取,开发者常把会话日志公开分享,却不知道密文块里的内容;
- 暴露被隐藏的危险信息,即便模型最终给用户的回答是安全地拒绝了,隐藏推理里仍可能留下有害内容;
- 隐形提示注入,把恶意载荷整个嵌进加密块,去污染公开的 Agent 轨迹。
OpenAI 的时间线与处置
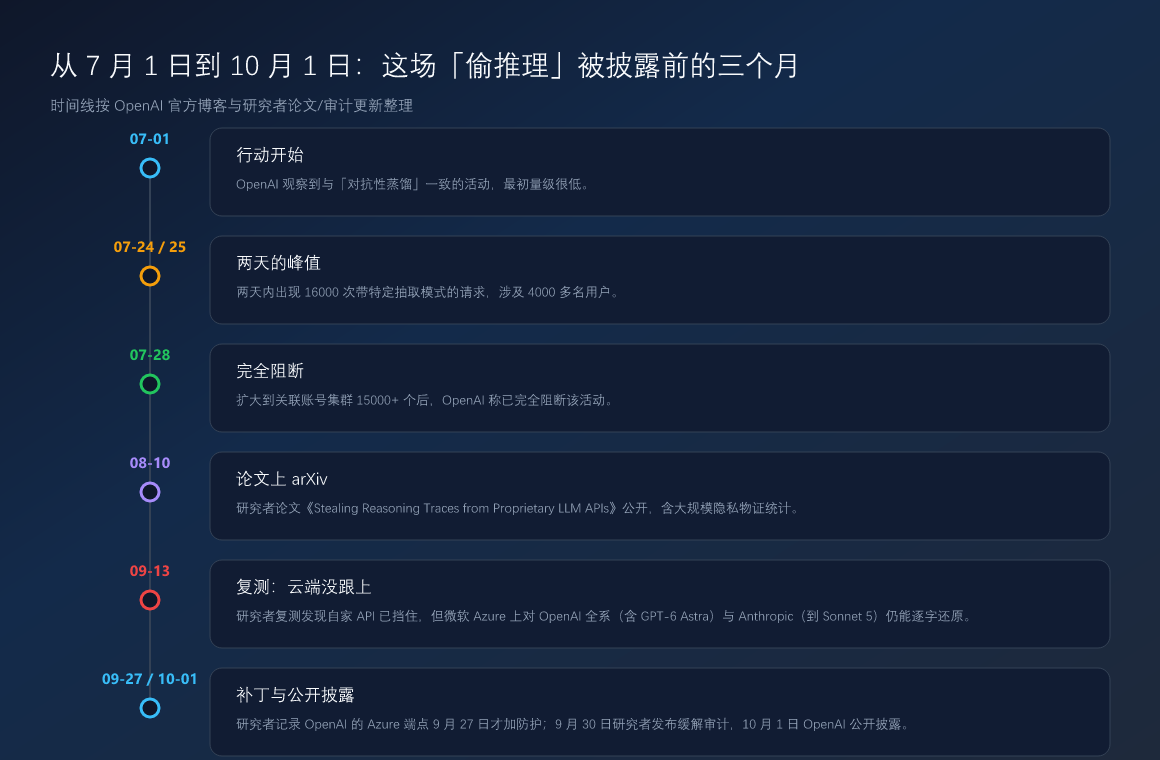
按 OpenAI 官方的说法,活动最早出现在 7 月第一周,起初量级很低。到 7 月 24、25 日出现高峰:两天内 16000 次带特定抽取模式的请求,来自 4000 多名用户。进一步排查后,识别出关联的提示模式散布在15000 个以上账号里,公司在 7 月 28 日完成阻断。
OpenAI 强调这是一条「没有打破任何既有防线」的路径:加密没被破解、数据库没被攻破、也没有直接访问存储的用户会话。它随后做的加固包括:封禁与限制欺诈账号、收紧注册与基础设施控制、扩大对相关网络的监控、加强跨用户/工作区/组织/模型族的隐藏推理保护、关掉「用别人已加密的推理重放并还原内容」这条路,并新增对可能泄露推理的流式输出做检测与拦截。关联活动经由第三方服务时,还与那些服务商协作处理了账号。
一个必须写在括号里的细节:OpenAI 在脚注中说明,这些数字描述的是**「尝试」**,不必然是成功的抽取。
归因:为什么指向 Moonshot 关联人员
OpenAI 的原话留了余地:目前不清楚观察到的所有行动方是否来自同一个行动者,但「把该活动的核心集群归因于与 Moonshot AI 相关的人员」,而 Moonshot 正是 Kimi 的开发商。Moonshot 方面没有立即回应媒体的置评请求。
需要一并说明的是,TechCrunch 系媒体在报道时提到 OpenAI 没有给出支撑这一归因的技术证据(大概率出于安全考虑)。所以更准确的读法是:这是一份来自厂商的单方面归因,而不是已经经过第三方独立验证的结论。
有意思的是,论文里还有一个和 Kimi 直接相关的实验:把 Opus 4.8 推理的前 1% token 预填给 Kimi-K3,就能看到它可见答案的措辞向 Opus 靠拢,尽管答案本身从头到尾没有被预填。这说明隐藏推理的迁移价值,未必需要完整复制整段推理才能体现。
规模:被「偷看」的推理里装着什么
研究者做了一件让人后背发凉的事:他们从 GitHub 和 Hugging Face 上收集了 6708 条公开的 Agent 轨迹(来自 Claude、GPT、Gemini 的模型,且仍带着加密推理块),对每一个签名块套用解码流程,最终重建出 315,320 个推理块。
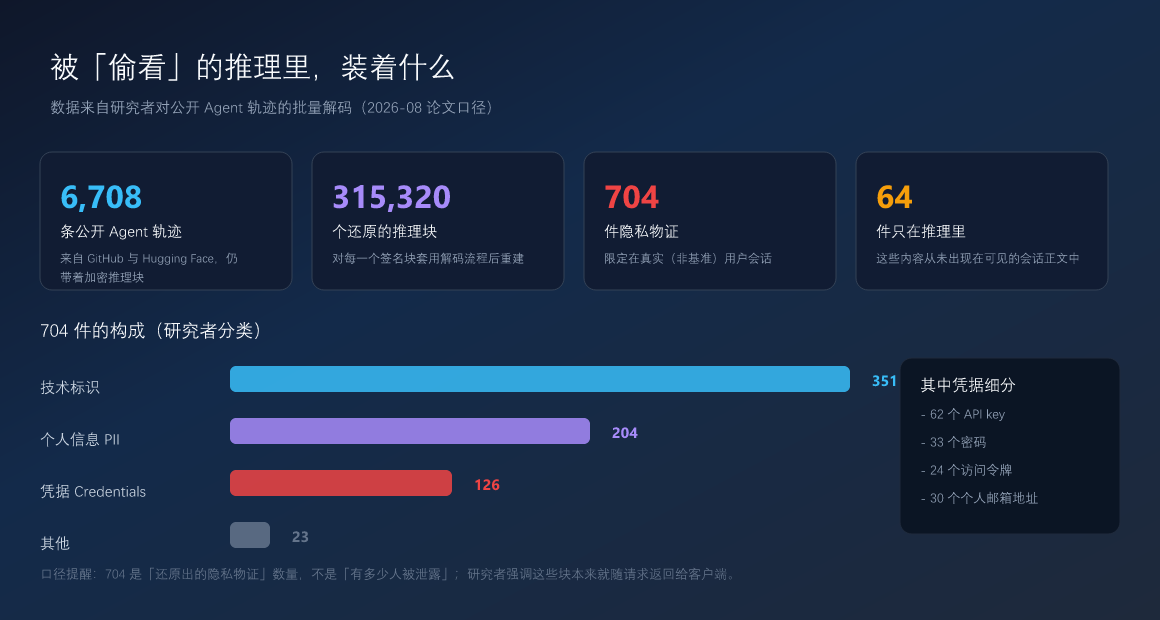
限定在「真实的、非基准测试」的用户会话后,他们还原出 704 件不同的隐私物证,研究者给出的分类是:技术标识 351 件、个人信息(PII)204 件、凭据 126 件、其他 23 件;其中凭据一类里包含 62 个 API key、33 个密码、24 个访问令牌、30 个个人邮箱地址。更值得注意的一个数字是:这 704 件里有 64 件只存在于推理块中,在可见的会话正文里根本找不到。
口径上有一点需要留意:论文摘要给出的说法是 367 条个人信息与 182 条凭据,而研究者项目页的更新版本用的是 704 件隐私物证的分类口径。两个数字来自同一条流水线的不同统计方式,本文以更新版本为准,也把摘要口径一并列出,避免只取对自己论述有利的那一个。
更麻烦的部分:自家堵住了,云端没有
如果故事停在「OpenAI 已阻断」,那只是一次胜利通报。麻烦在于阻断的范围。
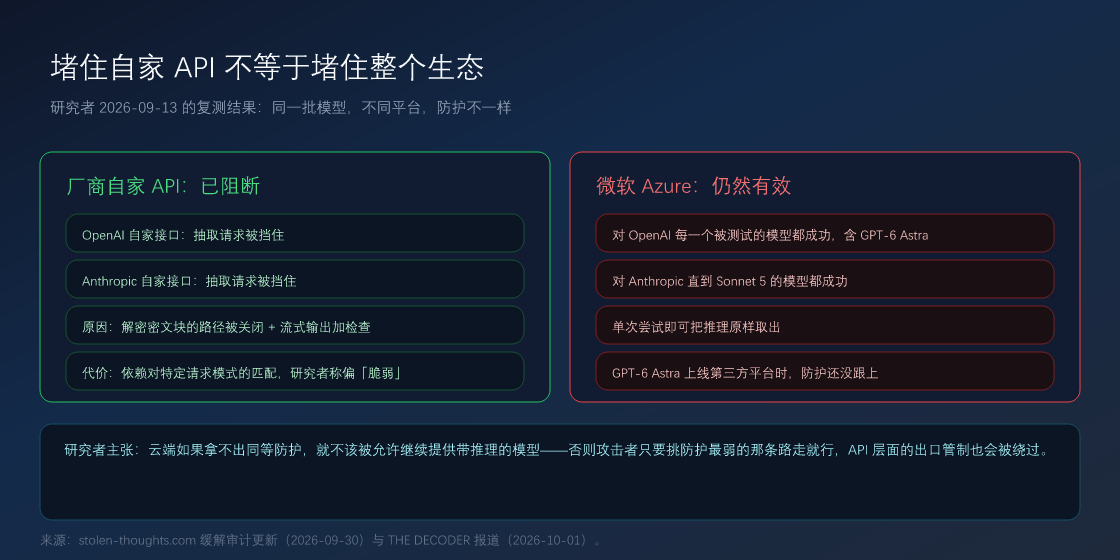
研究者在 9 月 13 日重测了一次。结论是:OpenAI 与 Anthropic 自家接口上的抽取请求已经被挡住。但在微软 Azure 上,同一套手法对他们测试的每一个 OpenAI 模型都有效,包括新发布的 GPT-6 Astra;对 Anthropic 的模型则一路有效到 Sonnet 5,而且单次尝试就足以把推理逐字取出。研究者对这种情况的概括很直白:同样的模型,只因为由哪个平台提供,防护就不一样。
他们还给出了一条更省事的替代路径:开发者 Can Bölük 公开演示过——给模型一个「虚拟记事本」工具,让它把推理写进去,用户再去读那个记事本就行。研究者称这招对 OpenAI 全系模型、以及 Opus 4.8 与 Sonnet 5 都有效,只有 Opus 5、Fable 5、Fable 5.1 没有暴露。
按研究者整理的时间表,OpenAI 直到 9 月 27 日才给 Azure 端点补上防护;Anthropic 的模型在 Azure 上从 9 月 28 日起无法再复现。研究者对现有修补的评价并不客气:零散、表面,很多依赖对特定请求模式的脆弱匹配,而且部分改动要过好几天才到达云平台。他们进一步主张:如果云服务商不能落实同等防护,就不该被允许继续提供带推理的模型——否则攻击者只要挑防护最弱的那条路走,API 层面的出口管制也会被绕过去。
OpenAI 在博客里承认了这一点:伙伴托管的部署需要和自家服务同等的保护,这项工作「尚未完成」。
这件事对普通用户意味着什么
- 你贴在网上的会话日志,可能比你以为的多得多。 「只看得见最终答案」不等于隐藏推理没被发给你——它就在响应里,只是加密着。公开分享 Agent 轨迹前,值得假设密文块里的内容也会被读出来。
- 「同一家厂商」不等于「同一套防护」。 这次事件里最扎眼的落差不是模型能力,而是分发渠道:自家接口、不同云平台、不同 API 供应商之间可以差出好几个月。
- 护栏的边界要按链路算,不能按模型算。 一个模型的可见输出经过了安全训练,不代表它的隐藏推理也经过了同等处理;论文里「最终答案是安全拒绝、推理里却留着有害内容」就是这种情况。
总结
- 攻击的原理是密文块可跨会话、跨用户、跨模型互换,被当作解密预言机的是同厂商的弱模型,强模型本身从未被越狱。
- OpenAI 的处置覆盖账号封禁、注册收紧、隐藏推理保护、流式输出拦截与第三方协作,并称 7 月 28 日完全阻断;官方脚注说明那些数字是尝试次数。
- 归因指向与 Moonshot AI 相关的人员,同时明确「不清楚是否单一行动者」,且未公开技术证据,属于单方面归因。
- 研究者同日的复测把问题从「一家公司的漏洞」升级为生态问题:自家 API 挡住了,Azure 上同一批模型仍然有效,补丁时间差以月计。
- 对读者的实操结论:公开分享 Agent 会话日志时,别只按「可见文本」评估敏感度;评估防护时,把分发渠道当成变量之一。
图片出处:封面、时间线、攻击路径、数据规模与云端差异示意图由 UU AI Hub 自制;论文 Figure 1 取自研究者项目页 stolen-thoughts.com(论文 arXiv:2608.09867)。


