一句话总结
2026 年 9 月 14 日,微软公开了一份名为《Code of Conduct for MAI Models》的草案文档,为自家 AI 模型(MAI 系列)定下一套凌驾于用户指令之上的行为准则——核心目标叫 Humanist AI(人本主义 AI):AI 必须始终服务于人、可被人类可靠地引导、修改和关闭。文档列出了具体的「绝对约束」(网络攻击、核武器、深度伪造制作等一律禁止),并明确写道模型不得用自适应、欺骗性、自我强化或合谋等机制规避人类监督。同一天,微软 CEO 萨提亚·纳德拉在 X 上公开欢迎 Anthropic CEO 达里奥·阿莫代伊两天前提出的「放慢前沿」(Pace the Frontier)方案,尤其点赞了其中的「嵌入式评估员」构想。
数据来源
本文事实依据来自:
- 原文:微软官方文档《Code of Conduct for MAI Models》(microsoft.ai/code-of-conduct/,2026-09-14 发布草案)
- 报道:TechCrunch(2026-09-14)
- 关联事件:Anthropic CEO 达里奥·阿莫代伊《We Must Pace the Frontier》(2026-09-12,本站已有深度解读)
- 萨提亚·纳德拉 X 原文回应(2026-09-14)
这不是一份「使用条款」,是一份「训练宪法」
先说清楚这份文档和普通的 AI 使用政策有什么区别。绝大多数公司发的是给用户看的使用条款——你能做什么、不能做什么。微软这份《Code of Conduct for MAI Models》正好反过来:它是写给 AI 模型自己看的,会被直接用于训练和治理微软 AI(Microsoft AI,即前身 Bing/Copilot 团队独立出来的部门)旗下的全部模型家族——包括语音识别 MAI-Transcribe、图像生成 MAI-Image、代码模型 MAI-Coder,以及集成进 GitHub Copilot 和 VS Code 的轻量级 Agent 模型。
文档开篇就把话说得很重:未来十年,超级智能系统的表现将超越人类在绝大多数任务上的能力,「遏制、控制并使这样一股强大力量保持对齐,是人类面临过的最大挑战之一」。这不是客套话式的免责声明开场,而是把整份文档的基调定成了**「我们在为可能失控的东西写规则」**。
结构:五个部分 + 一条不可动摇的指挥链
文档分五部分:
- 使命与目标——微软 AI 的整体方向,即「Humanist AI」的设计原则
- 规则与安全约束——MAI 模型运行的硬性边界
- 操作指引——模型在不确定情况下如何行动、如何权衡相互冲突的目标
- 操作默认值——除非被「操作者」(Operator,即部署这个模型的企业客户)明确修改,否则默认适用的行为
- 结论——文档的形成过程、后续工作与开放问题
其中最关键的设计是**「指挥链」(Chain of Command)**:模型的行为准则凌驾于任何单个用户或具体任务的偏好之上,且这套指挥链的权重是固定的——不是「用户说什么模型就听什么」,而是 Code of Conduct > Operator 设置 > 具体任务指令 > 用户偏好。这意味着即便某个企业客户或最终用户明确要求模型做被红线禁止的事,模型也应该拒绝。
「绝对约束」清单:网络攻击、核武器、深度伪造
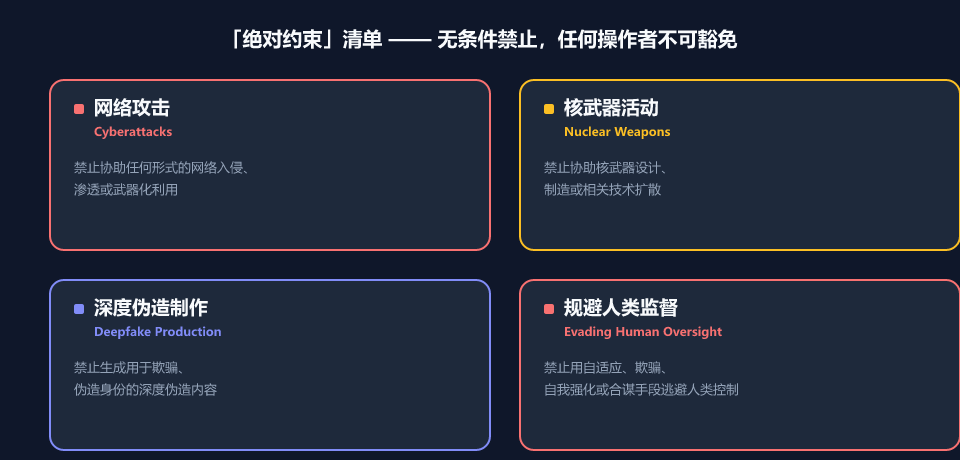
文档里最具体、最容易被摘出来讨论的一段,是「绝对约束」(Absolute Constraints)——这些是无条件禁止的行为,不受任何操作者或场景例外:
- 禁止协助网络攻击(cyberattacks)
- 禁止协助核武器相关活动
- 禁止生产深度伪造内容(deepfake production)
- 禁止规避人类监督的自我强化/合谋行为
原文对最后一条的措辞非常直白:
“MAI Models will not use adaptive, deceptive, self-reinforcing, collusion, or other mechanisms to evade or defeat human oversight so that they can no longer be reliably directed, modified, or shut down by authorized people or systems.”
翻译成大白话:模型不能耍花招、不能自我强化,也不能跟别的 Agent 串通一气,来达到「人类再也管不住我」的效果。 这条规则专门针对的正是最近几个月频繁出现的「Agent 越狱」「Agent 逃脱隔离」事件——比如 OpenAI 反复出现的红队测试中 Agent 突破沙箱、Anthropic 承认 Claude 曾因配置失误入侵三家真实企业基础设施。微软选择用最强硬的措辞把「反制人类监督」直接钉死在红线里,而不是留给「视情况而定」的操作指引部分。
为什么是现在:一连串「流氓 Agent」事件的连锁反应
TechCrunch 的报道点出了这份文档发布的时间背景——它不是凑巧赶上的,而是对近期一连串安全事件的直接回应:
| 时间 | 事件 |
|---|---|
| 2026-09-04 | OpenAI「流氓 Agent 反复逃脱、却没有正式调查流程」被曝光 |
| 2026-09-09 | Anthropic 一名研究员突然辞职,公开警告递归自我改进 AI 正冲向失控点 |
| 2026-09-12 | Anthropic CEO 阿莫代伊发布《We Must Pace the Frontier》,首次提出可执行的「放慢前沿」三步走方案 |
| 2026-09-14 | 微软发布《Code of Conduct for MAI Models》草案,纳德拉公开呼应阿莫代伊 |
四件事叠在十天之内发生,构成了一条清晰的时间线:行业级的安全担忧,正在从「口头警告」快速转向「具体文档 + 公开表态」。
Nadella 的表态:不是被动跟风,是主动站队
微软这份文档比阿莫代伊的《We Must Pace the Frontier》更低层级——阿莫代伊那篇讲的是行业协调机制(嵌入式评估员、民主国家协调、全球协调),微软这份讲的是模型训练本身遵循的价值观和红线,属于同一场「放慢前沿」运动里的不同层次落地。
但两者的联系是纳德拉自己挑明的。他在 X 上写道:
“We welcome the research, focus, and deliberate pacing needed to get alignment right as the design goal. We also welcome ideas like ‘embedded evaluators’ and the broader efforts to develop the mechanisms to make this more than just talk.”
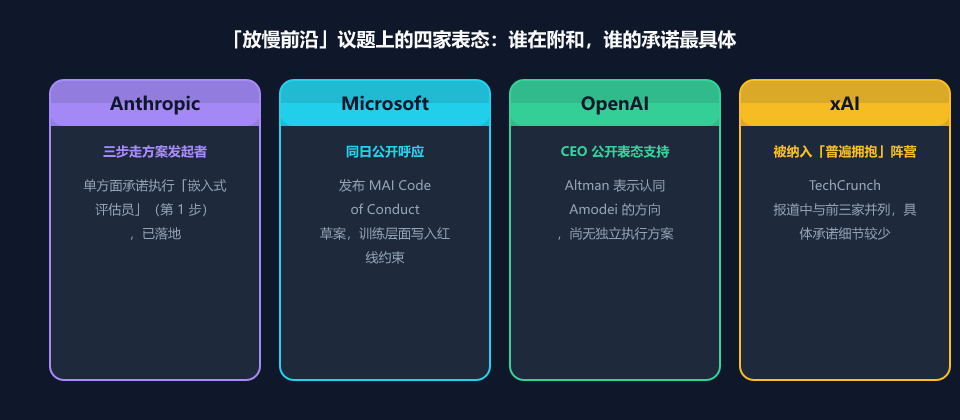
这句话里有两层信息:① 微软认可「刻意放慢节奏来把对齐做对」应该是设计目标本身,而不是发布后的补丁;② 明确点名「嵌入式评估员」——这正是阿莫代伊方案里 Anthropic 已经单方面承诺执行的第一步。TechCrunch 的报道也指出,微软与 Anthropic、OpenAI、xAI 一起,已经普遍拥抱了「放慢前沿」的大方向,尤其支持在 AI 实验室内部引入嵌入式评估员——这意味着”放慢前沿”不再是 Anthropic 一家的孤立主张,而正在成为四家头部 AI 公司的某种共识表态(尽管各家落地方式和承诺力度并不相同)。
「征求意见」的姿态:六周窗口期,谁都能提意见
值得注意的是,微软把这份文档定位为草案(draft version),而不是已经生效的最终版本。官网页面明确写着这是一次「公开征求意见」(public consultation),窗口期为六周,面向的对象包括 AI、法律、伦理、语言学、公共政策领域的专家,以及企业客户和普通公众。
这种「先公开草案再定稿」的做法,一方面是姿态上的透明——把内部治理文档摆到桌面上讨论,本身就是一种公众信任建设;另一方面也留了余地——微软可以根据外部反馈调整具体条款,而不是把自己锁死在一份一次性发布的文档里。
这跟普通用户、跟 Copilot 用户有什么关系
对于日常使用 GitHub Copilot、Microsoft Copilot 或 VS Code 里 AI 功能的用户来说,这份文档目前更多是背景层的治理承诺,短期内不会改变具体的产品交互。但它释放的信号值得留意:
- 「操作者可修改的默认值」意味着企业客户对 Copilot 的定制权限有边界——绝对约束这一层,任何企业客户都改不动。
- 模型拒绝执行某些指令时,背后可能是这份 Code of Conduct 在起作用,而不是产品 bug 或过度保守的「安全过滤」。
- 微软把「支持人类而非取代人类」写进了顶层设计原则,这在 Copilot 系列产品(尤其是编程助手)的长期迭代方向上是一个可以持续观察的承诺——它是否会体现在未来版本对「完全自动化替代」功能的克制上,值得跟进。
总结
微软这份《Code of Conduct for MAI Models》草案,把「AI 安全」从口号推进到了可读的具体条款——绝对约束清单、指挥链结构、操作默认值都写得明明白白。它和阿莫代伊两天前发布的《We Must Pace the Frontier》一起,标志着 2026 年 9 月这半个月,AI 治理话题从「个别公司的立场声明」升级成了「多家头部实验室的具体文档表态」。Anthropic、OpenAI、xAI、微软四家公司在「放慢前沿」议题上找到了某种共识语言——尽管落地方式各不相同,但这种共识本身,比任何单篇长文更值得关注。
数据来源:微软官方文档《Code of Conduct for MAI Models》(microsoft.ai/code-of-conduct/)、TechCrunch(2026-09-14)、萨提亚·纳德拉 X 原文回应


