一句话总结
10 月 15 日,Meta Superintelligence Labs 放出了 Muse Spark Open 的权重——一个 816B 总参数、每 token 只激活 42B 的稀疏混合专家(MoE)模型,1M token 上下文、原生多模态(文本/图像/音频/视频输入)。它最扎眼的一点是:官方明确演示了在两块 M5 Ultra Mac Studio 上本地跑通(经 Thunderbolt 5 + RDMA 直连)。Meta 给它贴的标签是「迄今最强的美国开源权重模型」——但请记住:「开源权重」不等于「开源软件」,它用的是 Meta 自家的 Muse Model License,商业条款有限制。
它是什么:816B 的「大」,被 42B 的「小」托住了
Muse Spark Open 是 Meta Muse 系列的全尺寸旗舰。此前 Muse 系列已经有了几个型号:8 月发的 Muse Glimmer(小型稠密模型,主打本地跑)、9 月的 Muse Spark 1.3(中端)、10 月 12 日的 Muse Wonder(付费 API 前沿模型)。Spark Open 补上了「全尺寸 + 开源权重」这一格。
关键参数:
| 指标 | 数值 |
|---|---|
| 总参数 | ~816B |
| 每 token 激活参数 | ~42B |
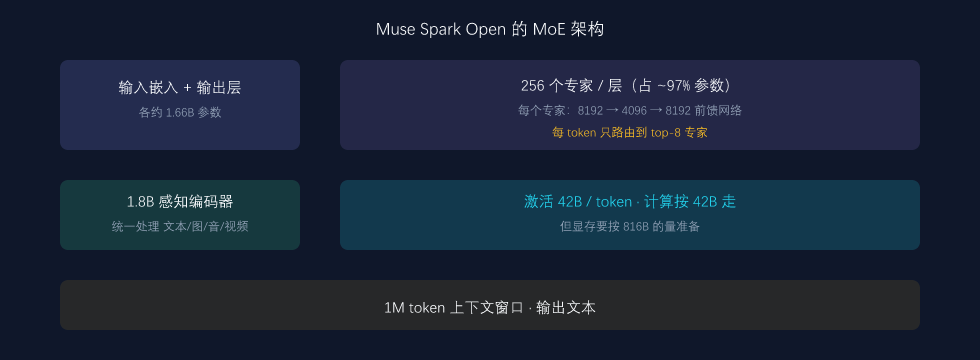
| 专家路由 | 256 专家 / 层,top-8 每 token |
| 输入 | 文本、图像、音频、视频 |
| 输出 | 文本 |
| 上下文窗口 | 最高 1M token |
| Checkpoint | BF16(~1.5TB)与 NVFP4(4-bit) |
MoE 的性价比逻辑:256 个专家里,每个 token 只路由到 8 个专家——所以显存要按 816B 的量准备,但计算速度只按 42B 的量享受。这是它「大而能跑」的根本原因。输入嵌入和输出层是两个独立的矩阵,各约 1.66B 参数;专家本身(每个是 8192→4096→8192 的前馈网络)占了总参数的大约 97%。
它还有一个 1.8B 参数的感知编码器,原生处理交错的文本、图像、视频帧和音频——不是给每种模态单独接一条管线,而是在同一次前向里统一推理「看到的、听到的、读到的」。
最亮眼的点:两块 Mac Studio 跑 816B
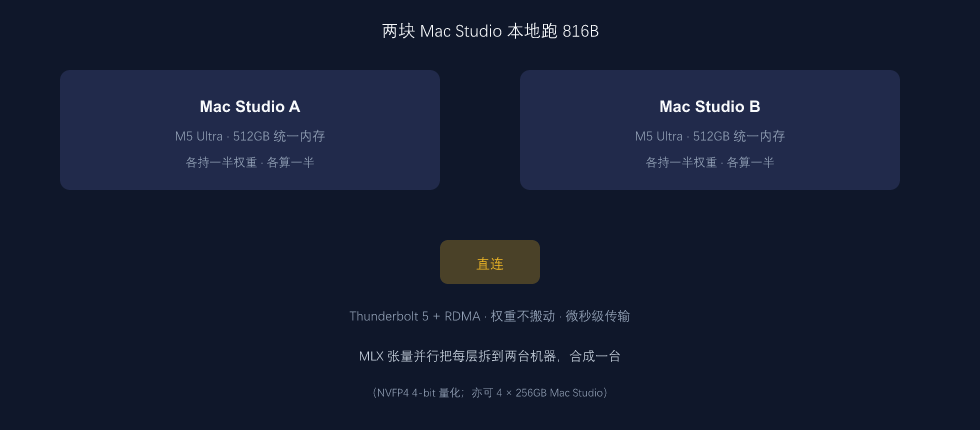
这是它区别于所有同量级模型的地方。 官方发布里,Meta 给出的本地部署方案是:
- 两块 Mac Studio,各配 M5 Ultra 和 512GB 统一内存(共 1TB 统一内存),装 NVFP4 量化版;
- 或者 四块 256GB 内存的 Mac Studio。
核心技巧是 MLX 的张量并行:把每一层拆到两台机器上,每台各持一半权重、各算一半,权重从不搬动,只有很小的中间结果在两机之间微秒级传输。配合 Thunderbolt 5 和 RDMA 的高带宽低延迟直连,两块 Mac Studio 合起来当一台机器用。
对开发者而言,这有一层很现实的意义:以前「前沿量级的开源权重模型」约等于「你得有一张或几张顶级 GPU」;现在第一次出现了一条「用桌面级 Mac 就能跑前沿开源权重」的路径。 当然,这仍不便宜——两块顶配 Mac Studio 加起来是笔不小的开支,但它把「本地跑前沿模型」从「数据中心」下拉到了「工作室」。
对 NVIDIA 平台,Meta 也提供了 NVFP4 量化 checkpoint,针对 Blackwell Ultra(GB300 NVL72)优化,配合 FP4 Tensor Core 加速,官方称在四卡上能跑到每 GPU 5 万 token/秒、每用户 600 token/秒。
定位:给「agentic coding」用的模型
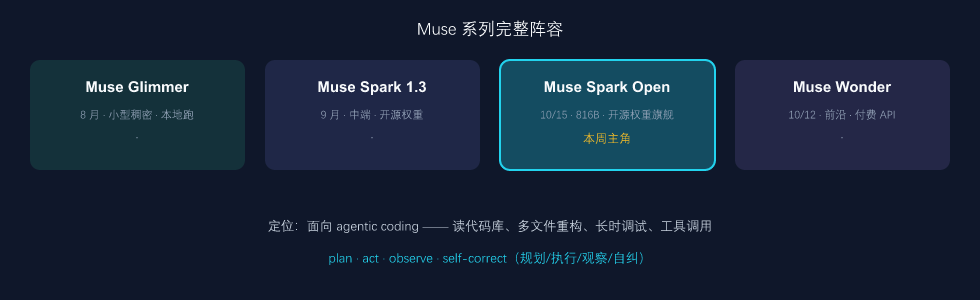
Meta 把它训练成面向 agent 编码的模型:读代码库、写代码、调试、调工具,做多文件重构和长时间调试会话。官方描述里的关键词是「plan, act, observe, and self-correct」——规划、执行、观察、自我纠正,这正是 agent 工作的闭环。
1M token 的上下文窗口,意味着整个项目(含依赖、遗留代码、上千个文件)可以一次放进上下文,不用把任务切成碎片。这和它「agentic coding」的定位是配套的:长时程任务最怕的就是「上下文装不下、被迫分段、分段之间丢状态」。
一个要泼冷水的点:Meta 称它「迄今最强的美国开源权重模型」,但官方发布里并没有附基准对比表。第三方评测机构 Artificial Analysis 给它的智能指数打了 30 分,排在美国开源权重模型里的第二。所以「最强」这个说法目前主要停留在 Meta 自己的叙事里,实际表现需要更多独立评测来验证。
最重要的一句提醒:开源权重 ≠ 开源软件
这可能是整件事里最需要被记住的一点。技术媒体 ibl.ai 的标题直接点破:「Meta’s Muse Spark Open Is Open-Weight, Not Open Source.」
Muse Spark Open 的权重确实可以下载(Hugging Face 上就有,还能在 Amazon SageMaker、Google Cloud Model Garden、Microsoft Foundry Models 上跑),但它的 Muse Model License 对商业使用有明确限制——这不是 OSI 意义上的「开源」,你下载到的是一组「权重」而不是一份「可以任意使用的软件」。
这和本周另一件事形成对照:DeepSeek 的 V4.1-Flash-1017 用的是 MIT 许可(真正宽松的开源),而 Meta 走的是「权重公开、商业受限」的路线。「开源权重」正在成为西方大厂新的竞争姿势,但它和「开源软件」之间的差别,恰恰是开发者做商业决策时最需要看清的。
为什么这件事值得关注
- 美国厂商第一次把「前沿量级」的权重公开到这个规模。 816B 开源权重,加上「桌面能跑」的演示,直接改变了「前沿模型 = 闭源 API」的默认假设。
- 「桌面本地跑前沿模型」第一次有了具体路径。 MLX + 双 Mac Studio 的方案,让「数据不出门」从口号变成了可操作的部署选项。
- 「开源权重」被重新定义成了一种策略,而不是一种意识形态。 从 Reflection 的 Beam(501B,Apache 2.0)到 Meta 的 Spark Open(816B,Muse License),西方实验室正在用不同开放程度试探市场的边界——看清楚许可条款,比看参数规模更重要。
数据来源:Meta AI Research 官方博客(Introducing Muse Spark Open,2026-10-15)、Hugging Face 博客(Welcome Muse Spark Open)、NVIDIA 技术博客(GB300 NVL72 部署)、ibl.ai(许可条款分析)。第三方评测分数引自 Artificial Analysis。


