一句话总结
华为在 HUAWEI CONNECT 2026 上把昇腾 960DT 的上市时间从 2027 年第三季度提前到 2027 年第一季度,同期发布 Peerium 计算架构,宣称能让最多 100 万颗处理器像一台计算机一样工作——路线图提速的代价,是集群规模指标出现了明显缩水。
数据来源:HUAWEI CONNECT 2026 官方新闻稿(2026-09-17,含《Huawei Pioneers a New Computing Architecture for the AI Era》与《Huawei Launches the World’s First NPO-based SuperPoD》两篇)、TechCrunch(2026-09-17)、多家外媒会后报道与分析(含中国科技分析师 Rui Ma 的公开评论)。
发布会现场:一颗芯片提前,一套架构亮相
HUAWEI CONNECT 2026 于 9 月 17 日在上海开幕。华为轮值董事长、副董事长**汪涛(David Wang)**的首场主题演讲题为《迈向智能体世界,筑牢硅基根基》,开场就给出了两组数字:
- 基础模型参数正逼近 10 万亿,预计 2030 年将超过 100 万亿;
- 仅中国每天消耗的推理 Token 已达约 500 万亿,预计 2030 年将冲到百万兆(10^18)级。
端侧也在同步膨胀:手机端的端侧模型从 2024 年的 30 亿参数,涨到今天的 300 亿,接下来要往数千亿走。华为的结论很直白——这套需求不是靠单芯片迭代能满足的,答案在「系统与架构创新」。
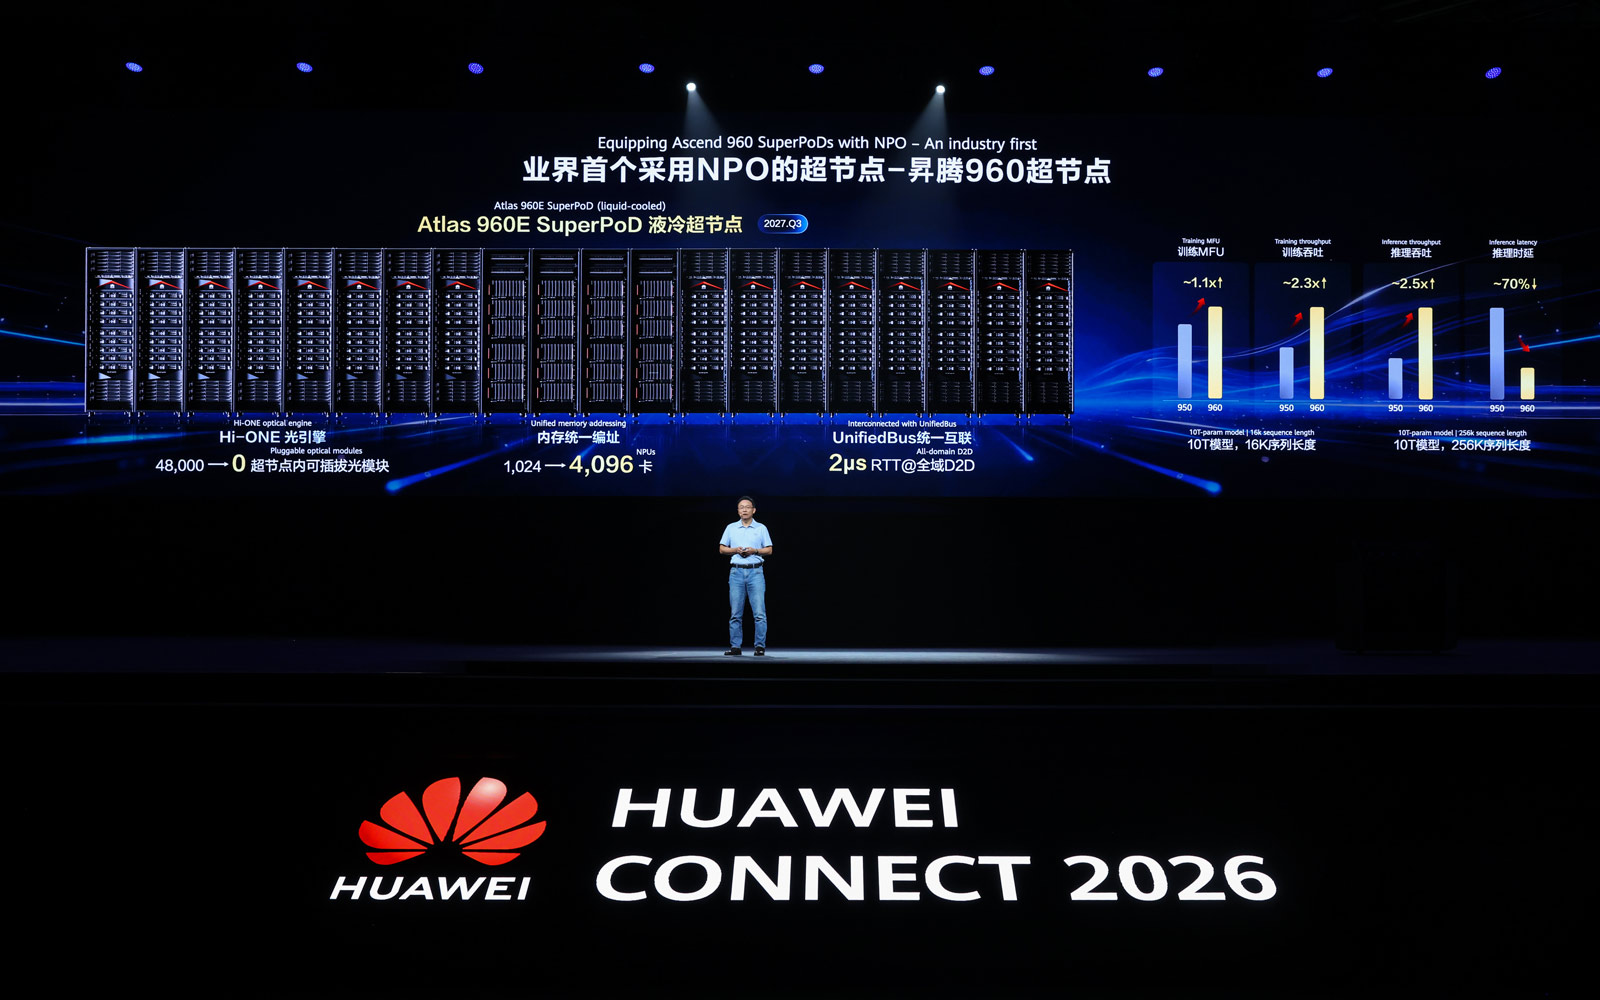
配图:HUAWEI CONNECT 2026 首日主题演讲现场,大屏为昇腾 960 超节点与 NPO 光互连的性能数据。图片为华为官方新闻稿配图(www-file.huawei.com),版权归华为所有。
昇腾的节奏变成「一年一代」
本次最受关注的消息,是昇腾 960DT 从原定的 2027 年第三季度提前到 2027 年第一季度,即提前约三个季度;面向推理场景的 昇腾 960PR 提前到 2027 年第三季度。汪涛在演讲中给出的口径是:昇腾 960 的开发超出公司预期,性能按计划翻倍。
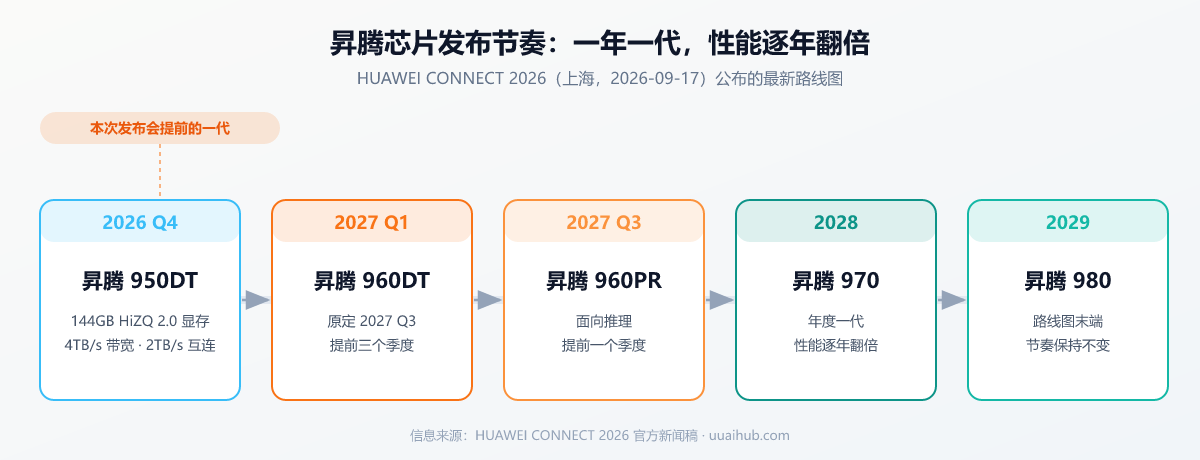
配图:昇腾芯片路线图。除 960DT/960PR 的提前信息外,950DT 的具体规格(144GB HiZQ 2.0 高带宽显存、4TB/s 显存带宽、2TB/s 互连)来自会后多家媒体的报道转述。信息整理自华为官方新闻稿与公开报道。
芯片界的常规是延期,提前反而罕见。华为把节奏改成了每年一代、性能逐年翻倍,后端排到了 2028 年的昇腾 970 和 2029 年的昇腾 980。这种「用路线图密度替代单点性能」的打法,本身就说明它清楚自己在单芯片上处于什么位置。
Peerium:把 100 万颗芯片当成一台计算机
比起芯片本身,架构才是这次发布会真正的重头戏。华为发布了 Peerium 计算架构,官方描述是通过嵌套并行(nested parallelism)、统一内存寻址与对等互连,实现「百万处理器级别的强扩展」,并称其为突破图灵范式——引入 Nested BSP(嵌套块同步并行),扩展冯·诺依曼单机架构,推翻流行数十年的主从架构。
支撑这一切的是 UnifiedBus(UB):一套基于单一开放协议的高速总线,用来连接 CPU、NPU、内存、SSD、网卡与交换芯片,规模上不设上限。基于 UB,计算、存储、网络之间实现了对等互连。
落到产品形态,规模阶梯是这样的:
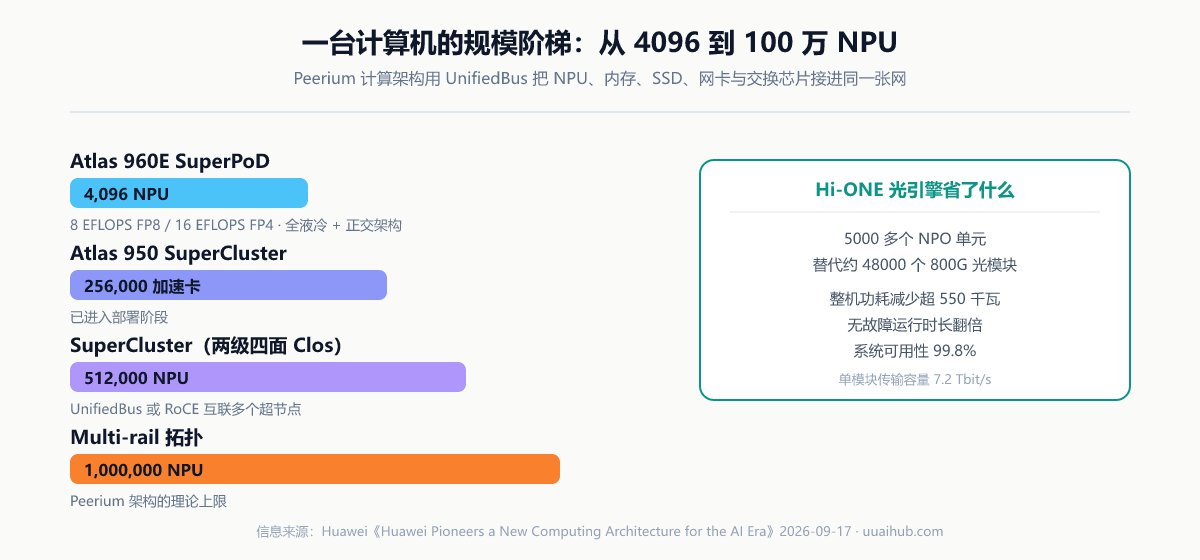
配图:从 4096 到 100 万 NPU 的规模阶梯。数据来自华为官方新闻稿《Huawei Pioneers a New Computing Architecture for the AI Era》。
- Atlas 960E SuperPoD:单超节点可扩展到 4,096 颗 NPU,FP8 精度下 8 EFLOPS、FP4 精度下 16 EFLOPS,采用正交架构与全液冷设计。
- Atlas 950 SuperCluster:可连接最多 256,000 张加速卡,官方称已进入部署阶段。
- 多超节点组成 SuperCluster:通过 UnifiedBus 或 RoCE,以两级四面 Clos 架构互联,最多可扩展到 512,000 颗 NPU;叠加 multi-rail 拓扑后,理论上限是 100 万颗 NPU。
华为同时把超节点架构搬到了通用计算:升级后的 TaiShan 950 SuperPoD 基于全光 UnifiedBus,支持最多 4,096 个节点、统一内存池最高 256TB,面向更高密度的 Agent 沙箱与更快的沙箱启动;此外还发布了 OceanStor M900 上下文记忆存储集群,提供直达一跳访问与 L3.5 层级的 PB 级 KV Cache。
真正的瓶颈是「连线」,不是单芯片
如果说 Peerium 是概念,那这次最实在的工程量产成果是光互连。华为发布了号称全球首个量产的 NPO 光引擎 Hi-ONE,传输容量 7.2 Tbit/s,并声称是业界唯一内置光源的 NPO。
它的价值体现在一组对比里:Atlas 960E SuperPoD 集成 5,500 个 Hi-ONE 单元,从而不再需要传统方案中约 48,000 个 800G 光模块。结果是整机功耗减少超过 550 千瓦,无故障运行时长翻倍,系统可用性达到 99.8%。
配图:华为在 HUAWEI CONNECT 2026 上展示的全光互联相关方案。图片为华为官方新闻稿配图(www-file.huawei.com),版权归华为所有。
这个方向的逻辑很清楚:当集群规模上到十万、百万量级,芯片之间的通信开销会迅速压过单芯片算力本身。华为把筹码押在光互连与总线协议上,用系统工程绕开单点制程的限制。
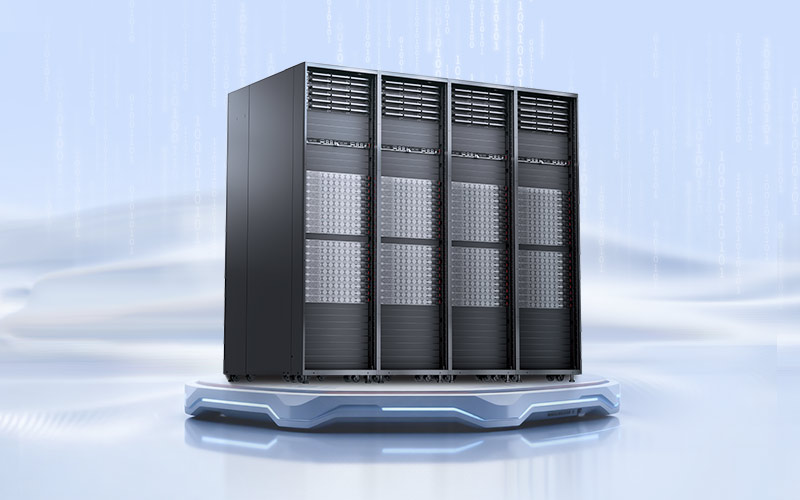
配图:华为超节点系统的官方产品示意图。图片来自华为官方新闻稿(www-file.huawei.com),版权归华为所有。
光鲜之外的三个问号
发布会的信息量很大,但把它拆开看,至少有三处需要打上问号。
第一,集群规模指标出现了缩水。 中国科技分析师 Rui Ma 在 X 上指出:华为此前表示 Atlas 960 SuperPoD 将扩展到 15,488 颗昇腾 960 芯片,而本周公布的口径是 4,096 颗。芯片本身来得远早于预期,但官方宣布的超节点反而比最初规划的规模小得多。这不必然是退步(可能是产品分档不同),但两组数字之间的落差官方没有解释。
第二,产能跟不上需求,短期内也没打算大举出海。 另一位轮值董事长徐直军在会上直言,昇腾芯片的需求已超出公司的供应能力。徐直军的一句话被多家媒体引用:「我们无法接受,自己的命运由别人是否愿意向中国出售芯片来决定。」 但与此同时,华为明确表示当前没有大规模的海外销售计划,优先保障国内客户。据媒体报道,供应紧张已经传导到价格上——昇腾 950DT 对客户报价上调了约 60%。
第三,百万颗的量级仍属于「未证实」。 官方口径是「最多 100 万颗 NPU」,但公开渠道没有任何独立基准数据能验证这个量级的实际表现。更关键的是单芯片差距:据媒体报道,DeepSeek 创始人在 7 月曾向投资人表示,上一代昇腾相较英伟达大约落后「四倍、两年」。摩根士丹利分析师 Charlie Chan 的表述更克制也更能说明问题——「系统级竞争力比以往任何时候都更重要」,有效的差距正在通过多芯粒设计、先进封装、机架级系统架构、光网络与软硬件协同优化收窄。这句话的重点是「通过什么收窄」,而不是「已经追平」。
中美两套算力栈,正在各自成体系
值得放进背景里的还有时间点:发布会一周后,美国总统特朗普与中国国家主席习近平计划于 9 月 24 日在华盛顿会面。有分析人士对媒体表示,这个提前的量产节奏在这个节点公布,体现了「北京在技术与创新上的信心」。
与此同时,生态侧的进展是实打实的。华为在演讲中给出:鲲鹏生态已聚集 416 万开发者;CANN 已完成开源并转入社区驱动的持续开发;昇腾已覆盖 90 多个领先第三方开源项目,并被正式支持为 PyTorch 的加速器后端。落地规模上,官方称累计部署超过 1,000 个 Atlas 900 A3 SuperPoD,Atlas 950 SuperPoD 已进入规模化商用。
这些数字说明同一件事:国内已经形成了一套从芯片、互连、存储、编译器到框架适配的完整栈。对国产模型来说,这意味着训练与推理可以越来越多地跑在一条自有节奏的硬件路线上——一年一代的节奏,比等待外部供应许可更可控。
对国内 AI 工具用户意味着什么
这场发布会离日常使用只有一层的距离:
- 推理成本是直接受益项。 全光互连与超节点规模扩大,压的是数据中心侧的功耗与互联成本,最终会体现在 API 单价上。国内几家主力模型的价格战已经打了很久,算力底座的国产化会继续为它提供空间。
- 服务稳定性取决于算力供给。 徐直军「需求超出供应」的表述,反过来也解释了高峰期某些国产模型服务出现限流、排队的原因——短期看,这是能力与需求的错配而非能力不足。
- 不要用单芯片参数做判断。 华为这套打法的逻辑是「系统级竞争」,评价它应该看集群级的实际训练与推理表现,而不是拿单卡规格与英伟达逐项对比。同样的道理适用于选择模型:跑得起来、成本能接受、效果够用,比参数表好看重要得多。
总结
- 昇腾 960DT 从 2027 Q3 提前到 2027 Q1,960PR 提前到 2027 Q3,昇腾节奏转为「一年一代、逐年翻倍」,后端排到 2029 年的 980。
- Peerium 计算架构以 UnifiedBus 为核心,通过嵌套并行、统一内存寻址与对等互连,把规模阶梯从单超节点的 4,096 NPU 一级级推到理论上限 100 万 NPU。
- 最实在的工程成果是量产 NPO 光引擎 Hi-ONE:5,500 个单元替代约 48,000 个 800G 光模块,整机省电超 550 千瓦,系统可用性 99.8%。
- 三个问号仍在:超节点规模从规划的 15,488 颗降到公布时的 4,096 颗、产能不足且暂不大举出海、百万颗量级缺乏独立验证。
- 生态侧 CANN 开源、昇腾成为 PyTorch 官方加速后端、鲲鹏 416 万开发者——中美各自成体系的算力栈,已经是个正在发生的事实。
图片来源:① 主题演讲现场图、全光互联方案图与超节点产品图均来自华为官方新闻稿(www-file.huawei.com,HUAWEI CONNECT 2026 相关页面),版权归华为技术有限公司所有;② 昇腾路线图与 Peerium 规模阶梯图为本文依据官方新闻稿数据自行绘制的示意图。所有图片已下载至本地存储,特此注明出处。


