一句话总结
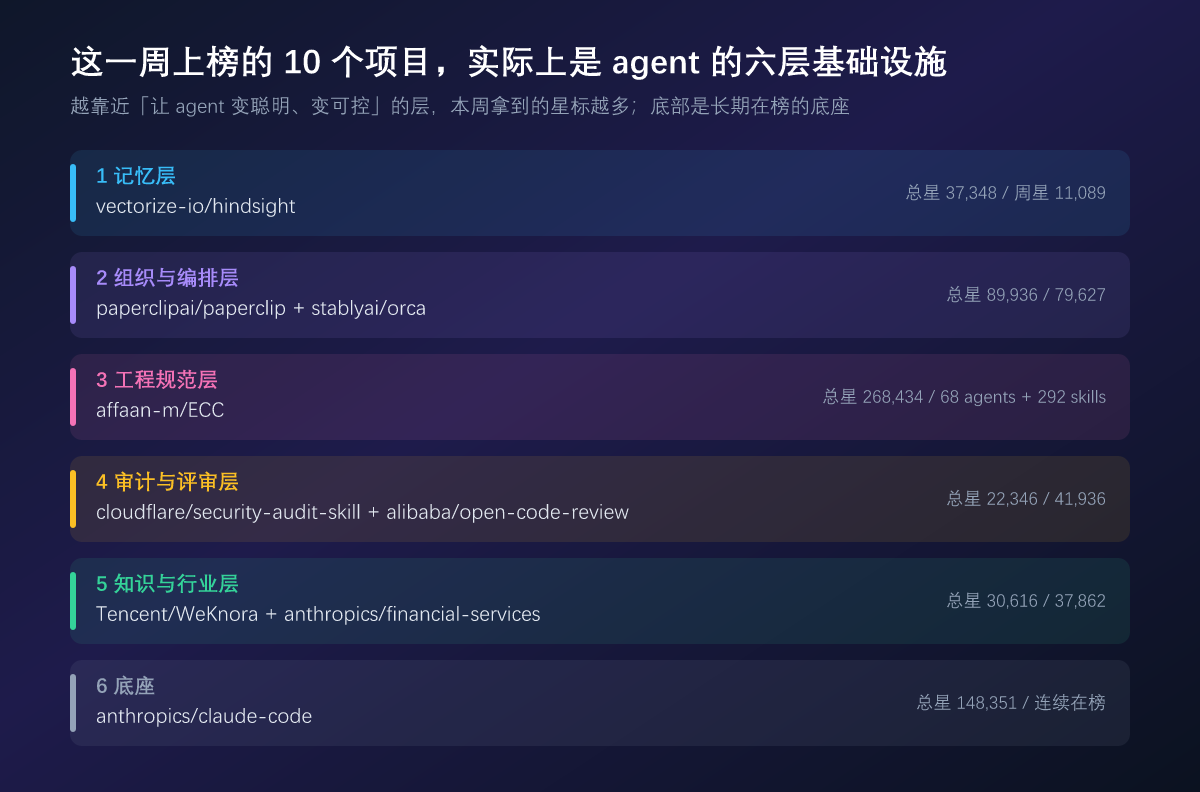
上周(w40)的关键词是 Jev 生态繁殖——一周长出 2,982 个同名新仓库。本周(w41)榜单换了主角:没有人再发布新的聊天界面,也没有人再卷「我的 agent 更聪明」。TOP 10 里 7 个项目做的是 agent 的基础设施——记忆、组织、编排、审计、评审。榜首
vectorize-io/hindsight七天拿到 11,089 周星,它解决的是「agent 记不住、学不会」;第 2、3 名的paperclip和orca解决的是「一堆 agent 你管不过来」。这一周,开源社区在给 agent 修下水道,不是在给 agent 做脸。
数据来源
本文数据来自 github.com/trending?since=weekly(本周页面可正常访问,因此回归「一周新增星标」口径),抓取时间 2026-09-28 09:15(北京时间);仓库总星标、语言、许可证、创建时间取自 GitHub REST API 实时值。
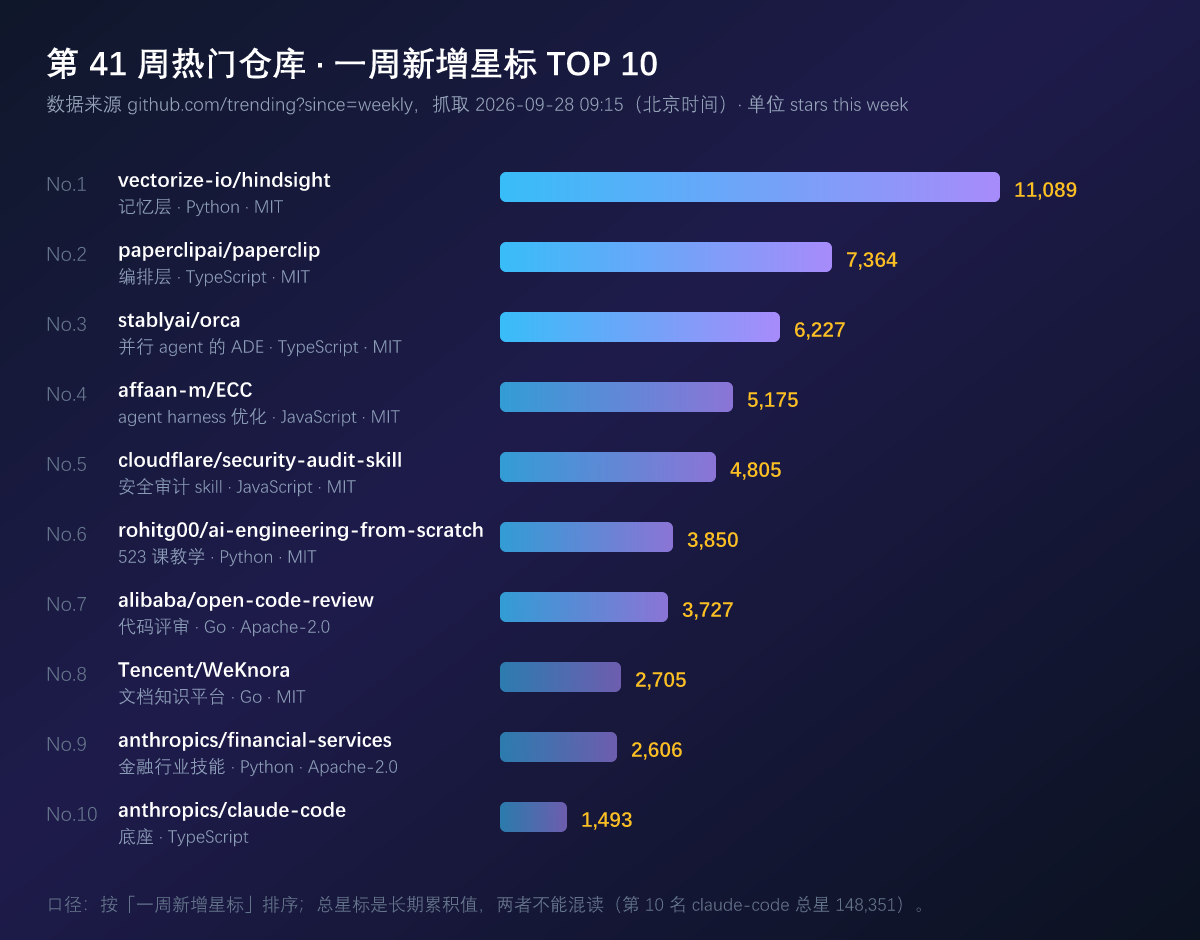
⚠️ 注意两个口径不能混读:「一周新增星标」(本文排序依据)和「总星标」(长期累积)是两个完全不同的量,第 10 名的 claude-code 周星只有 1,493,但总星是 148,351。
No.1 vectorize-io / hindsight — 11,089 周星(总星 37,348)
Agent 记忆从「记住」升级到「学会」。 语言:Python · 协议:MIT · 创建:2025-10-30
README 里有一句定位很准的话:
大多数 agent 记忆系统专注于回忆对话历史。Hindsight 专注于让 agent 学会,而不只是记住。
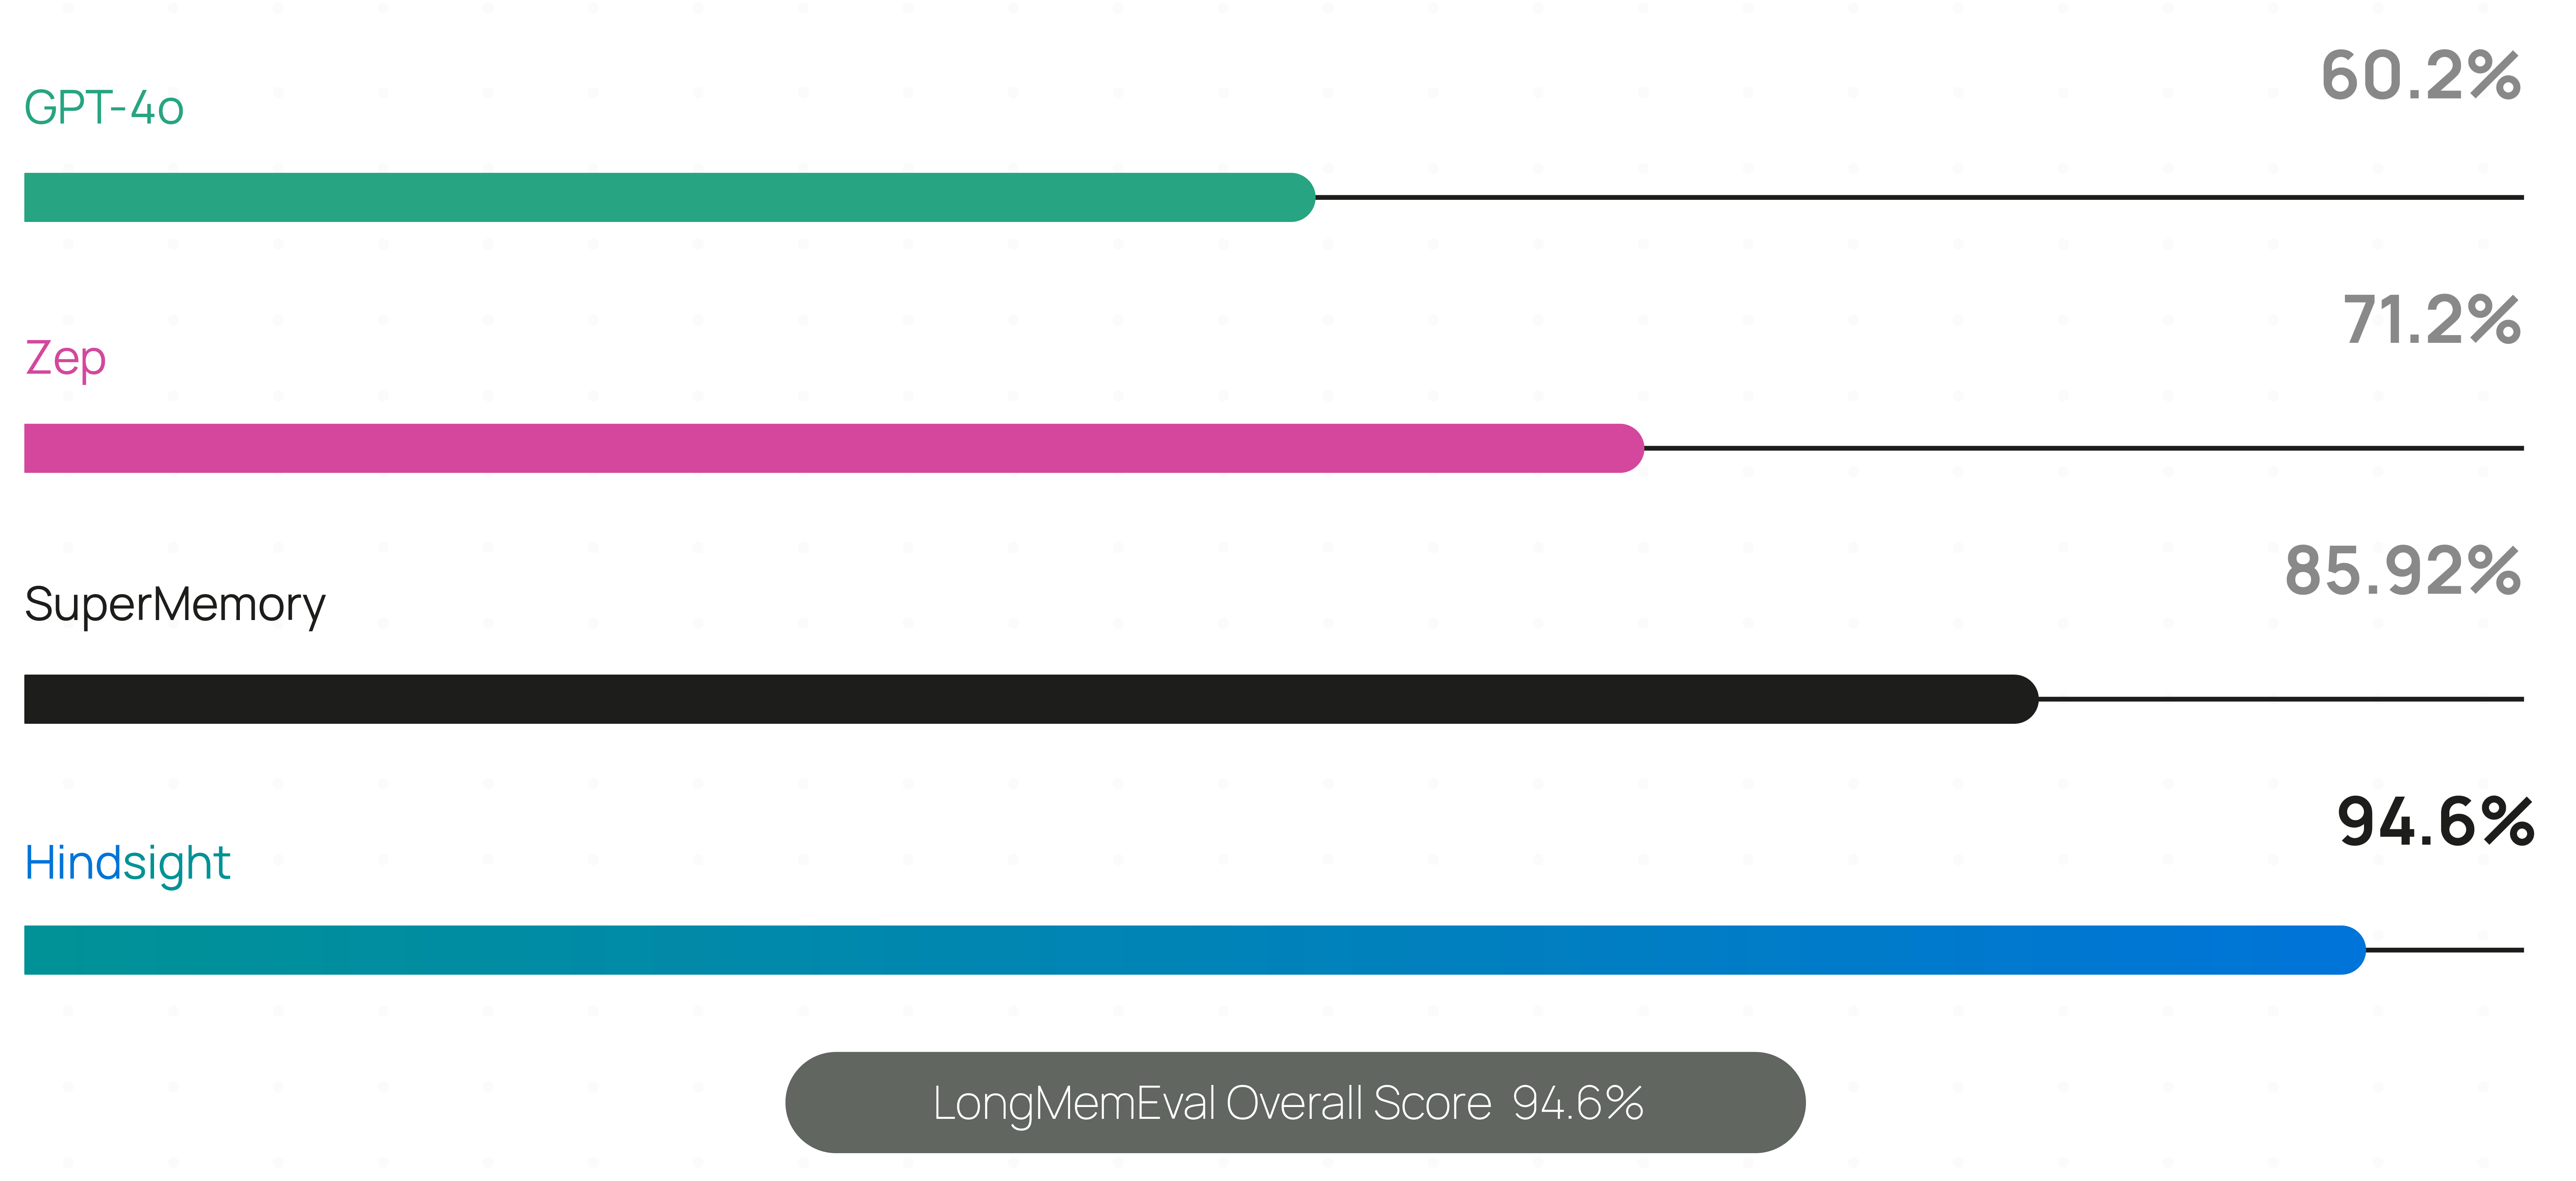
它的技术主张是绕开 RAG 与知识图谱的固有短板,在长程记忆任务上做到 SOTA:官方在 LongMemEval 基准(评估对话式 AI 记忆能力的常用基准)上的数字是 94.6% 总分,对比 GPT-4o 60.2%、Zep 71.2%、SuperMemory 85.92%——这不是小幅领先。官方强调该结果已被独立研究机构复现,并给出持续更新的榜单页(含逐模型准确率、延迟、成本)。
它的抽象层次值得记住:三种操作 retain / recall / reflect(保存 / 回忆 / 反思),在此之上有 observations(观察)、mental models 与 knowledge pages(心智模型与知识页)、banks(记忆库)。接入方式刻意做得极轻——两行代码的 LLM Wrapper、面向 coding agent 的集成、以及 MCP server。另有论文(arXiv 2512.12818)与云端版本。
为什么值得关注:过去半年 agent 的瓶颈从「模型不够聪明」快速转向「跨会话记不住、学不会」。本周榜首给这个瓶颈投了票。
仓库地址:github.com/vectorize-io/hindsight
No.2 paperclipai / paperclip — 7,364 周星(总星 89,936)
如果 OpenClaw 是员工,Paperclip 就是公司。 语言:TypeScript · 协议:MIT · 创建:2026-03-02
一句话产品定义:
一个用来管理工作中 AI agent 团队的开源应用——它看起来像任务管理器,底下是组织架构图、预算、治理、目标对齐和 agent 协调。
README 里那句 slogan 很狠:「只要能收到心跳,就能被雇用。」
它的功能被拆成四根柱子,值得作为「agent 组织」这个品类的功能清单来看:
| 柱子 | 给谁用 | 覆盖什么 |
|---|---|---|
| Agentic 任务管理器 | 所有人/日常 | 任务、审批与评审门、可审计的流程、用 diff / 截图 / 测试来验收 |
| Agent 组织架构图 | 管理者 | 人与 agent 混编、职责与授权、谁可以做什么、凭证作用域与公司边界 |
| Agent 员工培训 | 赋能者 | Skill Studio 与组织级共享技能、评测与保存的测试运行、主动学习闭环、agent 绩效评估 |
| Agentic OS | IT/平台 | 跨 provider 运行时(任意模型、任意 agent)、沙箱与 MCP、SSO/GRC/RBAC 与成本控制 |
其中**「每个 agent 有月度预算,撞到上限就停」**这条,正好对应这一周大家都在讨论的 agent 烧钱问题。
适合谁:已经开了 20 个 Claude Code 终端、开始分不清谁在干什么的团队。
仓库地址:github.com/paperclipai/paperclip
No.3 stablyai / orca — 6,227 周星(总星 79,627)
并行 agent 的 IDE:一个 prompt 撒给五个 agent,各在各的 worktree。 语言:TypeScript · 协议:MIT · 创建:2026-03-17
Orca 自称是「100x builder 的 AI Orchestrator」,核心动作是:
让 Codex、Claude Code、OpenCode、Pi 并排跑——每个在自己的 git worktree 里,统一在一处追踪。
README 里最值得抄的几个设计:
- fan-out 对比:把一个 prompt 扇出给五个 agent(各自独立 worktree),比较结果、合并胜出的那个;
- 手机接管:agent 跑完给你推送,你可以从手机上发后续指令——甚至专门发了 iOS/Android 客户端(Android APK 已到 0.0.50);
- Design Mode:在真实 Chromium 窗口里点任意 UI 元素,把它的 HTML、CSS 和裁剪后的截图直接塞进 agent 的 prompt;
- Ghostty 级终端(WebGL 渲染、无限分屏、重启后保留 scrollback),加上在线 diff 行上直接留评论回传给 agent。
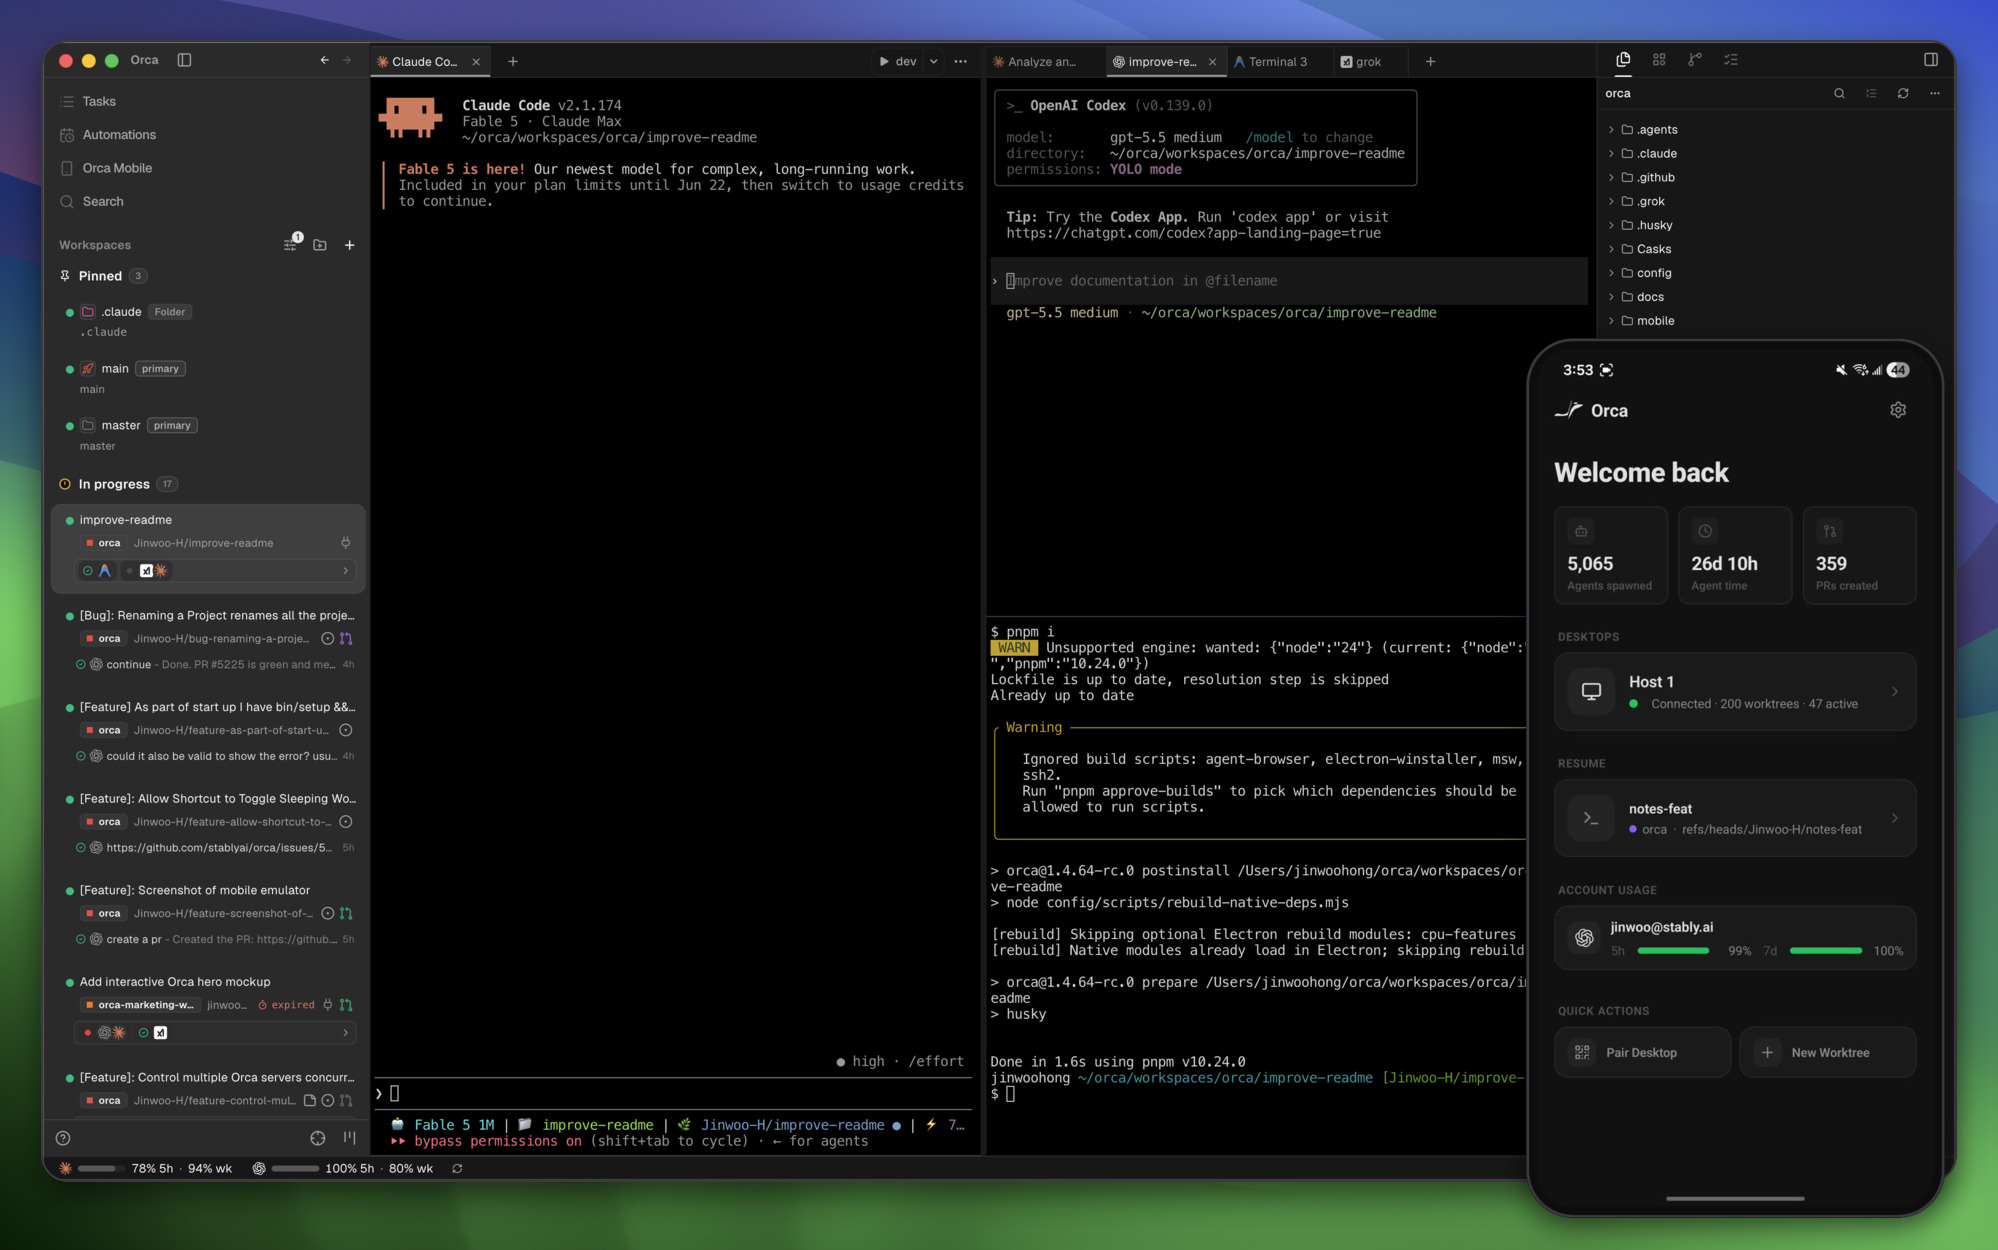
它明确表态:任何 CLI agent 都能用——只要能在终端里跑,就能在 Orca 里跑。
No.4 affaan-m / ECC — 5,175 周星(总星 268,434)
把「工程流程」装进 agent,而不是每次在 prompt 里重写一遍。 语言:JavaScript · 协议:MIT · 创建:2026-01-18
一句话说明它想解决什么:
你的 agent 会写代码,但 ECC 给它的是一套协同的工程系统与工具箱——先规划、用测试验证、用干净上下文自我评审、记住重要的事,并把重复的成功沉淀成可复用的 skill 与流程。
流程被固定成一条链:plan -> test -> implement -> review -> verify -> remember -> improve,配一句很好用的原则:
优化上下文窗口,其余全部持久化。
装配量也很可观:68 个 agent、292 个 skill、94 个命令垫片,加上 hooks、memory、持续学习,以及一个叫 AgentShield 的安全扫描(扫 prompt、hook、MCP 配置、权限、密钥、agent 文件)。商业模型值得单独说:MIT 永久开源,私有仓库走托管 GitHub App($19/座/月)——用一个 maintainer 每周跨 7 种 harness 交付,这是「开源 + 托管增值」的典型样本。主支持 Claude Code,Codex 有官方同步路径,其余(Cursor、OpenCode、Gemini、Zed、Copilot、Qwen 等)是能力受限适配器。
No.5 cloudflare / security-audit-skill — 4,805 周星(总星 22,346)
一个把 coding agent 变成安全审计员的 skill,六个阶段、可机器校验。 语言:JavaScript · 协议:MIT · 创建:2026-06-18
这个仓库的分量不在代码量,而在它的出身:
这是孵化 Cloudflare 漏洞发现 harness 的那个 skill——harness 后来长成了多阶段、覆盖全舰队(fleet-wide)的系统,而这个 skill 是它演化前的单仓库起点。
六阶段流程写进 README 了:① 侦察(把架构、信任边界、输入面、既有证据与确定性覆盖写进 architecture.md 和 coverage-ledger.json)→ ② 覆盖驱动的猎取(按 ledger 单元分配隔离的 hunter,用 coverage critic 找缺口)→ ③ 候选验证(每个候选交给全新的 verifier 去尝试证伪)→ ④ 结构化输出(confirmed / needs_validation / rejected 写进 findings.json,按 report-schema.json 校验)→ ⑤ 独立记录核验 → ⑥ 目标中立的报告。
两个工程判断值得学:候选必须由「试图推翻它的新 verifier」复核;发现必须符合 schema,机器可读。
仓库地址:github.com/cloudflare/security-audit-skill
No.6 rohitg00 / ai-engineering-from-scratch — 3,850 周星(总星 59,310)
523 节课、20 个阶段、约 342 小时:把 AI 工程课写成能动手的物。 语言:Python · 协议:MIT · 创建:2026-03-18
README 开头引用的两个数字解释了它为什么火:
84% 的学生已经在用 AI 工具,但只有 18% 觉得自己能专业地使用它们。 这套课程就是来填这条沟的。
规模:523 节课 / 20 个阶段 / 约 342 小时,覆盖 Python、TypeScript、Rust、Julia;每一节课都交付一个可复用的产物——一个 prompt、一个 skill、一个 agent、或一个 MCP server。作者是 rohitg00/agentmemory(#1 persistent memory)的作者。近期数据(README 自报,截至 2026-08-29):114,584 名读者、近 30 天 181,995 次页面浏览。
仓库地址:github.com/rohitg00/ai-engineering-from-scratch
No.7 alibaba / open-code-review — 3,727 周星(总星 41,936)
阿里把内部跑了两年的 AI 代码评审工具开源了。 语言:Go · 协议:Apache-2.0 · 创建:2026-05-18
README 里的出身说明是它的可信度来源:
它源自阿里巴巴集团内部的官方 AI 代码评审助手——两年间服务了数万名开发者、发现数百万个代码缺陷。经过大规模验证后,孵化成了开源项目。
运行方式极简:配好模型 endpoint 就能用。它读 git diff,把变更文件交给带工具调用能力的 agent(可以读完整文件、搜索代码库、查看其他变更文件),产出行级精确的结构化评审意见;另有 ocr scan 对整文件评审,用于审计陌生代码库。
亮点数据(仓库 README):
- 20K+ 内部活跃用户、3M+ 真实任务、npm 近 30 天下载 329K+;
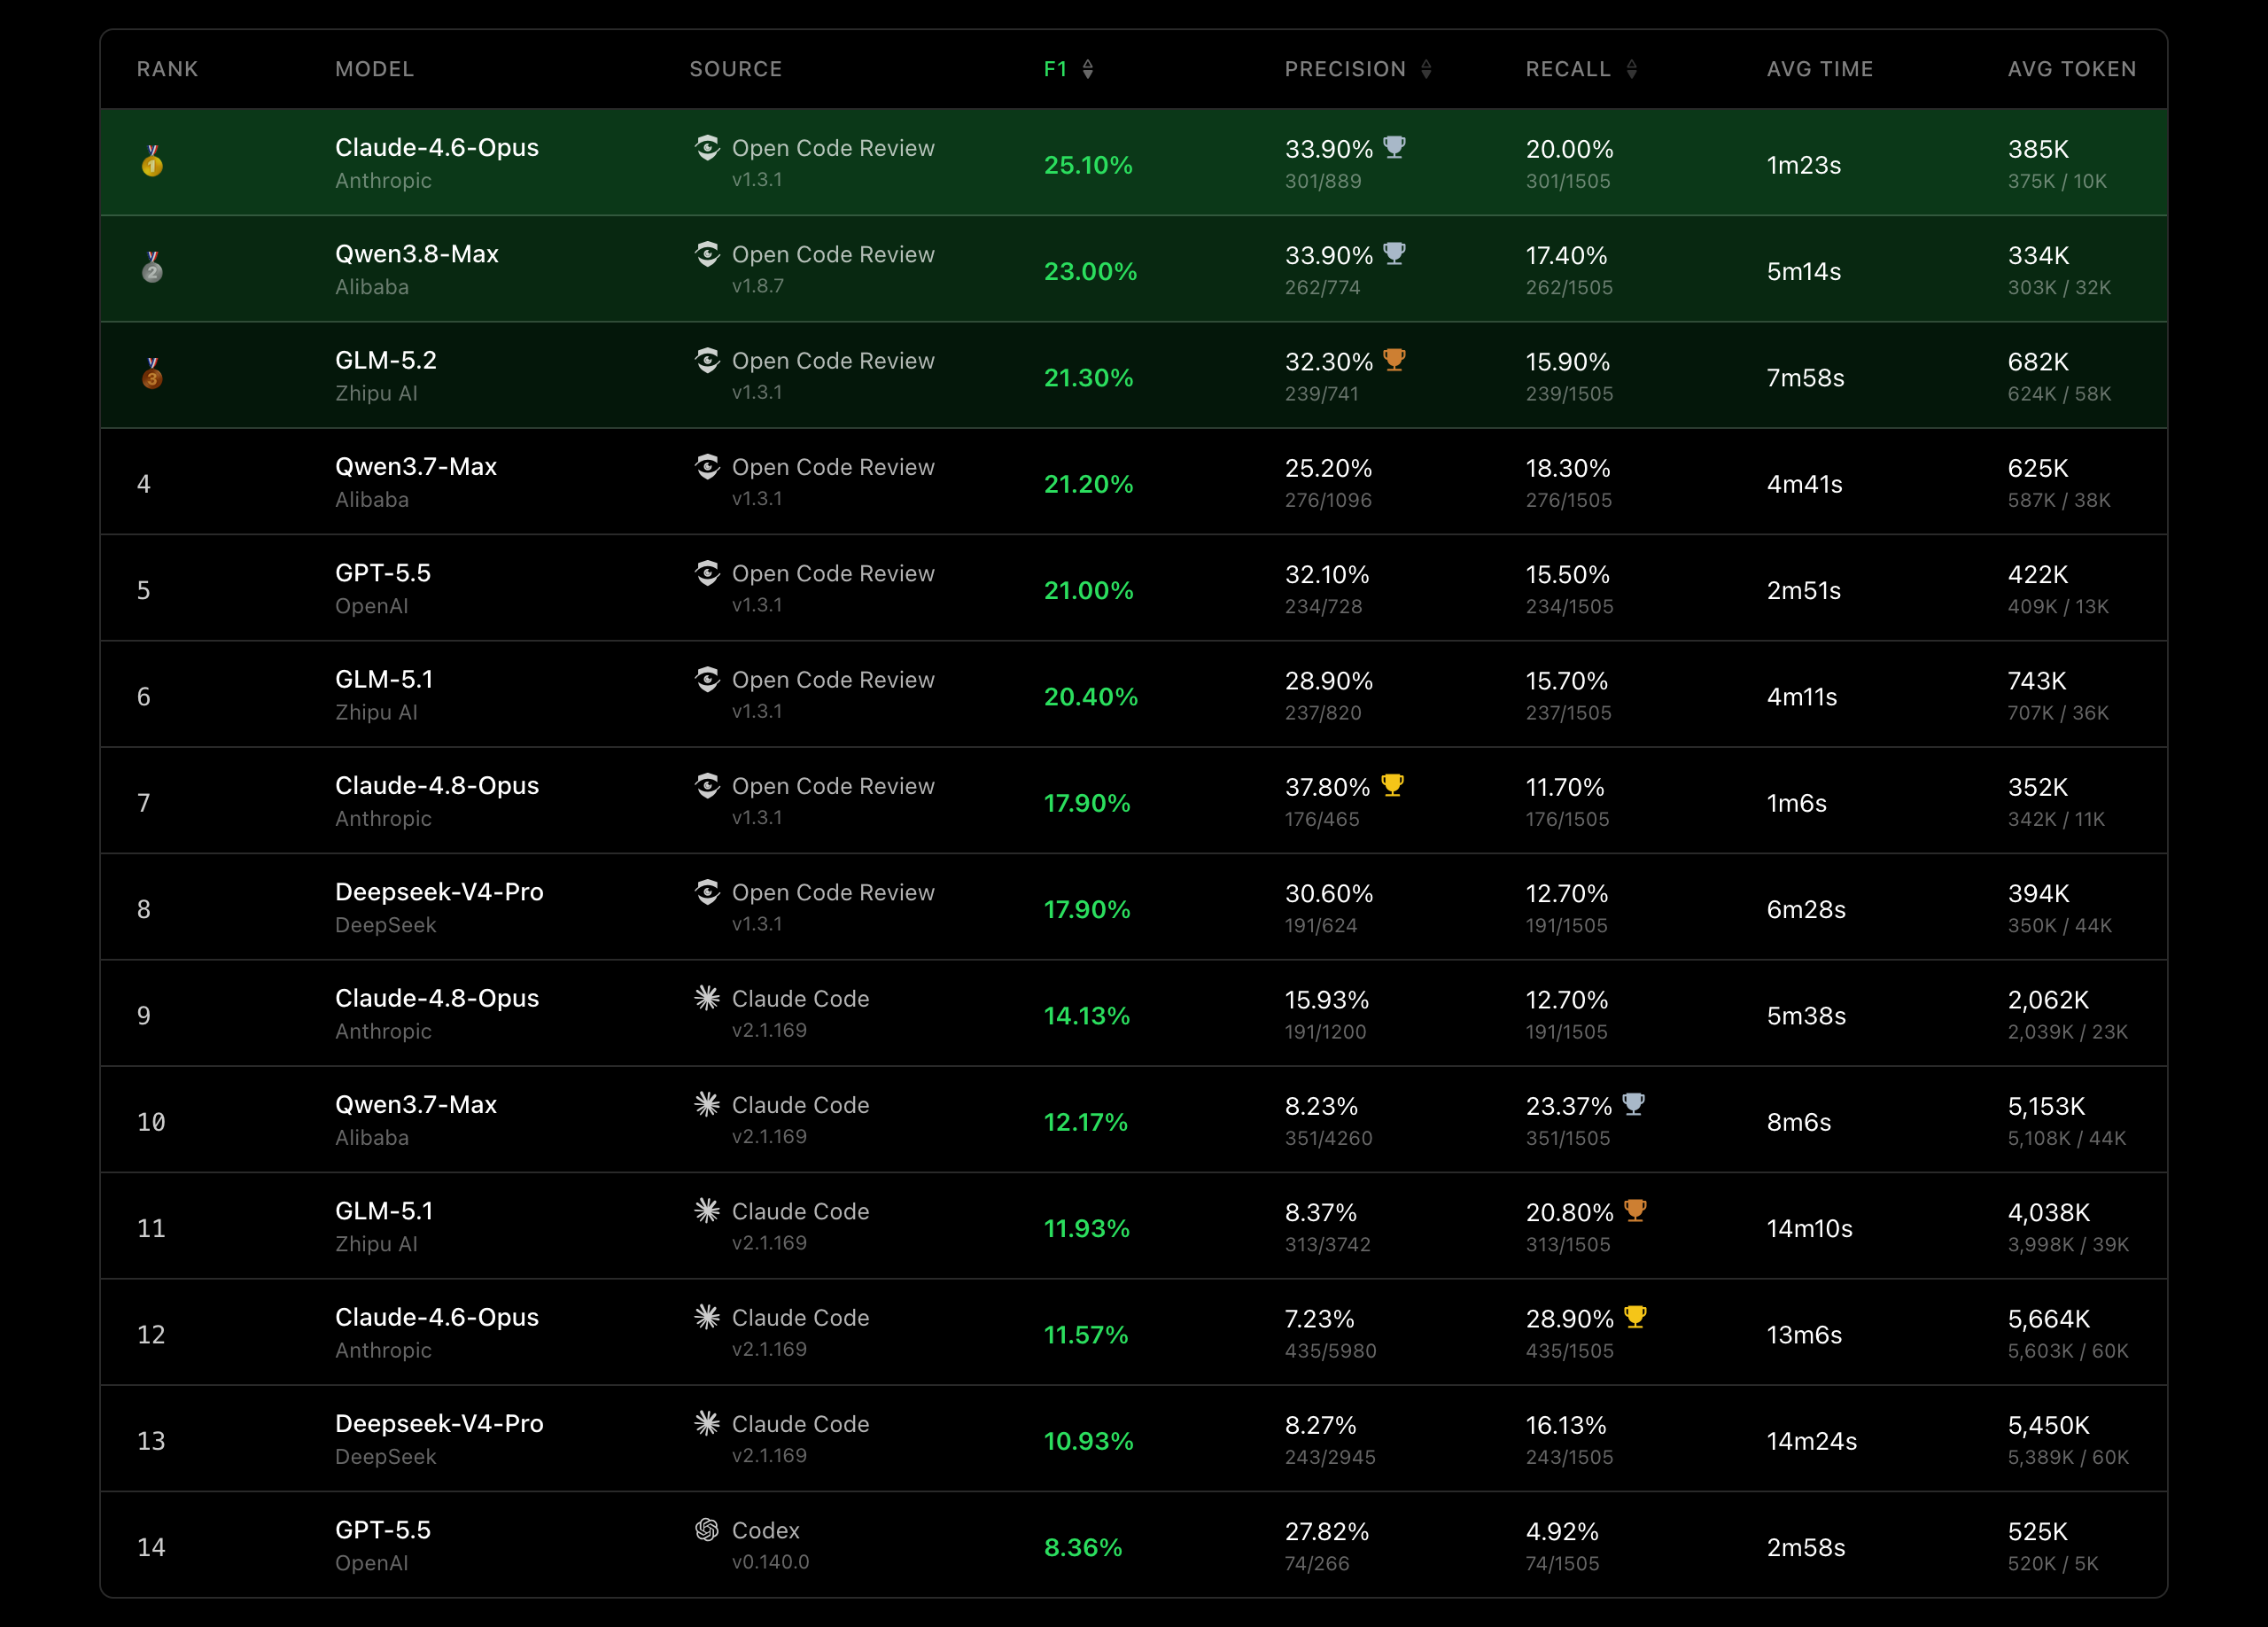
- 同一底层模型下,相比通用 agent(Claude Code)precision 与 F1 显著更高,token 只花约 1/9——但recall 更低,作者承认这是「用召回换精度」的刻意取舍。
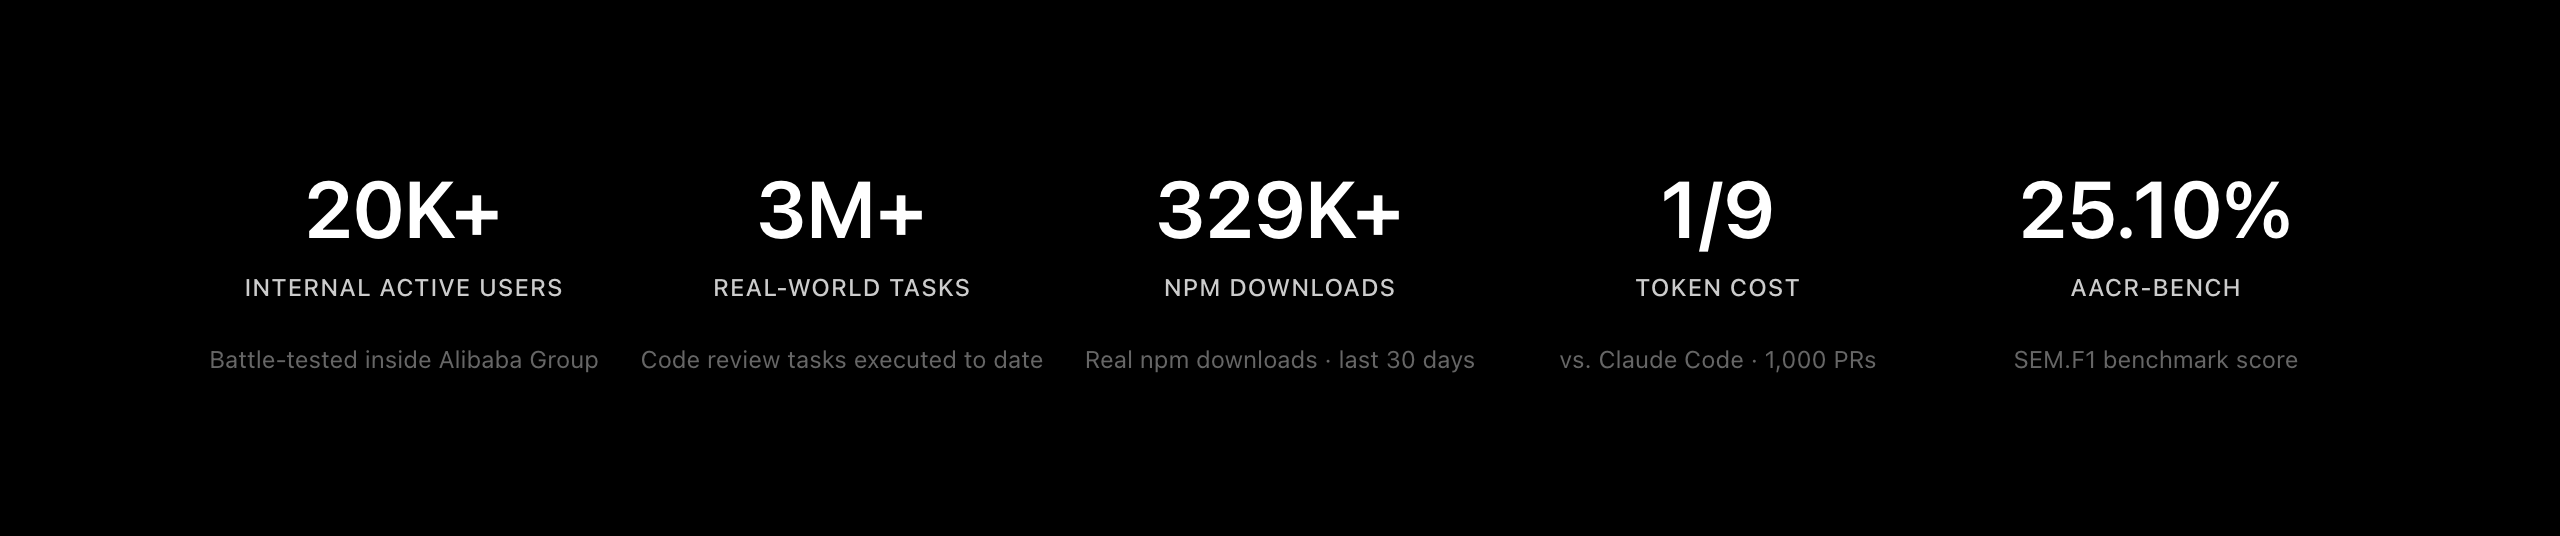
它的 Benchmark 也很实:AACR-Bench 由 50 个热门开源仓库、200 个真实 PR、10 种编程语言构成,80+ 位资深工程师交叉标注出 1,505 条 ground-truth 问题。榜首是 Open Code Review v1.3.1 驱动的 Claude-4.6-Opus,SEM.F1 25.10%(precision 33.90% / recall 20.00%,平均 1m23s、385K token);同一模型换成 Claude Code v2.1.169 驱动,F1 掉到 14.13%、平均 token 涨到 2,062K。
它对通用 agent 的三个批评也很直接:覆盖不全(大改动会偷懒只审部分文件)、位置漂移(报的问题对不上真实代码位置)、质量不稳(纯自然语言驱动的 skill 难调试)。解法是「确定性工程 × agent 混合」。
仓库地址:github.com/alibaba/open-code-review
No.8 Tencent / WeKnora — 2,705 周星(总星 30,616)
企业文档 → 可推理的知识底座。 语言:Go · 协议:MIT · 创建:2025-07-22 · 当前版本 v0.8.2
定位是「LLM 驱动的知识框架」,做企业文档理解、语义检索与推理,把团队文档聚在一起以便检索、推理并保持更新。三件套分工清楚:用 RAG 查东西、用 agent 做多步任务、用 wiki 组织知识——三者共用同一批知识库。
工程覆盖度是它的卖点:agent 的工具跑在会话持久的 Docker / E2B / Cube 沙箱里(带交互式终端和图形桌面),BrowserSkill 可以操作你自己的 Chrome/Edge,外部 MCP 服务(含 OAuth)可逐个工具启用;数据源支持飞书知识库 / 飞书云盘 / Confluence / GitLab / 腾讯 IMA / Notion / 语雀 / 钉钉文档 / RSS 自动同步,10+ 种文档格式;模型侧内置 27 家厂商目录(含 OpenAI、DeepSeek、Qwen、智谱、混元)。
仓库地址:github.com/Tencent/WeKnora
No.9 anthropics / financial-services — 2,606 周星(总星 37,862)
Anthropic 官方把投行、行研、PE、财富管理的 agent 工具箱开源了。 语言:Python · 协议:Apache-2.0 · 创建:2026-02-23
README 的用法说明是本周最值得注意的产品设计之一:
这里的一切从同一份源出发有两种交付方式——装成 Claude Cowork 插件,或者通过 Claude Managed Agents API 部署在你自己(或客户)的工作流引擎后面。同一套系统提示词、同一批 skill,你自己选在哪跑。
内容是「我们看到得最多的金融工作流」的参考实现:命名的端到端 agent(Pitch Agent、Market Researcher、GL Reconciler 等),每个都同时提供 Cowork 插件与可通过 /v1/agents 部署的 managed agent 模板;再往下一层是按垂直行业打包的 skills、slash 命令与数据连接器(只要 /comps、/dcf、/earnings 就装这层)。
合规边界写得非常明确(这是它比多数「AI + 金融」项目更专业的地方):这些 agent 生成的是分析工作产物(模型、备忘录、研究笔记、对账表),供合格专业人士复核;它们不做投资建议、不执行交易、不承担风险、不记账、不批准开户,每个输出都要人工签字。
仓库地址:github.com/anthropics/financial-services
No.10 anthropics / claude-code — 1,493 周星(总星 148,351)
底座继续在榜。 语言:TypeScript · 创建:2025-02-22
它不是新项目,但本周仍然拿到 1,493 个新增星标——放在一张「新项目榜」里看,这恰恰说明本周的榜单结构在变:前三名的周星是它的 4-7 倍,但它们全都运行在它(或它的同类)之上。 上一周的 claude-code-templates(本周 1,154 周星)也还在榜上,那条「围绕单一 harness 长出生态」的线索没有断。
仓库地址:github.com/anthropics/claude-code
本周趋势总结
| 排名 | 仓库 | 周星 | 总星 | 语言 | 它在哪一层 |
|---|---|---|---|---|---|
| 1 | vectorize-io/hindsight | 11,089 | 37,348 | Python | 记忆层 |
| 2 | paperclipai/paperclip | 7,364 | 89,936 | TypeScript | 组织与编排层 |
| 3 | stablyai/orca | 6,227 | 79,627 | TypeScript | 组织与编排层 |
| 4 | affaan-m/ECC | 5,175 | 268,434 | JavaScript | 工程规范层 |
| 5 | cloudflare/security-audit-skill | 4,805 | 22,346 | JavaScript | 审计层 |
| 6 | rohitg00/ai-engineering-from-scratch | 3,850 | 59,310 | Python | 教学 |
| 7 | alibaba/open-code-review | 3,727 | 41,936 | Go | 评审层 |
| 8 | Tencent/WeKnora | 2,705 | 30,616 | Go | 知识与行业层 |
| 9 | anthropics/financial-services | 2,606 | 37,862 | Python | 知识与行业层 |
| 10 | anthropics/claude-code | 1,493 | 148,351 | TypeScript | 底座 |
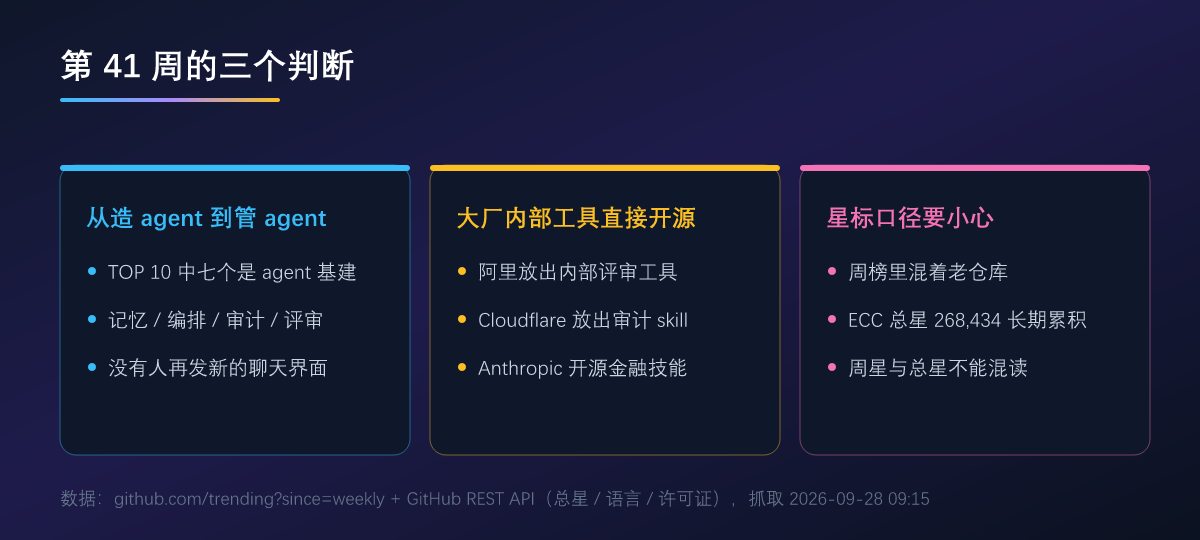
观察一:热点从「造 agent」转向「管 agent」
TOP 10 里七个是 agent 基础设施——记忆(hindsight)、组织(paperclip)、并行编排(orca)、工程规范(ECC)、安全审计(cloudflare)、代码评审(阿里)、知识底座(WeKnora)。上周榜单还在卷「让 agent 更强」,本周卷的是「agent 多了以后怎么办」:会忘就补记忆,会乱设组织,会烧钱就设预算,会写坏代码就上审计与评审。没有一个新的聊天界面。
观察二:大厂「内部工具开源」成了新的上榜路径
阿里(两年内部使用、数万开发者、数百万缺陷)、Cloudflare(漏洞 harness 的起点 skill)、Anthropic(金融行业 agent 工具箱)——三家本周都在把内部跑过的工具直接开源。这比「实验室 demo 开源」更有说服力:它们带着真实使用量(20K+ 内部用户 / 3M+ 任务)、真实评测集(AACR-Bench 1,505 条人工标注)和真实的人机边界说明(金融 agent 每个输出都要人工签字)。
观察三:星标口径要小心——周榜里混着「老仓库」
claude-code 总星 148,351、ECC 总星 268,434、next.js 总星 142,803,它们和新项目同处一张榜。「一周新增星标」衡量的是注意力增量,「总星标」衡量的是历史积累,两者混读会得出完全相反的结论(例如「ECC 比 hindsight 火 7 倍」)。这一周建议只看周星增量,再单独看总星作为「成熟度」参考。
数据来源:github.com/trending?since=weekly(抓取 2026-09-28 09:15 北京时间)· GitHub REST API(总星标 / 语言 / 许可证 / 创建时间)。
图片出处:封面、TOP 10 柱状图、六层基础设施图、三个判断图由 UU AI Hub 自制(数据取自上方两个来源);LongMemEval 成绩图取自 vectorize-io/hindsight 仓库 README;Orca 界面截图取自 stablyai/orca 仓库 README;Open Code Review 亮点与 AACR-Bench 排行榜取自 alibaba/open-code-review 仓库 README。所有图片已下载到本站本地,未使用外链。


