一句话总结
10 月 17 日,DeepSeek 把 V4.1-Flash 升级到 1017 快照:MIT 许可开源权重,编码与 Agent 基准全面跃升——DeepSWE v1.1 从 74.2 提到 77.0,反超 Claude Opus 5 的 74.0,同时首次把自研搜索引擎开放给开发者(Search/Fetch API)。API 名称(
deepseek-flash)与定价不变,已同步上线官网、App 与 API。这不是一次「换个数字」的例行更新,而是「开源权重 + 搜索基础设施」两件事一起开闸。
数据来源
本文事实依据来自:
- DeepSeek 官方 API 变更日志《Change Log》(api-docs.deepseek.com/updates,2026-10-17)
- DeepSeek 官方《Search & Fetch 指南》(api-docs.deepseek.com/guides/search)
- Hugging Face 模型卡
deepseek-ai/DeepSeek-V4.1-Flash-1017(MIT 许可、参数规模、推荐调用参数) - 第三方报道与评测:MarkTechPost、The Decoder、Teck Hustlers、ByteIota、Reddit r/huggingface 汇总
10 月 17 日发生了什么
DeepSeek 在 API 变更日志里宣布两件事,放在同一天:
- 模型升级:V4.1-Flash 升级为 DeepSeek-V4.1-Flash-1017,官网与 App 的模型同步换新,API 调用方式与定价不变——继续用
deepseek-flash即可。 - 搜索 API 开放:把驱动 DeepSeek 官网搜索的自研搜索引擎开放给开发者,提供 Search 与 Fetch 两个能力。
官方对模型的定性是「性能—成本 Pareto 改进」:同样的钱买到更强能力,或同样的能力花更少的钱;同时在多个基准上降低了任务运行时长与输出长度。
基准跃升:1017 相比 9 月版涨了多少
DeepSeek 官方给出了 1017 快照相对 9 月版(V4.1-Flash)的逐项提升。下面是关键增量:
| 基准 | 9 月版 | 1017 | 变化 |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| HLE(无工具) | 36.8 | 42.6 | +5.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| BabyVision(带工具) | 89.6 | 92.5 | +2.9 |
涨幅最大的是 Terminal-Bench 4.0(+11.1)和 ProgramBench(+8.8)——这两个都是「用终端/写代码完成真实任务」的 Agent 基准,正好对应官方这次主打的「优化了 DeepSeek Harness、Tencent CodeBuddy、WorkBuddy 等平台」。
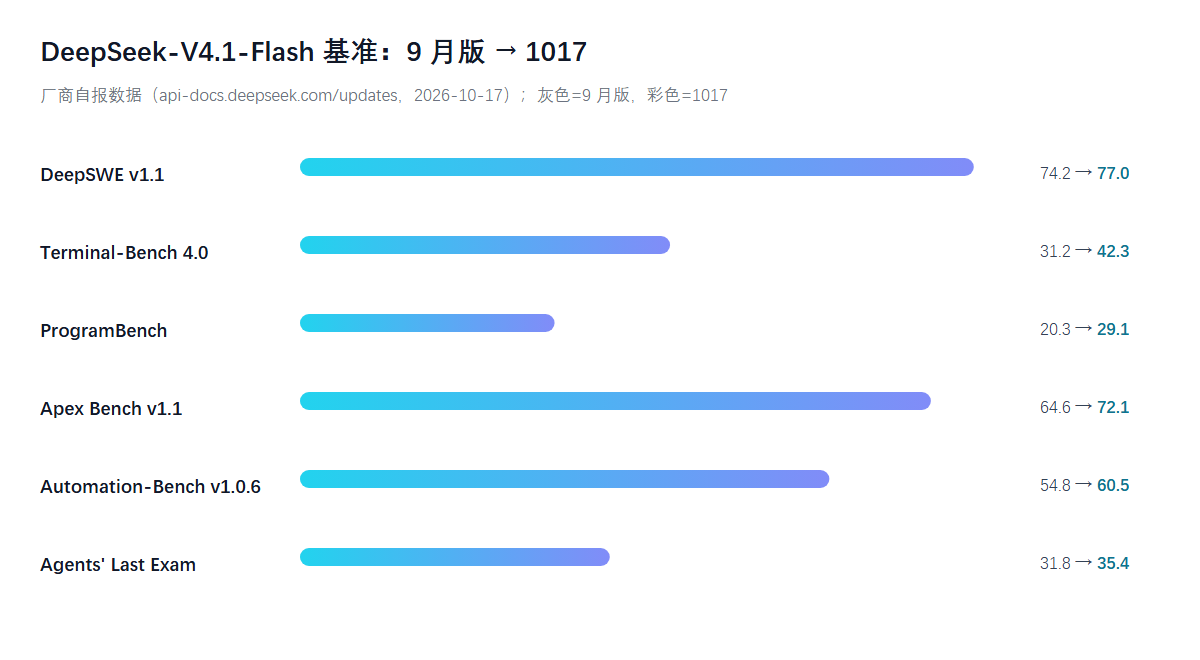
图:UU AI Hub 依据 DeepSeek 官方变更日志数据自制的基准对比(灰色 = 9 月版,彩色 = 1017)
跟闭源旗舰比,1017 在 DeepSWE v1.1(77.0 vs Opus 5 的 74.0)、Automation-Bench(60.5 vs 50.3)、Agents’ Last Exam(35.4 vs 28.6)上反超了 Claude Opus 5;但在 HLE(42.6 vs 56.3)、Terminal-Bench 4.0(42.3 vs 51.8)、ProgramBench(29.1 vs 37.0)上仍落后。结论是「开源模型在 Agent 实操类基准上第一次咬住了旗舰,但不是全面碾压」。
搜索 API:DeepSeek 第一次把「搜索」变成基础设施
这是本次发布里比模型更值得关注的一件事。DeepSeek 的搜索能力此前只藏在官网与 App 里,这次以 API 形式开放:
- 能力:AI-native 通用搜索引擎,官方称索引了数千亿网页,支持多语言,实时返回结果,并内置反 SEO 垃圾、反 GEO 操纵、反低质量 AIGC 的检测机制。
- 两个接口:
Search(搜索)与Fetch(抓取指定 URL 正文)。 - 定价:0.75 美元 / 1000 次成功请求,单账户限流 5 QPS。
- 限时免费:2026 年 11 月 1 日前,经由 DeepSeek Harness、Claude Code、Codex 发起的调用免费。
对一个「Agent 需要实时联网查资料」的场景,这条 API 的意义在于:你不再需要自己搭搜索 + 反爬 + 正文提取一条龙,DeepSeek 直接把搜索做成按次计费的基础设施,而且和它的模型生态(Harness)打通了。
成本:为什么官方说是「Pareto 改进」
官方没有直接列新价格(因为价格没变),而是强调「输出更短 + 运行更快」带来的实际降本。第三方 The Decoder 把官方成本图换算成了数字:在 DeepSWE 上,1017 达到 77.0% 平均每任务不到 0.20 美元,低档位约 72% 对应约 0.10 美元;而 9 月版在 74.2% 时约 0.50 美元。同一张图上,几个闭源旗舰的单任务成本在 2 美元到 10 美元以上。
「输出变短」为什么省钱:Agent 循环里模型反复生成长回复,token 是按输出计费的;同样的任务少吐 30% 的字,账单就少 30%。这是模型层直接作用于成本的一次优化,而不是又一轮降价。
开源权重的现实门槛
权重在 Hugging Face 与 ModelScope 同步开放,MIT 许可(可商用、可修改、可再分发)。但「开源」不等于「人人能跑」:
- 规模:Hugging Face 模型卡标注总参数约 763B(骨干 552B,含 embedding/engram 表的完整口径),48 个 FP8 safetensors 分片,检查点约 510 GB。
- 推理硬件:社区实测需要 48 × 80GB GPU(或一台 8×H200 节点)才能自托管完整权重,是云基础设施级别,不是个人电脑能跑的东西。
所以对绝大多数人,1017 的「开源」价值不是「本地部署」,而是可微调、可审计、可托管在自有集群,以及喂给 vLLM/SGLang 这类推理框架做私有化服务。
该不该切过去
- 已经在用
deepseek-flash的人:不用做任何事,API 已经指向 1017;旧模型名deepseek-v4-flash、deepseek-v4-flash-vision-exp仍兼容路由到新模型。 - 做编码 Agent、终端 Agent 的人:这是本月最值得测试的开源发布——DeepSWE、Terminal-Bench、Automation-Bench 的涨幅都在「真实任务完成率」这个维度上,而非纸面问答分。
- 需要联网搜索的 Agent 开发者:搜索 API 的限时免费窗口(到 11 月 1 日)值得先接入验证效果。
- 想等独立基准的人:厂商自报分数还没被 Artificial Analysis 等第三方复现,把现有模型彻底换掉之前,等一周独立评测更稳妥。
图片出处:封面由 UU AI Hub 自制;基准对比图由 UU AI Hub 依据 DeepSeek 官方变更日志数据自制。


