一句话总结
在第 18 届金砖峰会上,中国把「开源」正式搬上了多边舞台:提出建立金砖 AI 开源社区,用开放权重 + 联合培训 + 共享生态,给全球南方国家提供一条不完全依赖美国闭源模型的路线。
数据来源:中国外交部与新华社 2026 年 9 月 13 日发布的习近平在第 18 届金砖峰会第二阶段讲话全文;Euronews 2026-09-14;Hindustan Times 2026-09-14 分析报道。
发生了什么:五项倡议,第一项就是 AI
2026 年 9 月 12—13 日,第 18 届金砖国家峰会在新德里举行。在峰会第二阶段的讲话中,习近平围绕”夯实金砖合作基础”提出五项倡议,其中排在第一位的直接指向人工智能。
官方讲话原文的表述是:
“第一,开源包容的 AI 倡议。中国将率先建立金砖 AI 开源社区,支持大模型开发与应用合作,举办 AI 专题研讨与培训课程,构建开放的 AI 生态。”
同时,他还呼吁建立”广泛、基于共识的全球 AI 治理框架”。
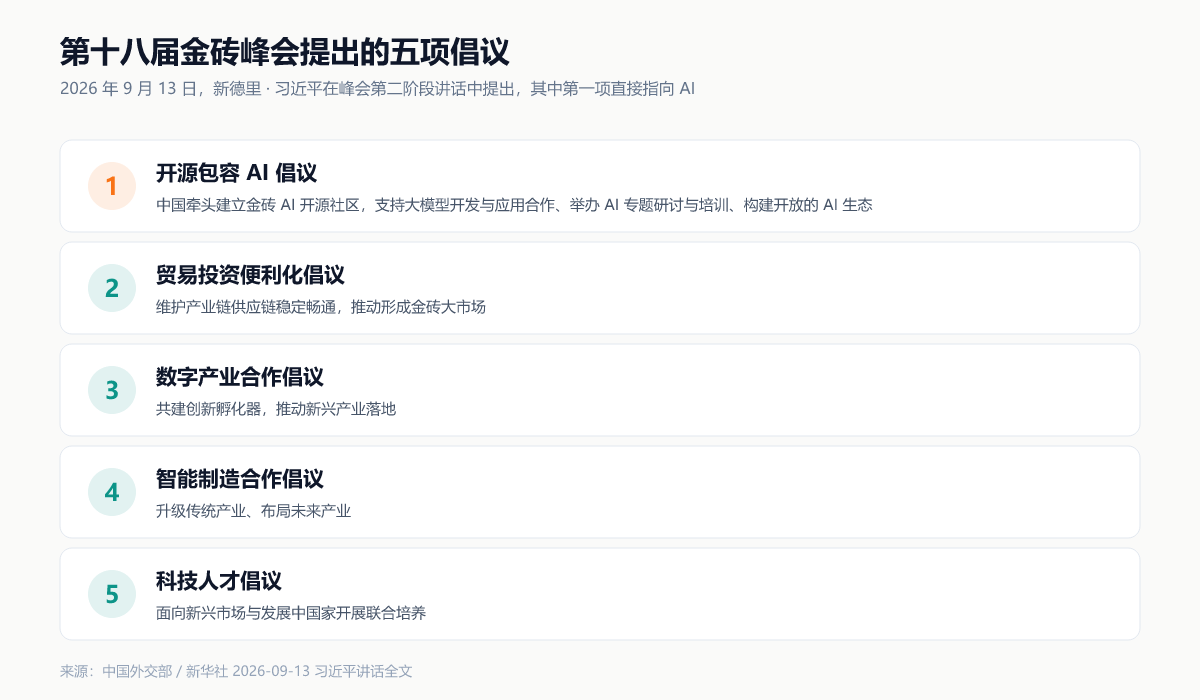
注意这五项倡议的排序很有意思:AI 开源被放在贸易投资便利化、数字产业合作、智能制造合作、科技人才之前。在官方话语里,AI 开源不是一个技术话题,而是产业链与市场入口级的基础设施。
拆开看:金砖 AI 开源社区到底指什么
目前官方只给了方向,没有给细则。从讲话原文可以确定的是四个动作词:
- 建立社区——中国”率先”建立,意味着牵头方与主要出资方是中国
- 支持大模型开发与应用合作——不是单方面输出模型,而是合作开发与应用
- 举办 AI 专题研讨与培训课程——对应的是人才与能力建设
- 构建开放的 AI 生态——生态,而不是单一模型
它并非从零起步。此前中国已发起世界人工智能合作组织(World AI Cooperation Organisation),参与国约 30 个,目标是”为国内外用户提供比美国技术成本更低的替代方案”。金砖 AI 开源社区可以看作这条路线在多边机制上的进一步放大:金砖本身是 11 国机制,但叙事覆盖的是一直被称为”全球南方”的更大范围。
据 Hindustan Times 的梳理,中方目标是”建立一个为国内和国际用户提供美国技术低成本替代方案的 AI 生态”,而”这一路线与美国主要开发商(如 OpenAI、Anthropic)的闭源模式形成对比”。
为什么是”开源”这张牌
要理解这张牌的份量,得先看两条路线的现实差异。
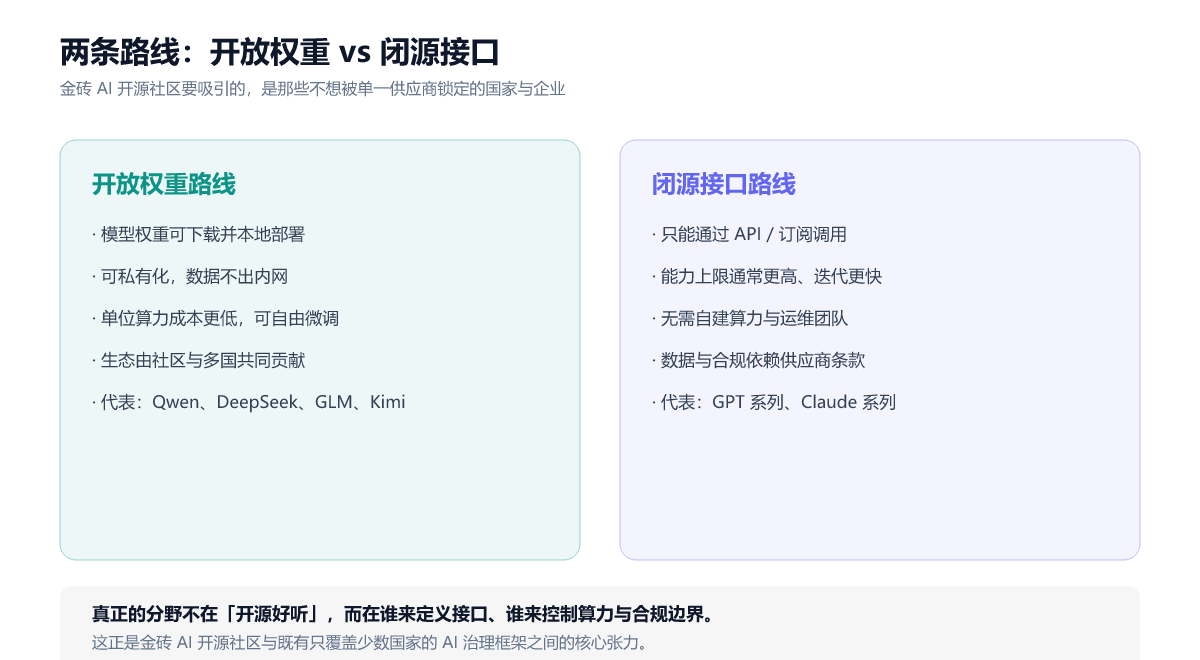
闭源路线的优势很明确:能力上限通常更高、迭代更快、不需要自建算力团队。但对希望掌握自主权的国家与企业来说,它的代价同样明确——数据与合规依赖供应商条款,能力上限与调用条件由别人决定。
开放权重路线提供的正是另一种权衡:模型可下载、可本地部署、可私有化、可自由微调。它不是”能力更强”,而是”约束更少”。
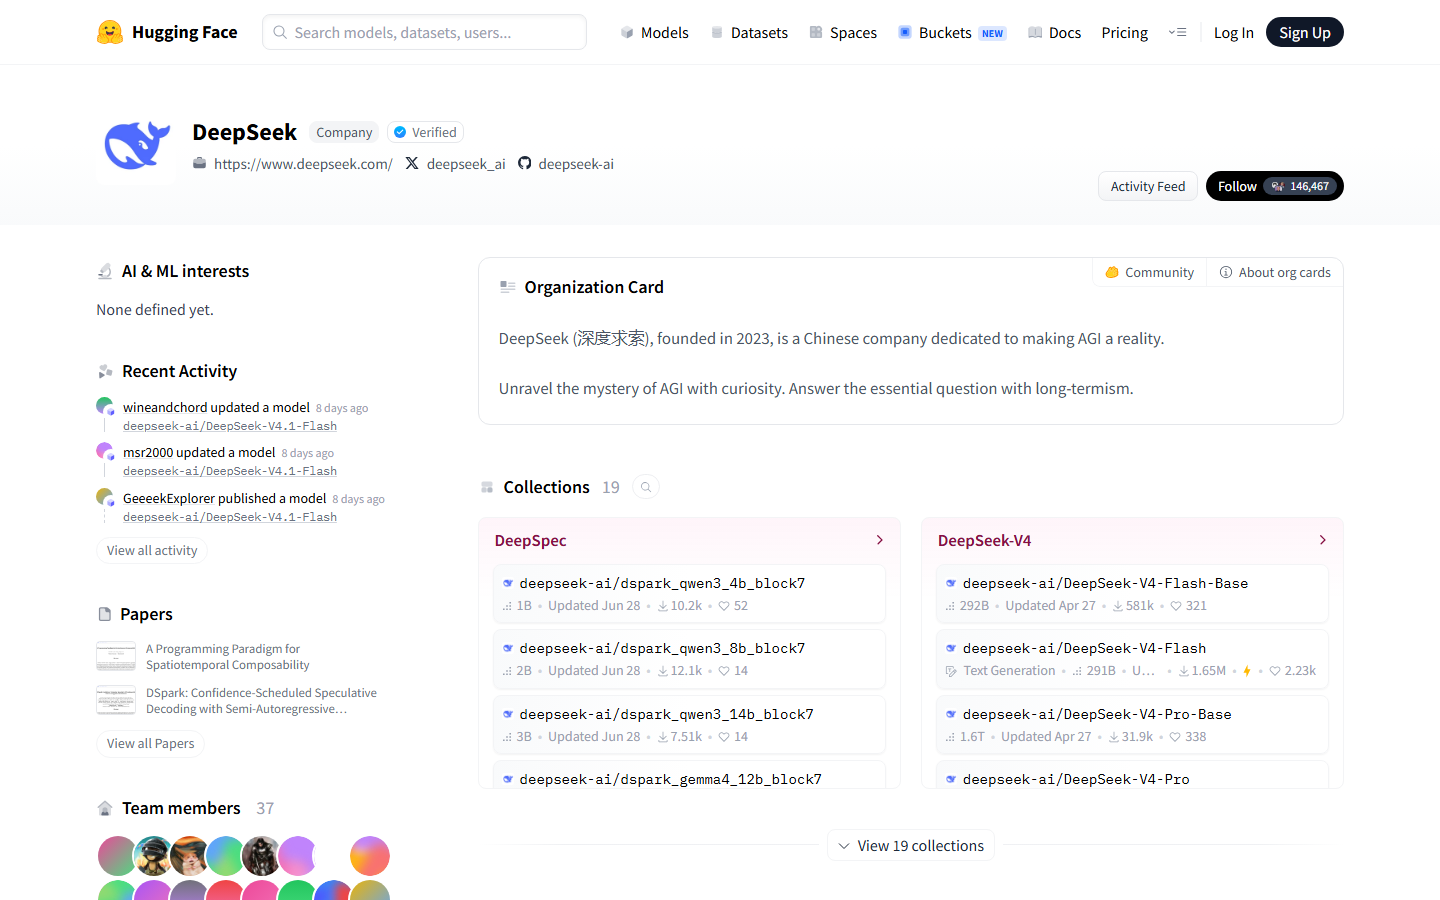
而中国厂商在这一侧已经积累了相当的现实规模。以下两张页面截图拍摄于 2026 年 9 月 18 日:
DeepSeek 官方 Hugging Face 组织页,关注者 146,467 人,公开模型包括 DeepSeek-V4-Pro、DeepSeek-V4-Flash、DeepSeek-V4-Flash-Base 等。
Qwen(阿里云通义千问)官方 Hugging Face 组织页,关注者 104,937 人,公开模型包括 Qwen3.8-2.4T-A95B、Qwen3.8-27B、Qwen3.8-Flash-Next 等。
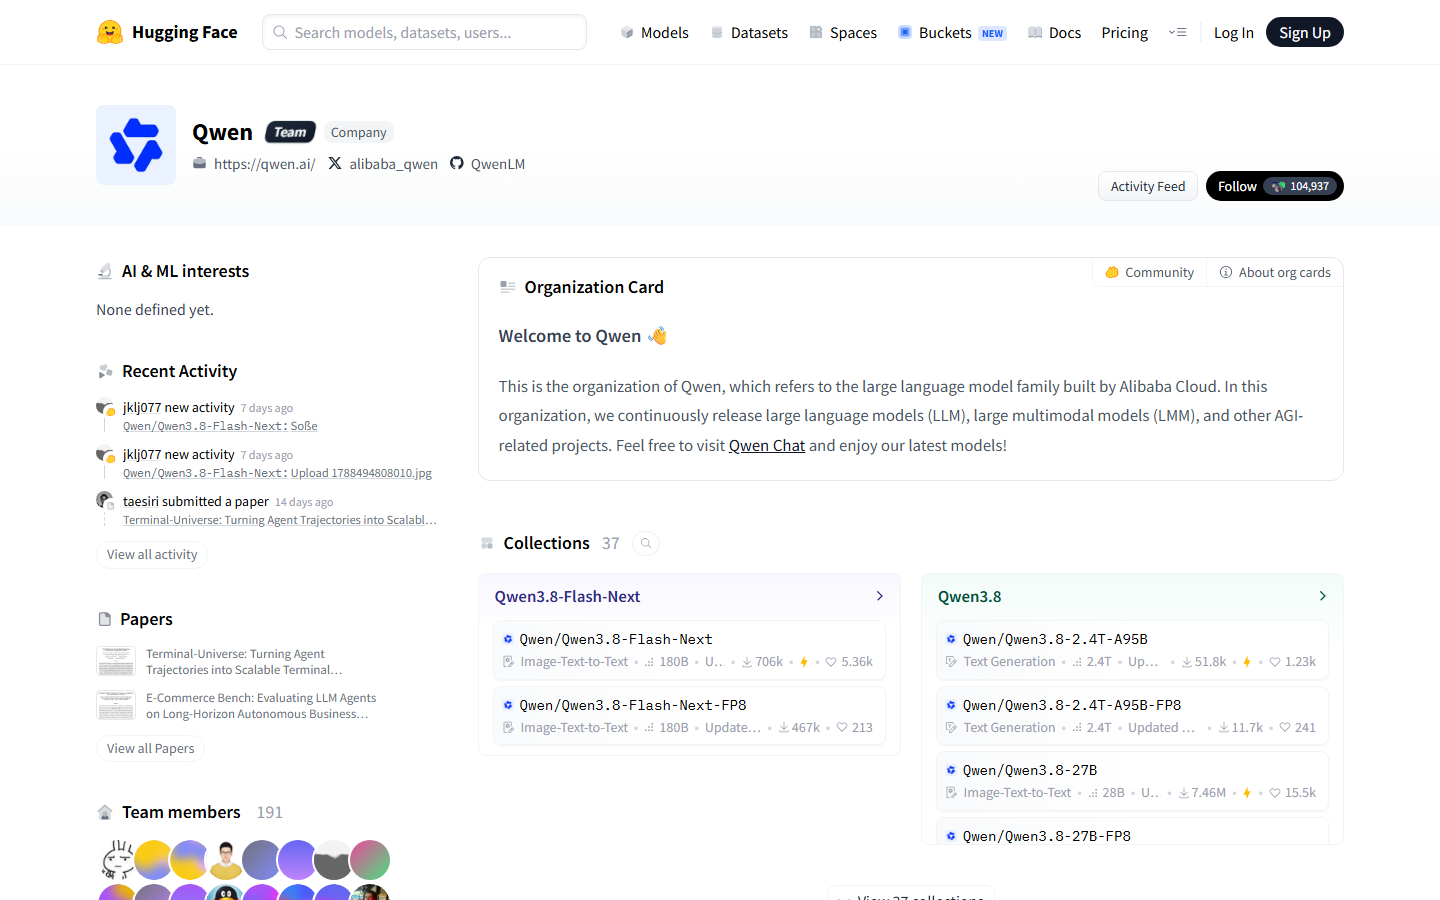
换句话说,“开源”对中国 AI 出海来说不是姿态,而是已经跑通的渠道。 权重先开放、生态先铺开、开发者先用起来——金砖 AI 开源社区要做的是把这条已经有实绩的路径,装进一个多边框架里。
时间线:从区域组织到多边舞台
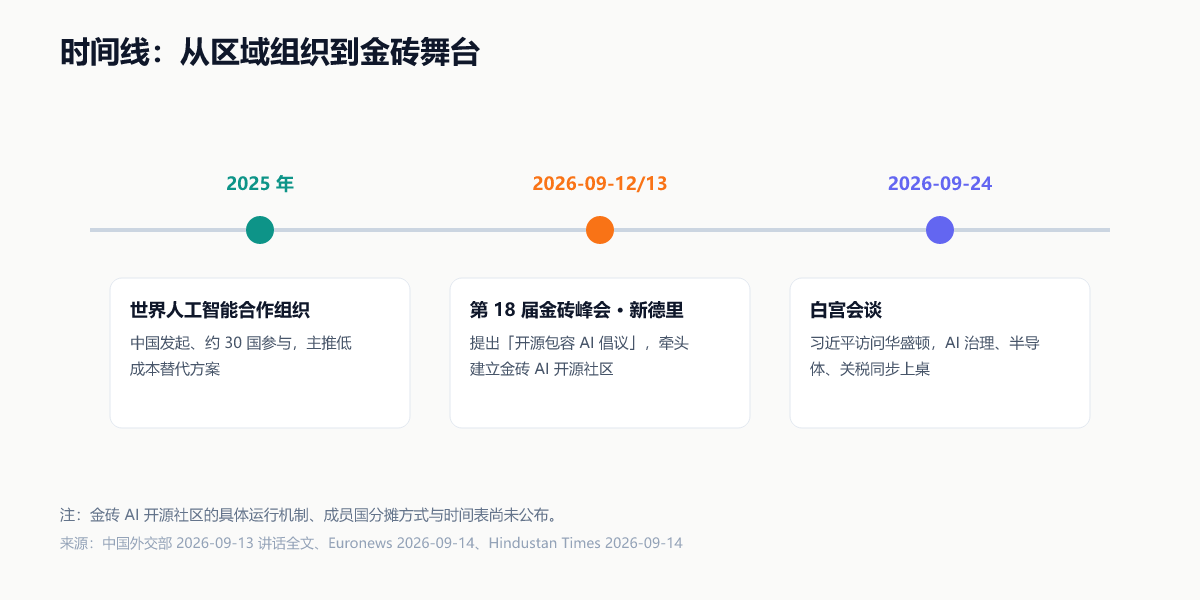
这条时间线上最值得盯的是第三个节点:习近平将于 2026 年 9 月 24 日访问华盛顿,议程包括 AI 治理、半导体与关税。新德里的这条倡议会不会出现在白宫的会谈桌上,会决定它究竟是一个战略开口,还是仅仅停留在峰会公报里的一行字。
真正难的地方:印度要面对的选择
这次峰会的东道主是印度,而印度在 AI 治理上的立场,恰好是这个倡议最尖锐的对照。
2026 年 2 月,印度与法国在新德里举办的 AI 影响峰会上提出了所谓”第三条路”,三根支柱是:摆脱少数科技强权的战略自主、根植于民主价值与人权的原则、基于开放获取基础设施与隐私保护数据共享的协作生态。
把中国的提议和这三根支柱对照,Hindustan Times 的分析指出了其中的张力:
- 第一根柱子(协作生态):中国提议的共享算力、共享基础模型、联合培训课程与跨国研究协作,形态上与印度想要的几乎一致——这确实完成了印度想做的一部分事。
- 但战略自主上是个问题:印度提出第三条路,本意是不必依赖任何一小撮主导力量。加入一个中国主导的社区,意味着把对美国的依赖换成对中国的依赖——即使后者的集中度低得多,模型的训练来源同样不透明。
- 第三根柱子(共享原则):这是最硬的一条。中国的 AI 治理要求境内运行的模型对齐国家目标,且内容规则不分开源闭源,一律适用。印度在巴黎与新德里签署的是安全、可靠、透明的标准,与牵头方本土的监管逻辑并不是一套规格。
所以印度面前其实是一道不太能拖的选择题:接受社区、接受原则上的缺口;或者守住原则、留在外面。截至分析文章发稿,新德里尚未就该提议正式表态。
还需要回答的问题
把已公布的信息和未公布的信息分开看,清单会更清楚:
已经明确
- 中国将牵头建立金砖 AI 开源社区(讲话原文)
- 支持大模型开发与应用合作,举办 AI 专题研讨与培训课程
- 呼吁建立广泛、基于共识的全球 AI 治理框架
尚未公布
- 社区由哪些国家参与、如何加入、是否有准入门槛
- 算力从哪来、如何分摊成本、是否需要共建数据中心
- 共享的”基础模型”具体是哪些、以什么许可协议开放
- 训练数据来源与内容合规如何处理——尤其当参与国监管标准不一致时
- 与既有多边机制(世界人工智能合作组织、联合国框架下的 AI 治理讨论)的关系
换句话说:方向已经给足,机制完全留白。 这也是判断后续进展时最该盯的地方——真正决定这个社区分量的是细则,不是宣言。
对普通用户和开发者意味着什么
抛开地缘层面的讨论,这件事对实际做事的人至少有四条现实含义:
1. 开源权重的”官方背书”变多了。 当一个多边机制把开放生态写进正式倡议,选择开放权重模型的政治与合规顾虑会下降。对企业来说,私有化部署这条路的阻力会小一些。
2. 多语言与本地化会更快。 “支持大模型开发与应用合作” + “专题研讨与培训课程”,指向的通常就是针对参与国语言与场景的适配。对非英语市场的开发者,这往往意味着更多可用的本地化基础模型。
3. 成本选项会更多。 讲话明确的目标是提供低成本替代方案。对预算敏感的团队,这通常直接体现在 API 价格与自托管成本上。
4. 但合规判断不能外包给”开源”两个字。 开源只解决权重可得性,不解决你所在司法辖区对数据、内容与模型来源的要求。选型时真正要逐条核对的是许可协议、训练数据来源、以及你部署地的监管规则,三者缺一不可。
总结
- 第 18 届金砖峰会上,中国提出五项倡议,第一项即”开源包容 AI 倡议”,将牵头建立金砖 AI 开源社区。
- 这不是孤立动作:在此之前已有约 30 国的世界人工智能合作组织铺垫,而中国厂商在 Hugging Face 上的开放权重生态已是既成事实。
- 它的真正对手不是某个模型,而是闭源接口所代表的”能力换依赖”模式。
- 关键变数有两个:机制细则什么时候出,以及9 月 24 日华盛顿会谈会不会把它带进中美议程。
- 对开发者而言,最实际的变化是:开放权重这条路的选择会变多、成本可能更低,但合规与许可的逐条核对依然要自己做。
参考来源:中国外交部 2026-09-13 习近平讲话全文、新华社 2026-09-13 通稿;Euronews《China’s Xi Jinping proposes BRICS ‘open-source AI zone’》2026-09-14;Hindustan Times 深度分析 2026-09-14。Hugging Face 组织页截图为 2026-09-18 实拍。


